感觉同一个PLus号,Sub2API统计的更少


我認為 sub2api 計算快取代幣的方式與 new-api 不同
金额的统计,按说应该一样的,输入和输出是固定的
我没记错的话,newapi和sub2pai是不区分输入还是长输入,金额差了一倍呢,也不计算普通还是fast的一倍,最多差了4倍价格差。所以我说金额的显示,其实newapi和sub2pai计算的不准,就是我自己的,做完意识到这个问题,我都临时调整了下的。
有道理,fast的话new-api是默认不透传的,不知道sub2api是啥样的,还有长输入输出的话,逆向出来官方也区分吗
那就看你是怎么逆向的喽,这个分为本地计算和官方,本地那就是自定义,官方那肯定计算区别啦。这就看设计时候,兼容度有多高
New-API支持阶梯价计费了,应该可以解决这个问题
sub2api会计算的吧
之前看到作者merge了pr,不过是简单粗暴金额x2
@liheng @SKDG042
我让codex分析了下newapi和sub2pai计价体系(做晚更新的源代码),和去github看了下
| 第 1 列 | 第 2 列 | 第 3 列 | 第 4 列 |
|---|---|---|---|
| codex官方 | newapi | sub2pai | |
| 长上下文分开计价 | 支持 | 待定 | 可以 |
| 缓存 | 支持 | 有问题 | 可以 |
| fast计价 | 支持 | 有问题 | 有问题 |
上下文问题
newapi 新版本main是没有的 nightly分支有
sub的问题,读取openai官方
缓存问题
newapi 除了模型id匹配缓存问题,它缓存的是摘要缓存,不匹配输入缓存。
sub 读取openai官方
fast问题 个人体验
newapi 单调 priority,造成少计费
sub 单调 priority,造成少计费
这个少计费还没深入研究,也可能是多计费。因为fast我没深入研究是算的请求侧就计费还是响应侧计费,前者多计费,后者少计费。
问题2有个疑问,缓存都是上游返回的,New-API是哪的上游的输入缓存读,这个摘要缓存是从哪里来的,上游应该没有这个字段
这个问题要分成 2 个部分,先说缓存读取。
-
New API 要你自己去设定模型。比如现在的映射是 GPT-5.4,那就得按这个模型走。
如果映射里没有 5.5,后来出了 5.5;或者你没更新,映射还是 5.3,却写了 5.4,那么模型 ID 对不上,缓存就匹配不上,因为本地业务映射没对齐。
除了模型 ID 之外,缓存相关的模型 ID 也要映射上。只要有一项没匹配,就会挂掉。也就是说这两部分硬编码都要对上,否则在未命中的情况下会回退成 1,缓存读取就按普通输入计价,这也就是大家为什么会觉得用 New API 比 Sub 少了很多缓存。 -
再说第二个缓存问题。正常计价应该是输入 + 提示词 + 整个长上下文一起算,但现在看起来像是只计算了摘要缓存,没有计算输入。
至于 Codex 的摘要缓存,我没深入去扒一下:它的摘要缓存可能是官方缓存,也可能是思考摘要层级的缓存。因为 Codex 的思考不会完全给你,它只给你一个思考摘要,所以很有可能缓存的是思考部分,你这个场景就不一样了呀。
然后 New API 现在的主分支很多时候用的是本地字段,看起来没有完全对接上。OpenAI 这块我也没太深入去扒,毕竟真的很消耗 token, 所以我只是简单查了查,看了下 GitHub 最新版本说明,顺手看了部分代码。
OpenAI的接口会返回一个usage字段,里面有普通输入、缓存读、输出,官方接口不会返回摘要缓存读这个参数,这个是不是自建缓存的的时候才有这个,就是中转用redis自建缓存时会有这个摘要缓存读


是不是中转给缓存造假了,修改了usage里的输入输出参数,这个可以修改 
首先,你得设置好模型id和缓存id
其次,你设置好了也没屌用,因为大家都在用main版本,鬼知道newapi 四月多时候偷偷开了个分支支持了分段计费和fast参数覆盖,就参数还错了。而且就发了这一个版本,十多天都没更新,谁会把main切到分支啊,不切,那就完全不支持,主main就没实现啊!
sub我看了下,它像你说的那样,是对齐了openai的,所以大家用sub时候发现sub的缓存很高,就是这样
不是你们说,我临时查,我都不知道newapi支持了,偷偷单独发了个分支版本qaq
我原本想着要不去用中转站吧,最近封号封得挺狠。然后我去用了一下中转站,才发现问题太多,所以觉得还是自给自足吧。
如果照着它这么用下去,价格逆天,真的太高了。哪怕几天封一次号,我拼着用都能给赚回来。
这种价格谁用得起啊?你现在都不说,反而偷偷调倍率,也不透明;你改价格、改分组价格。就光它这块缓存我都玩不起,扣得太快,token 吃得也太狠。你要是没有高缓存,根本玩不动,价格差了 10 倍。
说实话,现在 fast 模式挺难。无论是:
- 站里
- 中转站
- 开源项目
我都看过了。
绝大多数人最多也就是把优先级参数往上调一下,但这块到底有没有明确的 fast 识别,官方也说得含糊。
所以我不太信大多数中转站或者开源项目能把 fast 模式这块功能做好,计费也做到标准。
这种情况下就两种可能:
- 多算钱;
- 少算钱。
你猜中转站会选哪种?我个人偏向前者,因为走后者的话就很亏。
最后我放弃了,自己搞一个自己用的东西,然后买了 Pro.
Pro 的 20X 能用一天算一天,照这样下去,只要能用几天,我都能把它给撸回来。
总比去用中转站那种坑的好。


刚分析的 main没做,分支版本做了,你得版本对啊。等级透传也不是fast透传啊是prio
newapi我前段时间用,还有个本地缓存系统,我没深入研究,好乱的。
你这是main还是分支?138390是输入+缓存还是输入? 前者吧 缓存读 137,856
你这缓存是官方缓存还是开了newapi的本地缓存啊?
我也不知道那个中转站什么鬼,血坑,蛋疼的要命。
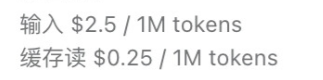
看图像main 这是没升级分段计费呢