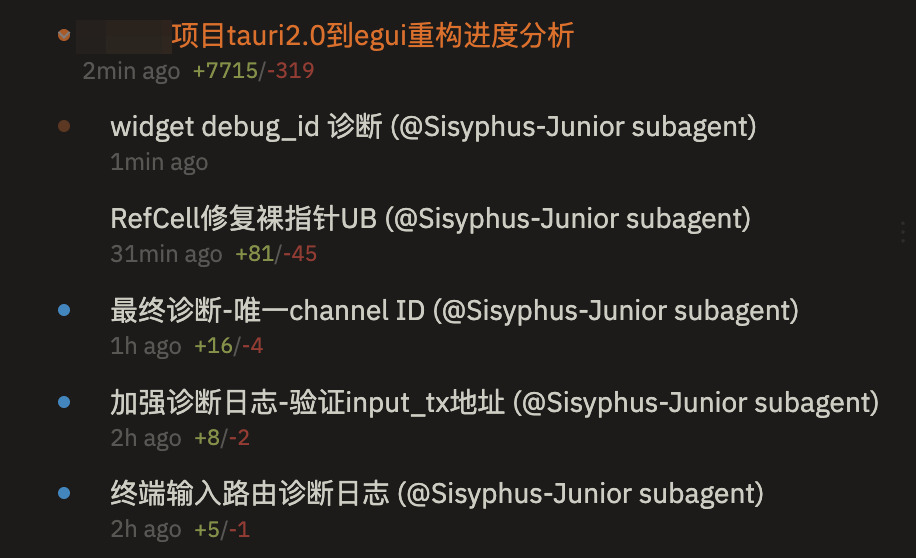
一个重构项目,多终端一直卡着无法debug完成,表现为ABCDE五个终端,所有输入都只会错误的输入到A终端,且经过多轮debug无法解决。
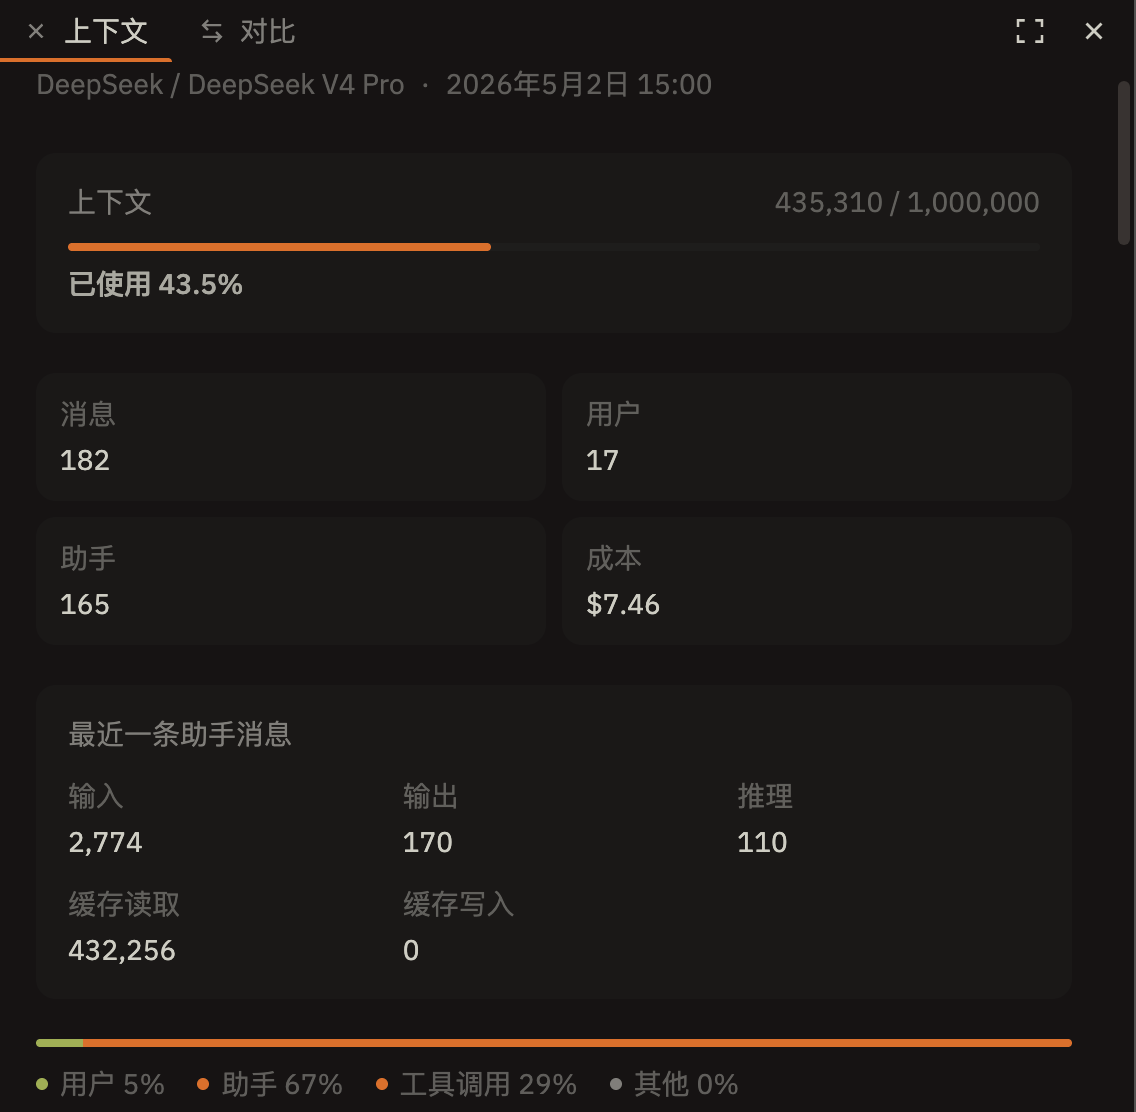
当从300K上下文Debug到400K上下文时,v4 pro max开始每轮对话添加一个小修复和日志埋点让我测试运行。然后加埋点→收集日志→测试运行→加埋点 不断重复。
- OMO所有Agent全部设置为
deepseek-v4-promax思考。 - deepseek-v4-pro渠道为opencode go,应该不存在降智问题。
一个重构项目,多终端一直卡着无法debug完成,表现为ABCDE五个终端,所有输入都只会错误的输入到A终端,且经过多轮debug无法解决。
当从300K上下文Debug到400K上下文时,v4 pro max开始每轮对话添加一个小修复和日志埋点让我测试运行。然后加埋点→收集日志→测试运行→加埋点 不断重复。
deepseek-v4-pro max思考。感觉很正常,最强的闭源模型上下文过长性能也会大打折扣
长上下文和注意力本身就是物理矛盾,想用长上下解决注意力问题,无异于饮鸩止渴啊
加埋点→收集日志→测试运行→加埋点 不断重复
不过,在遇到无法解决的bug的时候,这个流程是没毛病的。信息足够的多之后,有时候就能解出来了
都一样啊,那个最牛的闭源模型也差不多这个大小之后就开始幻觉严重了
他都给你400k了,其实,剩下的有没有效果,问题也不大了,至少这个是实在的
这个价,他就是250k,都没有啥问题
说起来 我还真有一个项目尝试过 用 GPT5.4 从 tauri 直接转到 egui 基本一次就成了 修修补补细节两三次就行了, 然后实际运行之后发现, 内存占用没下来甚至升高了, 反而需要的功能缺失了不少
其实黄金的注意力区间90%能在150K都是超强的大模型了,之后的都是靠压缩检索和商家吹的。
我不太在意内存占用,
主要还是tauri在页面数据量大时会很卡顿,
我这边主要是有一张表格+右键菜单之类的。
但是要求全部显示在同一页面内,且不能进行分页和渐进式。