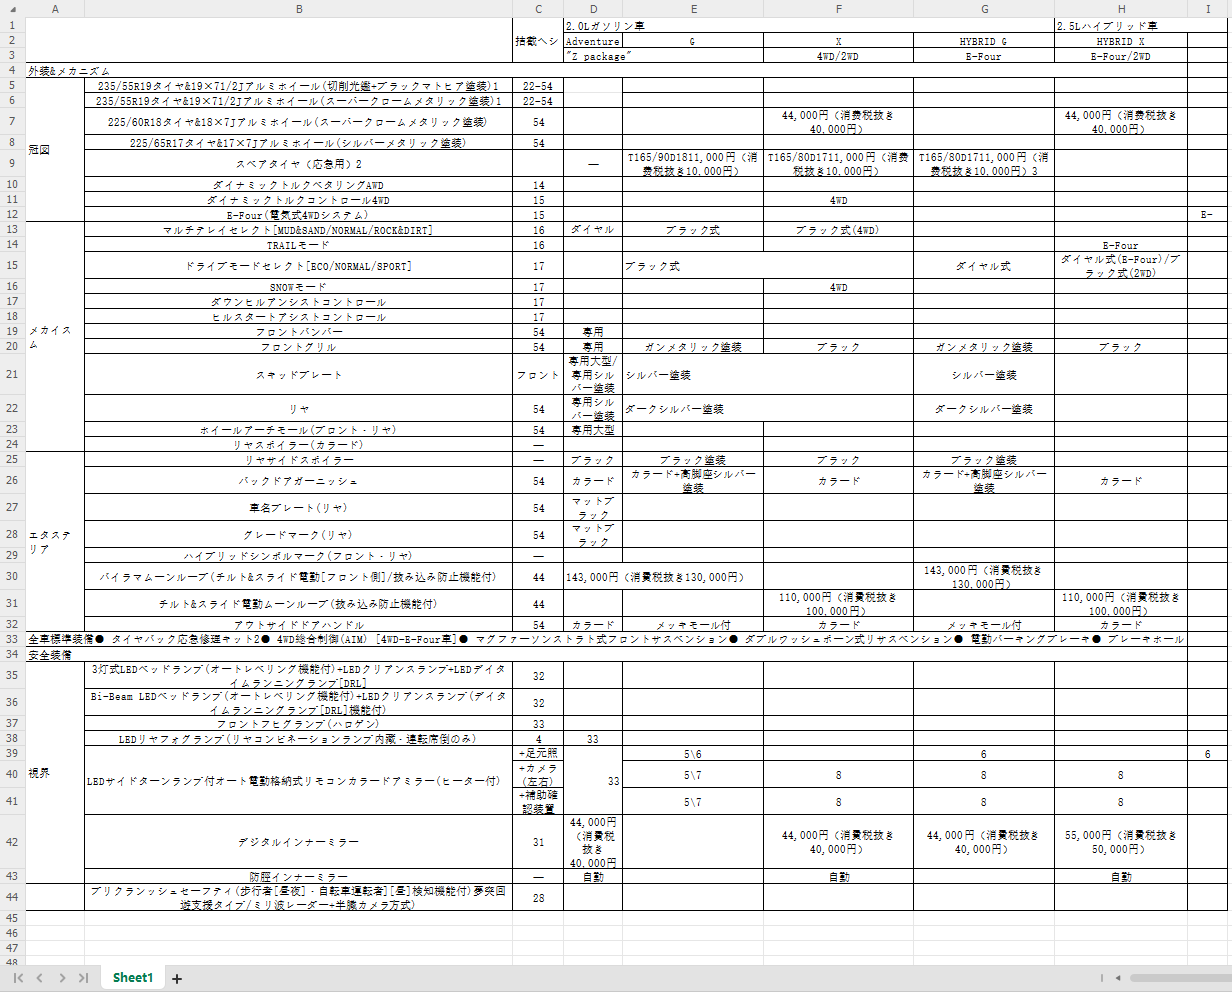
如图所示,我现在的工作是做一个自动化工具将类似于这种复杂表格中的信息按照公司内部的数据结构要求规范的提取出来
我目前的做法是:定义好结构要求,接入Gemini的API去自动识别,但是对于大批量工作,成本偏高,而且准确率不是太好
佬们有没有更好的办法
也可以考虑不用OCR,试试直接让AI读取pdf内部数据
mineru的表格解析挺不错的,也有免费额度的api使用
如果这个PDF没有内部数据,只是单纯的扫描件PDF呢 
好的,佬,我去了解一下看看 
这种pdf扫描件可以试一下用各家的vl模型,然后你把要求的数据字段给模型让它按结构化输出找一个相对准确的vl模型,比如qwen-vl
扫这种数据密集型的"图片",目前Ai错误率还是比较高的,容易出现幻觉,数字提取错误,小数点后弄错等等,不少问题
mineru转换是不是对特殊字符的处理不是特别好用
我用mineru3.0处理论文的表格,有一些复杂程度和你列的差不多,效果还行。但是是英文的,日语行不行不清楚。
前段时间刚好使用过 MinerU 来处理复杂表格,表格数据的返回结果是 html 格式的,虽然能很好的把表格的级联层级完整保留下来,但是似乎不能实现 “按照公司内部的数据结构要求规范的提取出来” 这样的需求。
如果有输出格式要求的话感觉还是得使用版面分析模型 + vl 大模型,先用版面分析模型将 pdf 文档的不同的模块拆出来,再用 vl 大模型分别处理
版面分析可以试一下 RapidLayout,vl 模型看公司实力
感觉佬你说的比较靠谱,尝试一手看看
接楼上佬的回复,确实推荐 MinerU,可以了解使用下。之前做知识库的时候,处理大量复杂表格文档的时候就是靠它,效果还不错~
这种也很好实现,让ai写个python脚本清洗数据,转成json格式。然后再提交公司内部的数据结构,让ai再适配。但是重点是实mineru对于某些复杂表格,比如多个表格合并成一个导致数据错位就很难处理。这种我们目前就是手动分割然后再让mineru解析
感谢佬,MinerU效果确实很好,已经美美接入
数据量不大,不考虑成本的话,可以直接调用千问的视觉模识别,准确率还可以。gemini 更好些
必须chandra,目前体验下来效果最好的
好的,佬,这个我也去试试看

试一下mineru OCR ,我之前做过OCR项目,直接用它的API跑的识别还行