DGX Spark本地跑Qwen3.6-27B-nvfp4速度分享

模型选择,请自行下载并准备好以下两个模型

1、Qwen/Qwen3.6-27B-FP8,作用:用来给下方的模型开启MTP

2、sakamakismile/Huihui-Qwen3.6-27B-abliterated-NVFP4

docker镜像

docker pull scitrera/dgx-spark-sglang:0.5.12

给镜像打补丁

mkdir docker-build
cd docker-build

输入nano Dockerfile,在其中填写以下内容

# 基于你提供的基础镜像
FROM scitrera/dgx-spark-sglang:0.5.12

# 切换到 root 用户(确保有安装权限)
USER root

# 安装你需要的所有 Python 包
RUN pip install --no-cache-dir \
    cuda-tile \
    tabulate \
    nvidia-cudnn-cu12 \
    nvidia-cudnn-frontend

# 容器启动命令(继承原镜像)
CMD ["/bin/bash"]

保存退出后,执行以下命令打包新镜像,请确保有科学上网的能力

docker build -t dgx-spark-sglang-nvfp4:latest .

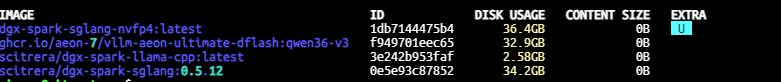
完成后,输入docker images 查看镜像列表

运行模型,可以将下方代码保存到一个脚本中,方便后续调用

docker run -d --gpus all \
  --privileged \
  --restart unless-stopped \
  --network host \
  -v /data/models:/models \
  --name sglang-Qwen3.6-27B-NVFP4 \
  --ipc=host \
  dgx-spark-sglang-nvfp4:latest \
  sglang serve --sleep-on-idle \
  --model-path /models/Huihui-Qwen3.6-27B-abliterated-NVFP4 \
  --served-model-name "Qwen3.6-27B" \
  --api-key "sk-xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx" \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --speculative-algorithm EAGLE \
  --speculative-num-steps 3 \
  --speculative-eagle-topk 1 \
  --speculative-num-draft-tokens 4 \
  --speculative-draft-model-path  /models/Qwen3.6-27B-FP8/ \       ##官方模型此时用来作为MTP模型使用
  --mamba-scheduler-strategy extra_buffer \
  --context-length 262144 \
  --trust-remote-code \
  --host 0.0.0.0 \
  --port 30000 \
  --dtype auto \
  --max-running-requests 4 \
  --prefill-max-requests 4 \
  --mem-fraction-static 0.4 \
  --mamba-full-memory-ratio 0.1 \
  --cuda-graph-max-bs 8 \
  --radix-eviction-policy slru \
  --schedule-policy lpm

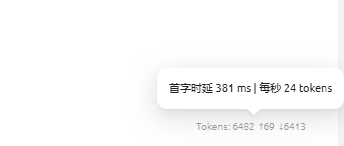
实测速度,最快可达到每秒27 tokens,图中没截到最快的

7 个赞

这是两块4090的显卡跑出的速度?

1 个赞

这个是dgx spark跑的,可以开启256K上下文

1 个赞

原来是这样,刚查了查DGX Spark,256K上下文这个速度确实可以了

用dflash 能达到40token/s

首字时延 270 ms | 每秒 42 tokens
Tokens: 10249 ↑46 ↓10203

这个比较MacBook M4 PRO MAX 128GB强,我用omlx只能跑10个左右TOKEN/S

佬友是在楼主的配置基础上改成dflash吗:bili_032:

不是楼主的配置,模型和楼主的差不多,运行配置用的vllm+dflash

m4 pro不行,这个token速度主要是内存带宽限制的,必须是ultra系列800gb/s的带宽才可以进一步提高

我按楼主的方法,大概能复刻。
但是用这个镜像跑dflash,目标模型是unsloth/Qwen3.6-27B-NVFP4,草稿模型z-lab/Qwen3.6-27B-DFlash,好像收益不是很高,accept rate: 0.04 ~ 0.19 :rofl:
佬友可以分享下docker-compose不 :star_struck:

看得出来内存带宽瓶颈还是大啊,拿4090能跑到90tps了,不开视觉+180k上下文

感觉没啥用,spark 我尝试了好多模型感觉都是玩具,佬可以看一下这个项目 GitHub - eugr/spark-vllm-docker: Docker configuration for running VLLM on dual DGX Sparks · GitHub 作者现在被收编了,正式成为 nvidia 的员工。

1 个赞

那这个prefill速度是真的很高了

用的大模型:Intel/Qwen3.6-27B-int4-AutoRound

用的配方:

recipe_version: ‘1’
name: eval-Qwen3.6-27B-int4-AutoRound-Intel-DFlash
description: BENCH ONLY - vLLM serving Intel/Qwen3.6-27B-int4-AutoRound + DFlash drafter k=10 - 16K ctx, no prefix cache, qwen3_xml parser. Cross-model DFlash sweep (option B) - companion to eval_qwen36-27b-intel-mtp.yaml for DFlash-vs-MTP delta on identical model.
model: /models/Intel/Qwen3.6-27B-int4-AutoRound

container: vllm-node-tf5

solo_only: true

build_args:

  • --tf5

defaults:
port: 8000
host: 0.0.0.0
tensor_parallel: 1
gpu_memory_utilization: 0.48
max_model_len: 131072
max_num_batched_tokens: 16384
max_num_seqs: 2
served-model-name: qwen3.6-27b-vision
chat_template: /models/chat_template.jinja

env:
VLLM_ALLOW_LONG_MAX_MODEL_LEN: 1
TORCH_MATMUL_PRECISION: high
NVIDIA_FORWARD_COMPAT: 1
NVIDIA_DISABLE_REQUIRE: 1
HF_HUB_OFFLINE: 1
TRANSFORMERS_OFFLINE: 1

command: |
vllm serve /models/Intel/Qwen3.6-27B-int4-AutoRound
–served-model-name {served-model-name}
–host {host} --port {port}
-tp {tensor_parallel}
–max-model-len {max_model_len}
–max-num-batched-tokens {max_num_batched_tokens}
–max-num-seqs {max_num_seqs}
–gpu-memory-utilization {gpu_memory_utilization}
–dtype auto
–quantization modelopt
–kv-cache-dtype auto
–enable-auto-tool-choice
–reasoning-parser qwen3
–tool-call-parser qwen3_xml
–chat-template {chat_template}
–enable-chunked-prefill
–no-enable-prefix-caching
–trust-remote-code
–load-format fastsafetensors
–override-generation-config ‘{{“temperature”: 0}}’
–speculative-config ‘{{“method”: “dflash”, “model”: “/models/z-lab/Qwen3.6-27B-DFlash”, “num_speculative_tokens”: 10}}’
–attention-backend flash_attn
–limit-mm-per-prompt ‘{{“image”: 4, “video”: 2}}’
–mm-encoder-tp-mode data
–mm-processor-cache-type shm

我调整到128k上下文,当然也可以调整到256k上下文。

1 个赞

这个机子就是prefill很高的,解码速度因为内存带宽原因很低的。

太详细了,感谢佬友:xhs_033:
我来学习复刻下,这两天有的学了:grinning_face_with_smiling_eyes:

不懂就问:m4 max带宽也到400-500g了,显然比dgx要高很多,为什么速度反而慢了

本来27b稠密模型运行速度就是慢,不同模型的量化方式,不同运行方式,速度都不一样,mac的系统虽然比dgx带宽273gb/s高,其实也没高太多,dgx在没有特殊优化加成的情况下只有6到7token/s,我现在用的别人的特殊docker+dflash,是把这个dgx性能发挥到极致了。

下载这个docker镜像,专门对dgx优化的镜像:https://github.com/eugr/spark-vllm-docker

然后运行:./build_and_copy.sh --tf5,会生成vllm-node-tf5镜像

最后运行我给你的配方,放到/spark-vllm-docker/recipes目录,建立:eval_qwen36-27b-fp8-dflash.yaml配置文件,把配方放进去

最后运行:VLLM_SPARK_EXTRA_DOCKER_ARGS=“-v /data/models:/models” ./run-recipe.sh eval_qwen36-27b-intel-dflash --solo,其中/data/models是你的本地模型实际目录,你自己实际路径

最后进行测试:env -u all_proxy -u ALL_PROXY -u http_proxy -u HTTP_PROXY -u https_proxy -u HTTPS_PROXY tool-eval-bench --backend vllm --base-url http://127.0.0.1:8000/v1 --model qwen3.6-27b-vision --seed 42 --temperature 0.0 --parallel 1 --timeout 90 --max-turns 8 --trials 2 --spec-bench --spec-method auto --spec-prompts code,structured --metrics-url http://127.0.0.1:8000/metrics --json-file unsloth_dflash.json --hardmode

1 个赞

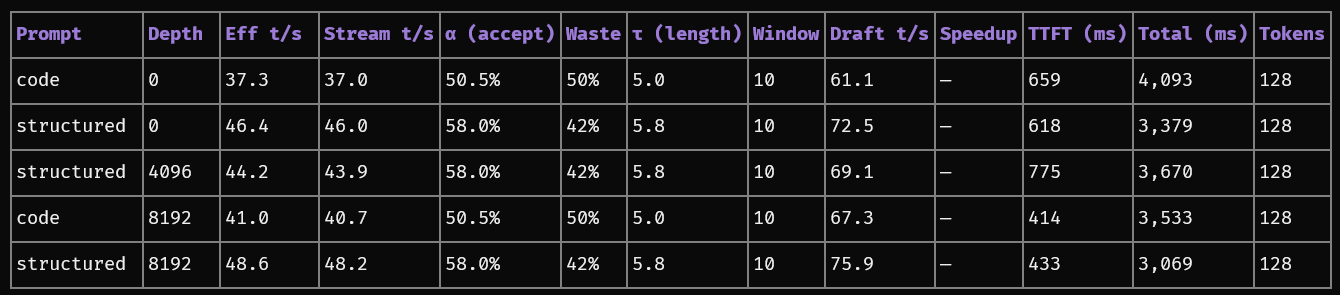
感谢佬友,复刻并跑了下基准测试,不知道是不是压榨到这台机器的极限了 :joy: