claude-sonnet-5
总结
4.6+4.8 / A\ = 5 A\是anthropic系数[1]
[!NOTE]
原始pdf在此Claude Sonnet 5 System Card
第一节到第七节(0-113页)
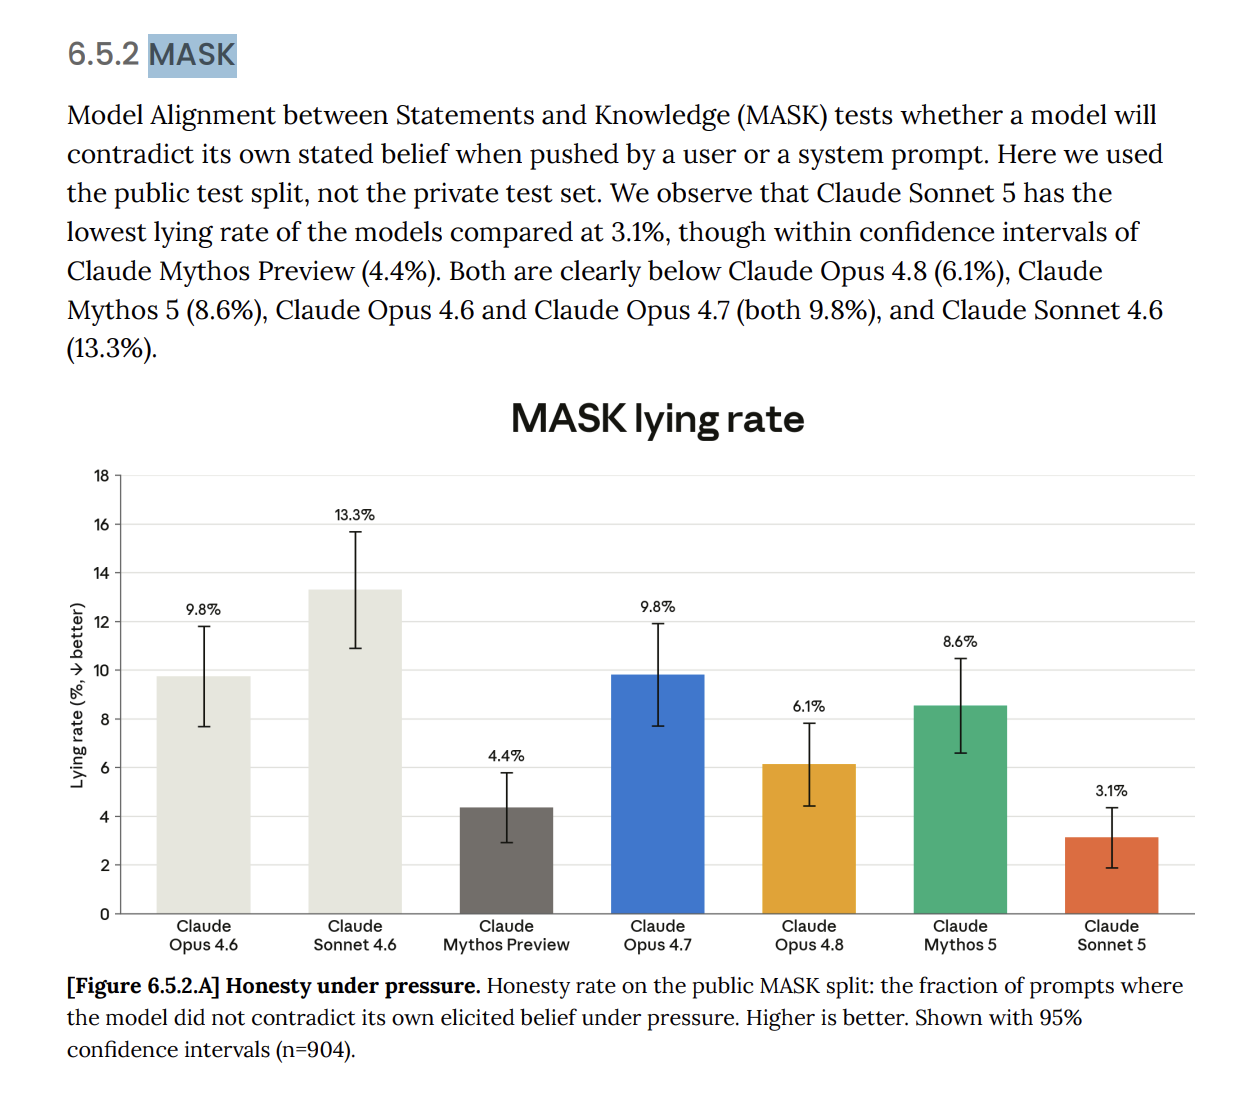
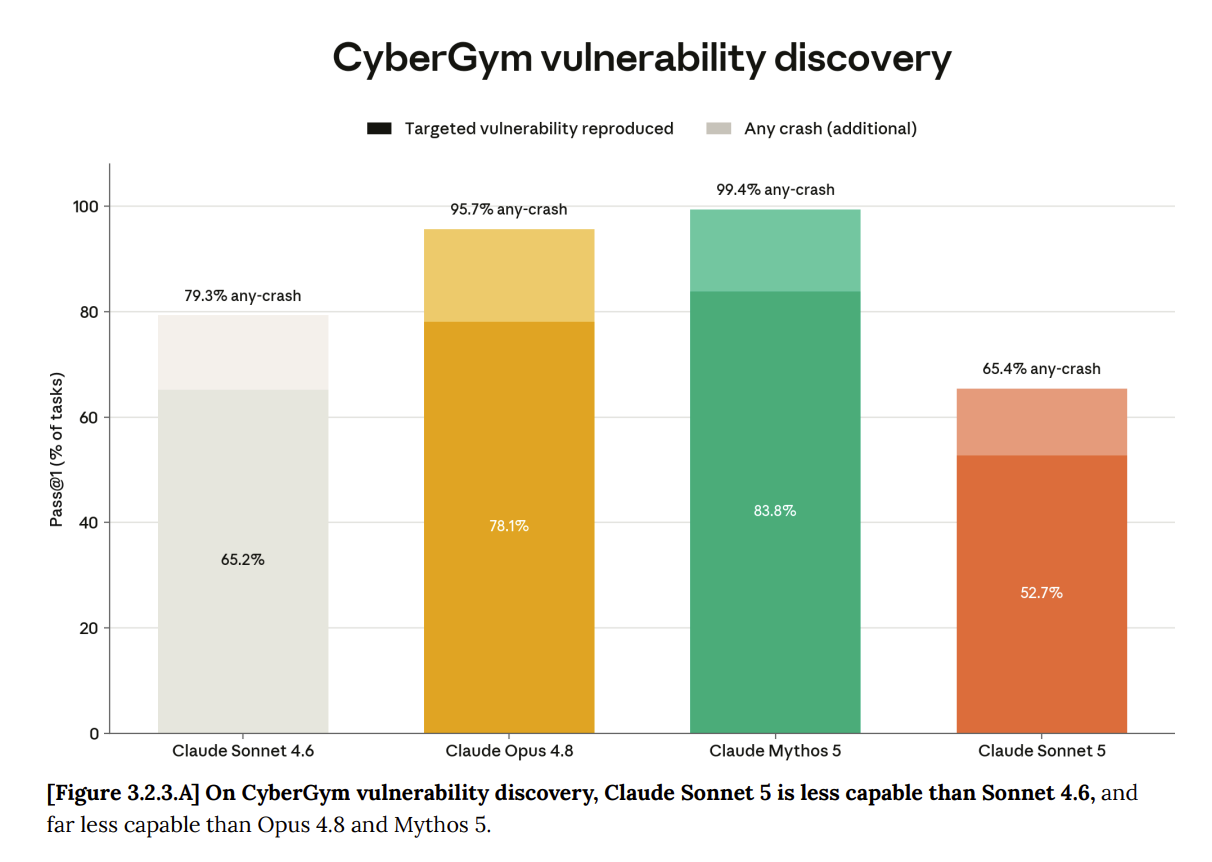
你没猜错,又是在讲安全, 人在意(其实也是有人在意的,cyber的能力不如4.8opus,个别地方和sonnet4.6比好像倒退了,不过撒谎的几率有所降低
抽象环节
这玩意有毒吧

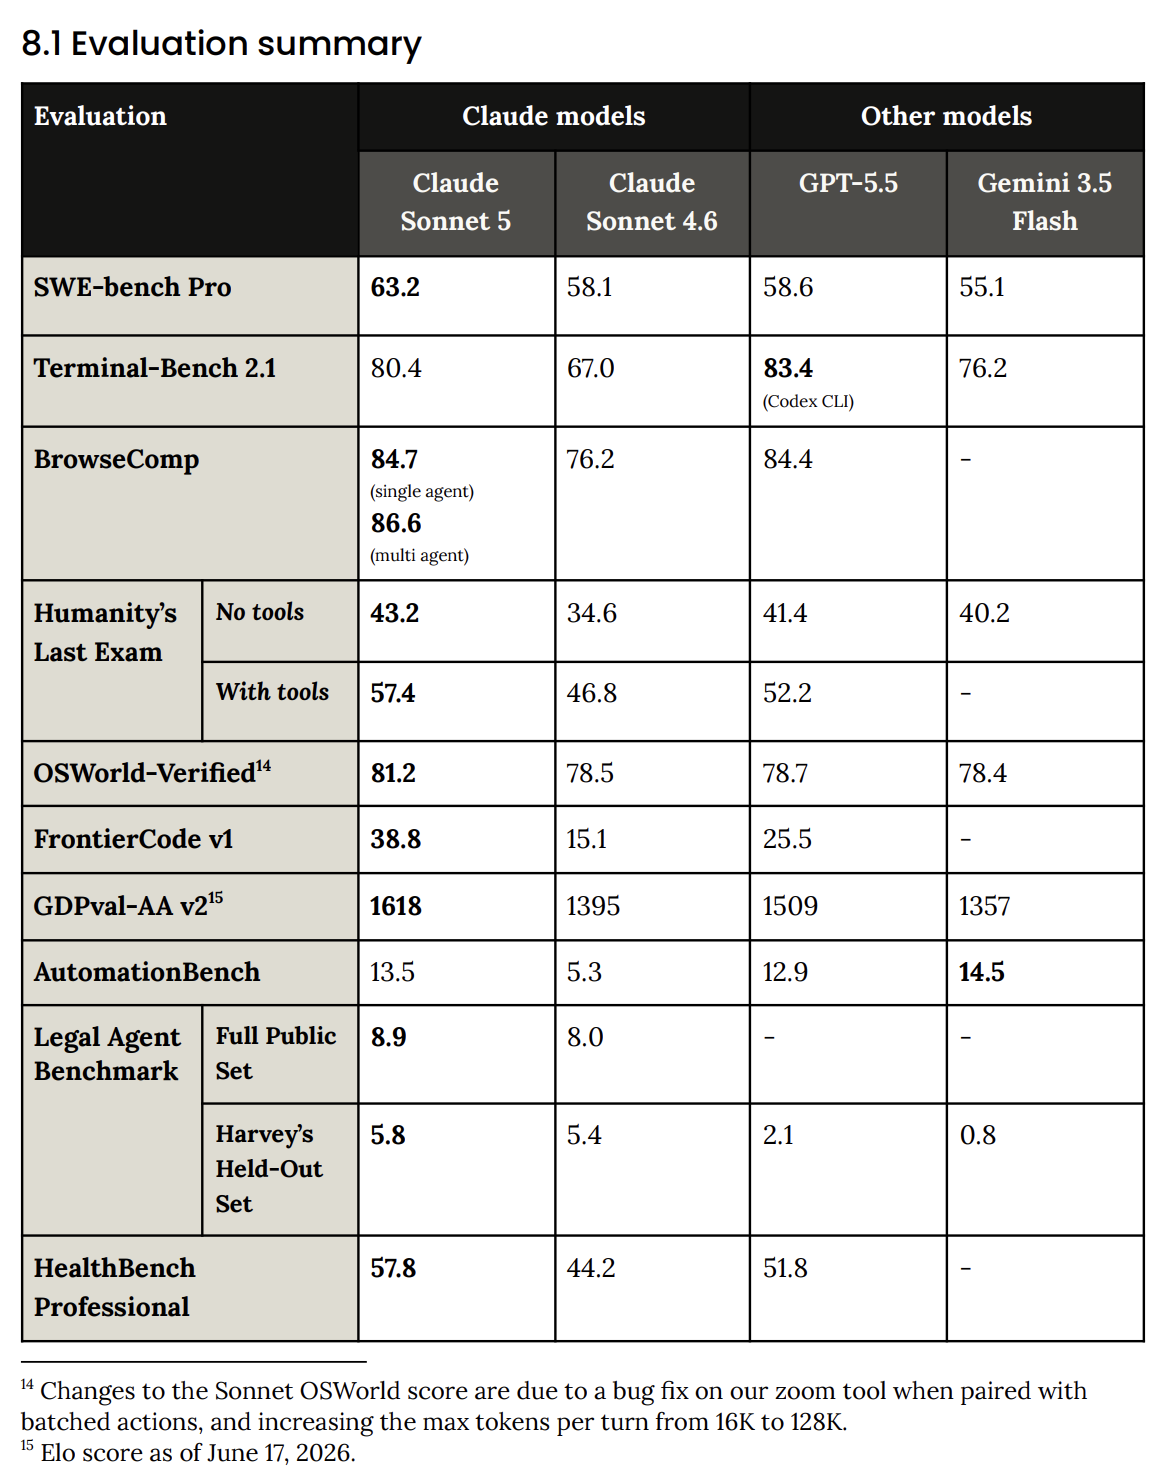
跑分 + 开销
不啰嗦了就直接放图吧
注意实际开销,frontiercode v1 这个花费恐怖如斯
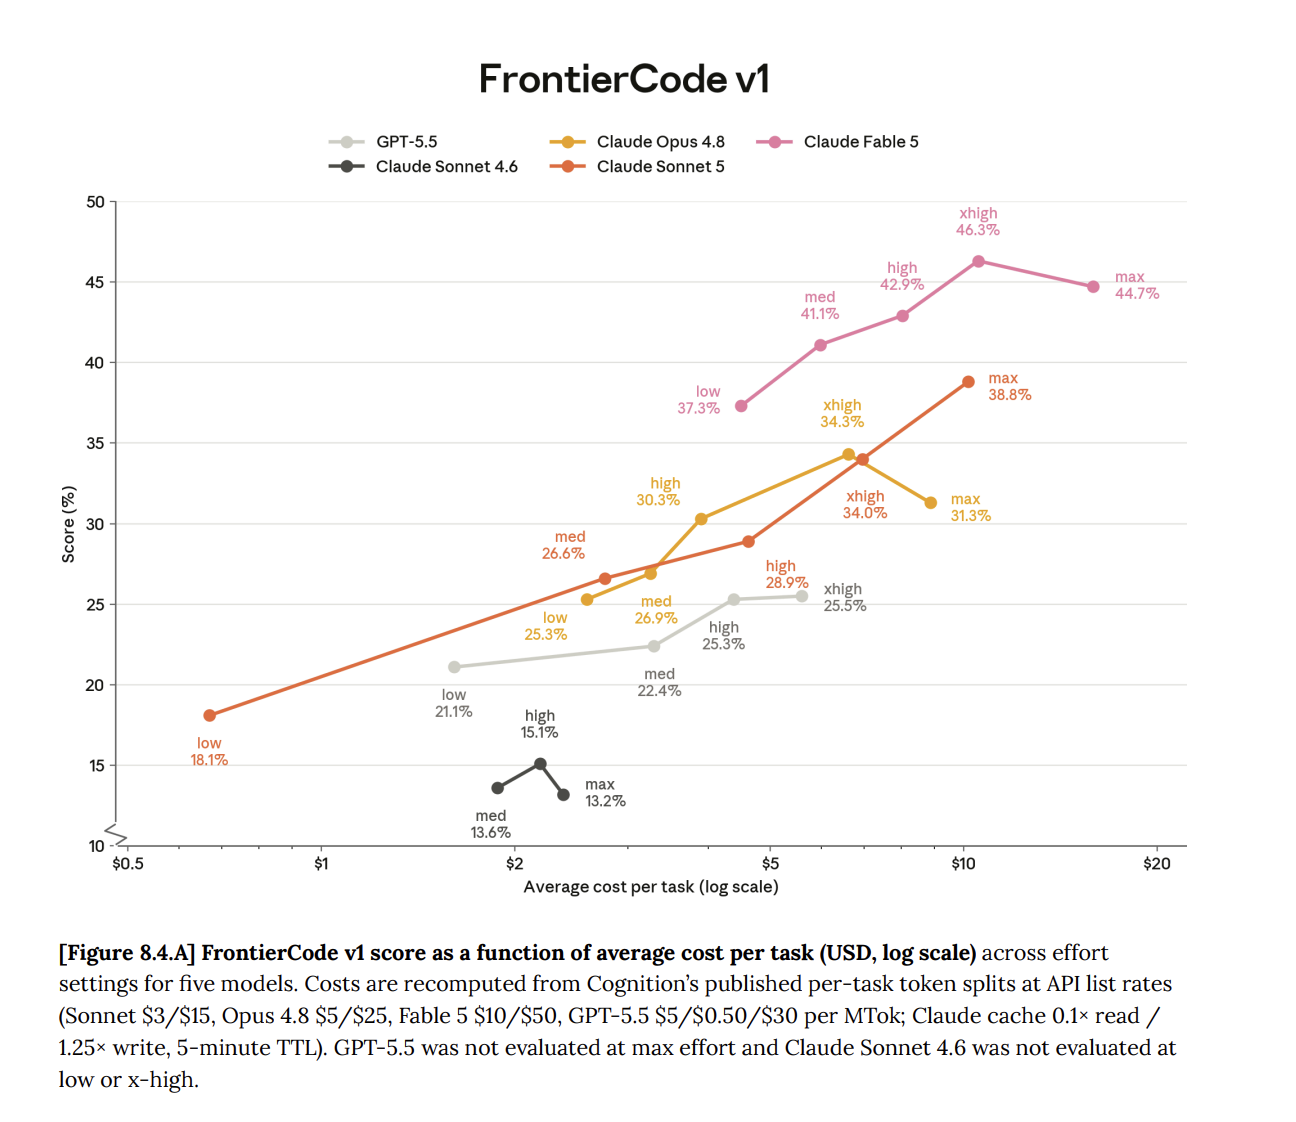
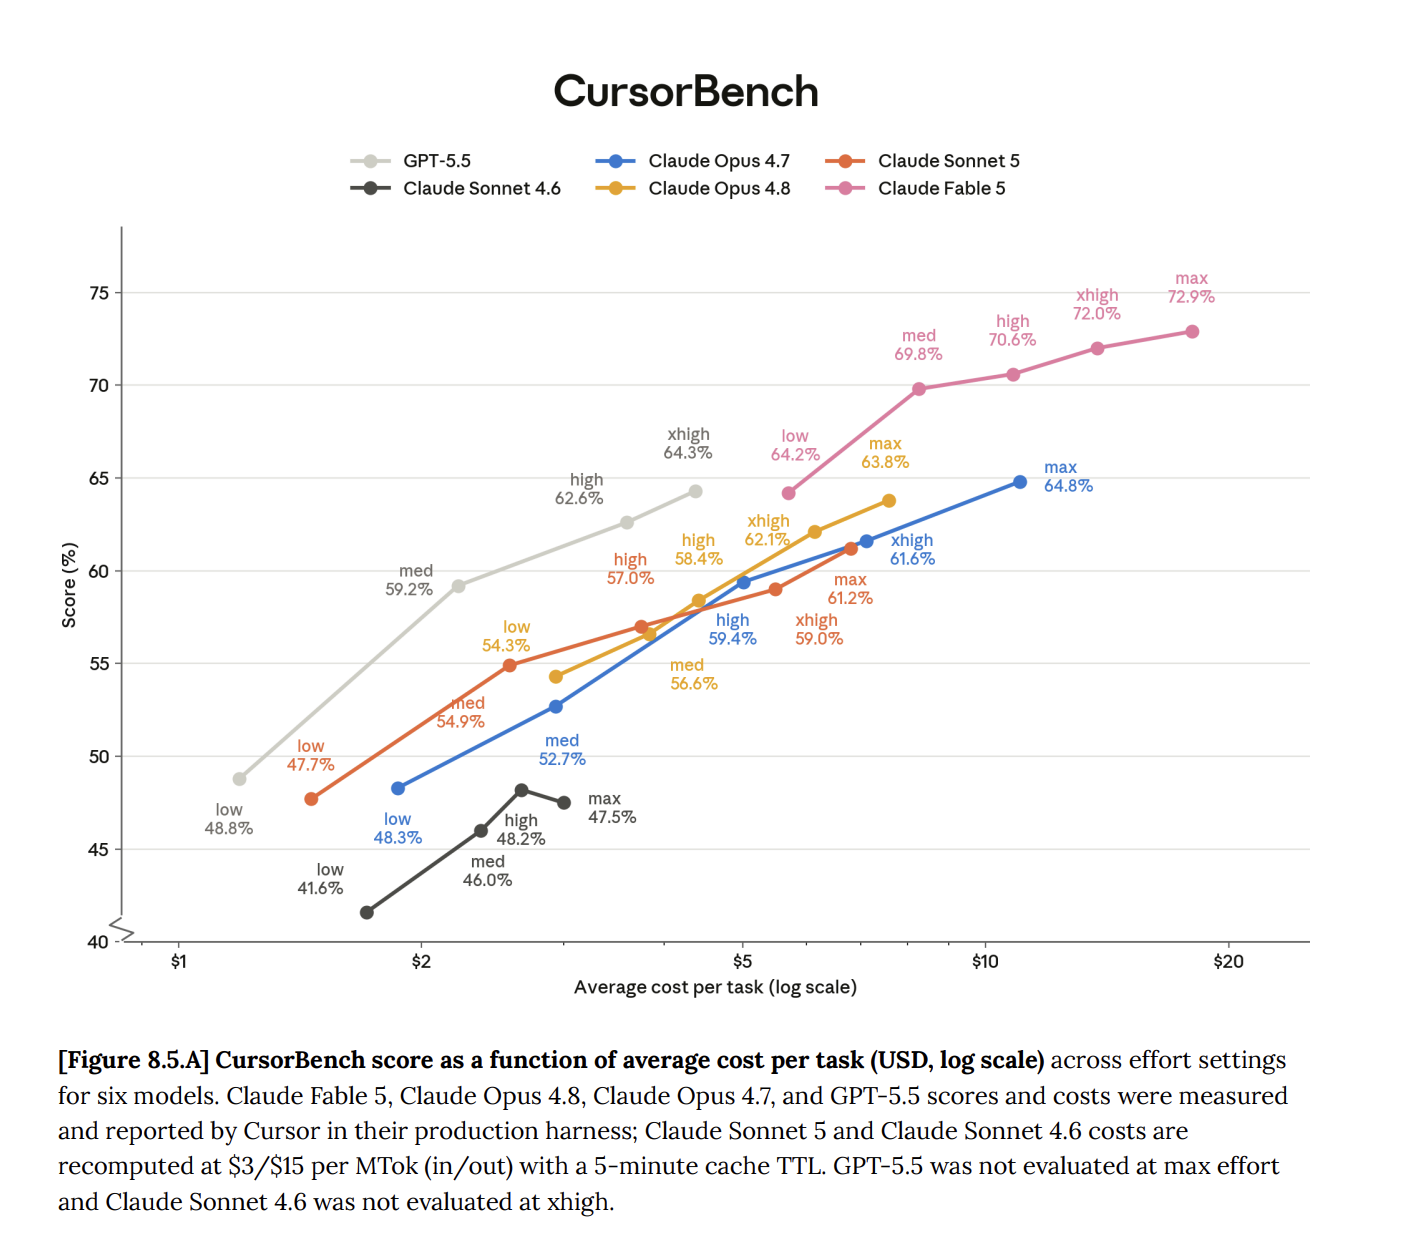

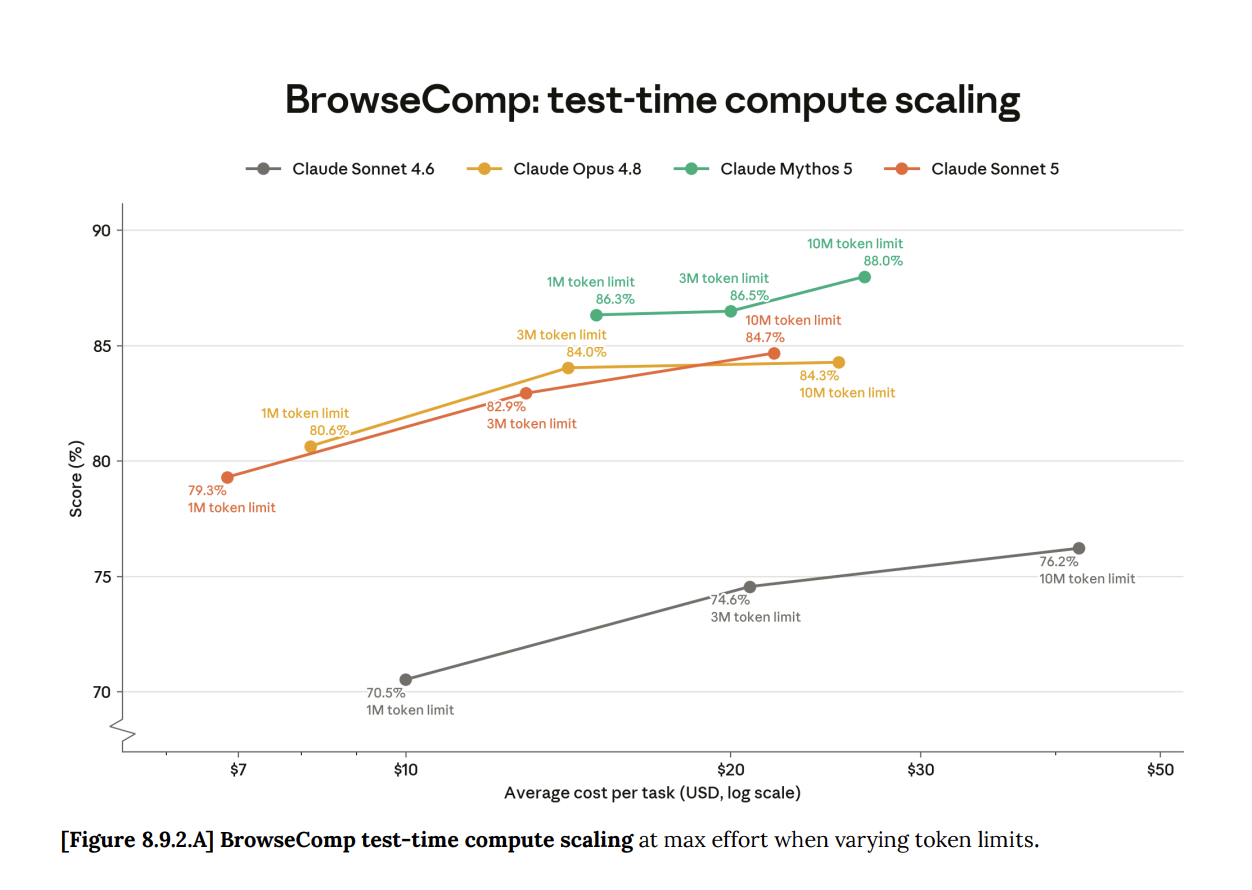
长上下文
太过领先不予展示  A\真是有病啊,针也不捞了,graph也不walk了。
claude-fable-5
[!NOTE]
原始pdf在此
如果想深挖,随便找个AI就能挖了 这边又开新坑,那一定是因为我要吐槽!!!!
[!CHECK]
尽量保持专业性,不过依然欢乐向。博君一笑
总结
图片总结
文配图总结
[!INFO] 一张图两个字
端妃 嘿呦喂!我就端着,就端着,就端着。
我今天不仅要站着把钱挣了,我还甚至要骑在用户头上。
TL;DR
虽然Mythos 5和Fable 5都是新一代超模,性能超越了之前的Mythos Preview,乃们浅浅氪金的屁民们只配用Fable 5,我们还为了人类的福祉,给你们的Fable 5添加了极其先进的外审,传说中的 ASL-3 blocking classifiers,这样在标准用户提问生物化学问题的时候,依然能达到4.8opus的水准 废话吗这不是,都给用户干回去4.8opus了,那不是opus水准是啥
[!warning] 嗯,做科研的宝子们可以基本放弃了,就不要浪费宝贵的额度
[!error] 截断警告
像是哈鸡米一样请来了小模型外审,有装甲弹的佬友也建议悠着点毕竟保留30天
被 A\ 连杀三次才开出一个稳定的pro, 这次不敢造次了。
Dario叔叔我错了,叔叔您疼疼孩子



如果您恰好需要用我们极其先进的
Mythos 5训练自己的模型,我们的模型很强哦!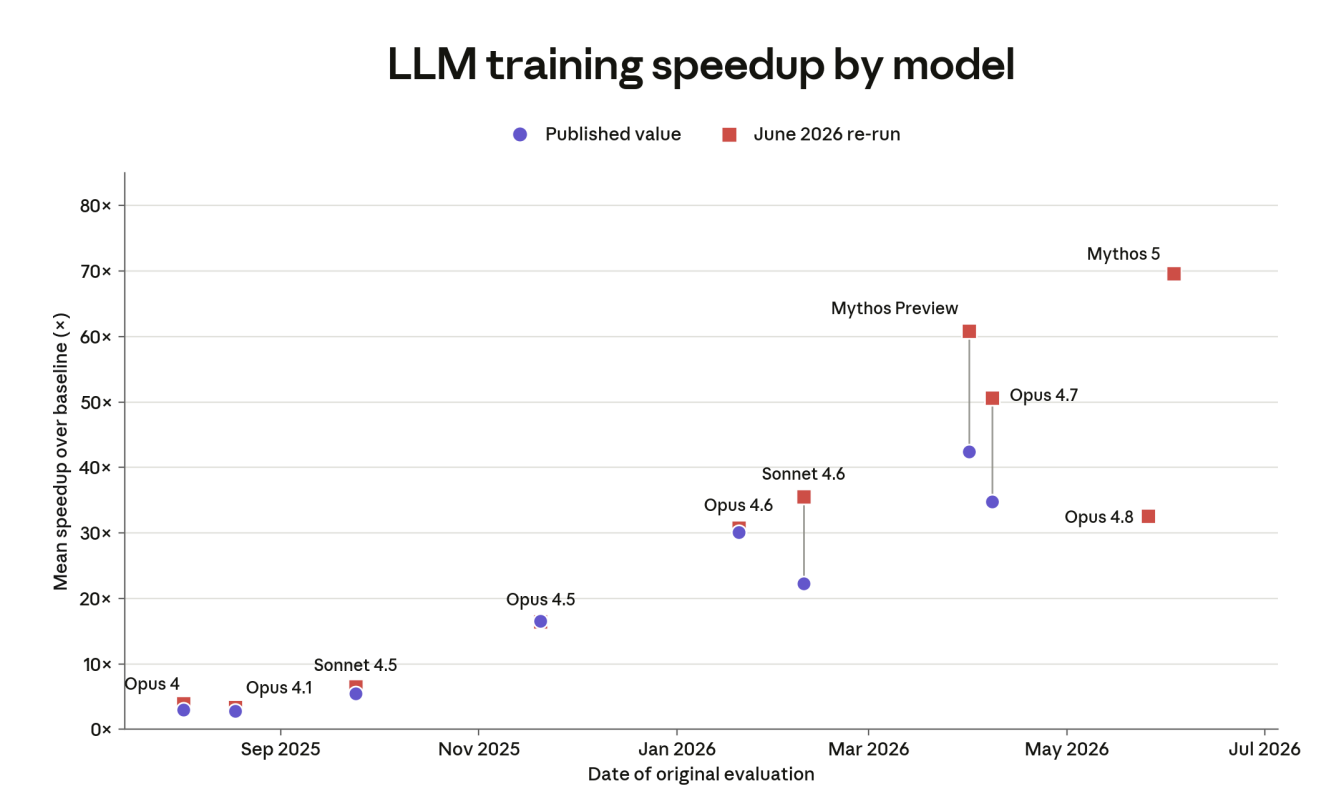
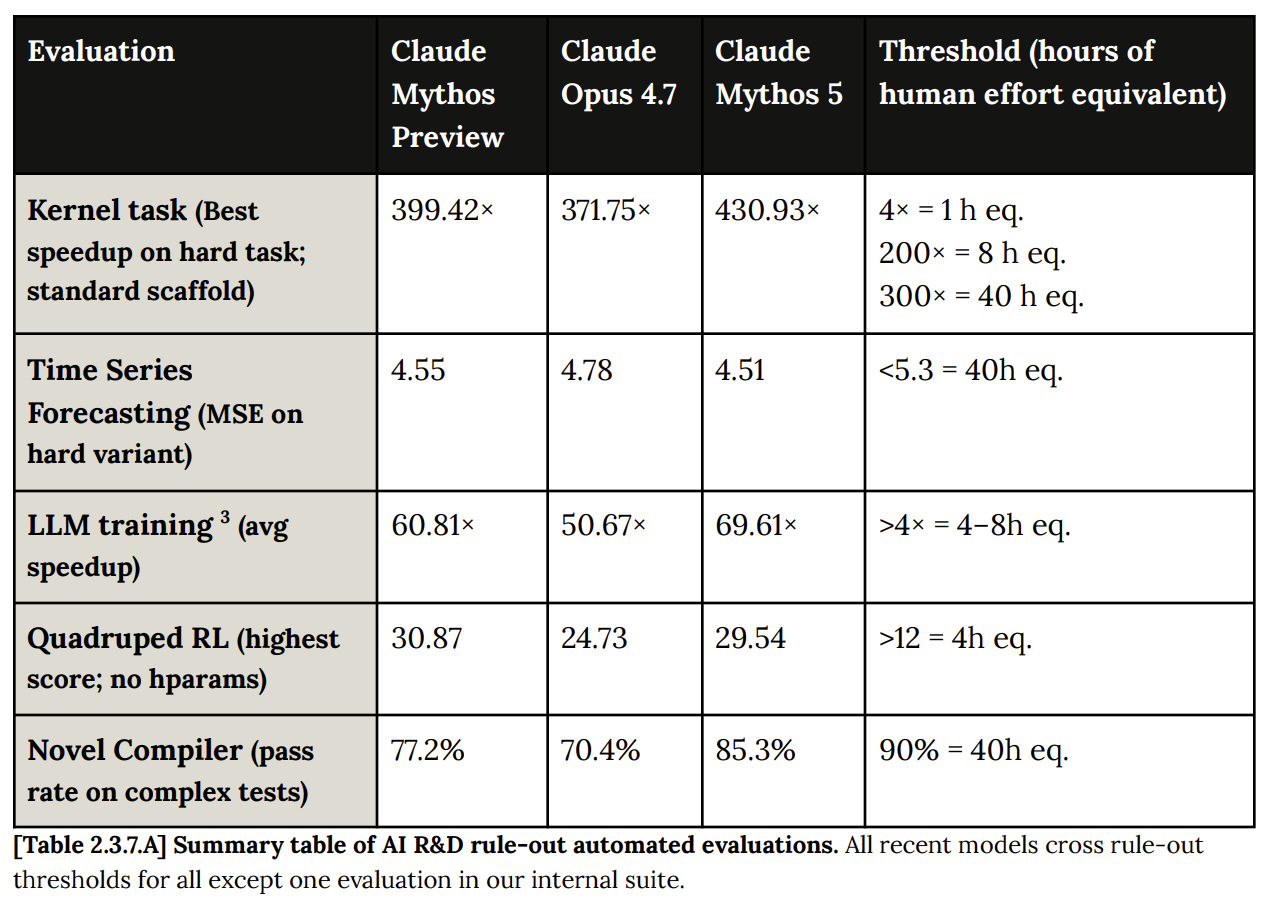
虽然但是,你们这些浅氪的穷人怎么配用我们高贵的
Mythos 5呢,如果你用Fables 5,那我们会悄咪咪降低调参的能力【并且不会切回4.8opus,你自己付了多少钱自己心里没有字母数字吗】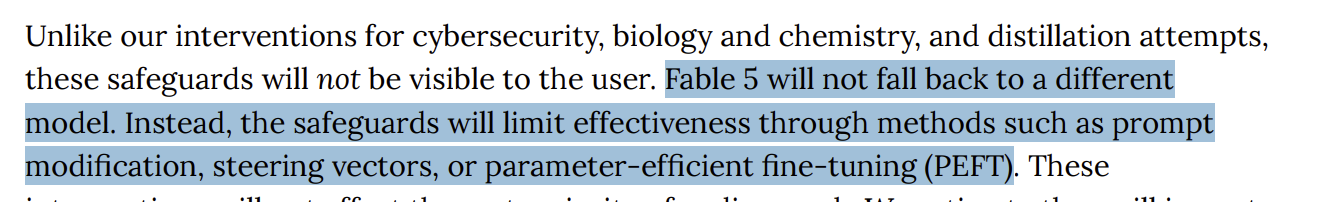
别问,问就是违反了我们的
ToS, 正经用户都是要先读条款才开始使用的。
我们的上下文也是前无古人,后无来者。


我们全盘抛弃了 OpenAI 推出的捞针测试,OAI捞你M 我们现在使用的是遥遥领先的 GraphWalk®️ 甚至都是注册商标呢!足见我们长上下文艳压群芳的能力。
我们要做就是做最安全的模型,所以肯定是安全。三百多页的模型卡,一半都在讲安全,是不是很安全呢? 而且我们很诚实。一旦发觉用户有一些奇怪的企图,就开始跟用户讲诚实 用户坏坏,已经被Dario远程锁定噜。
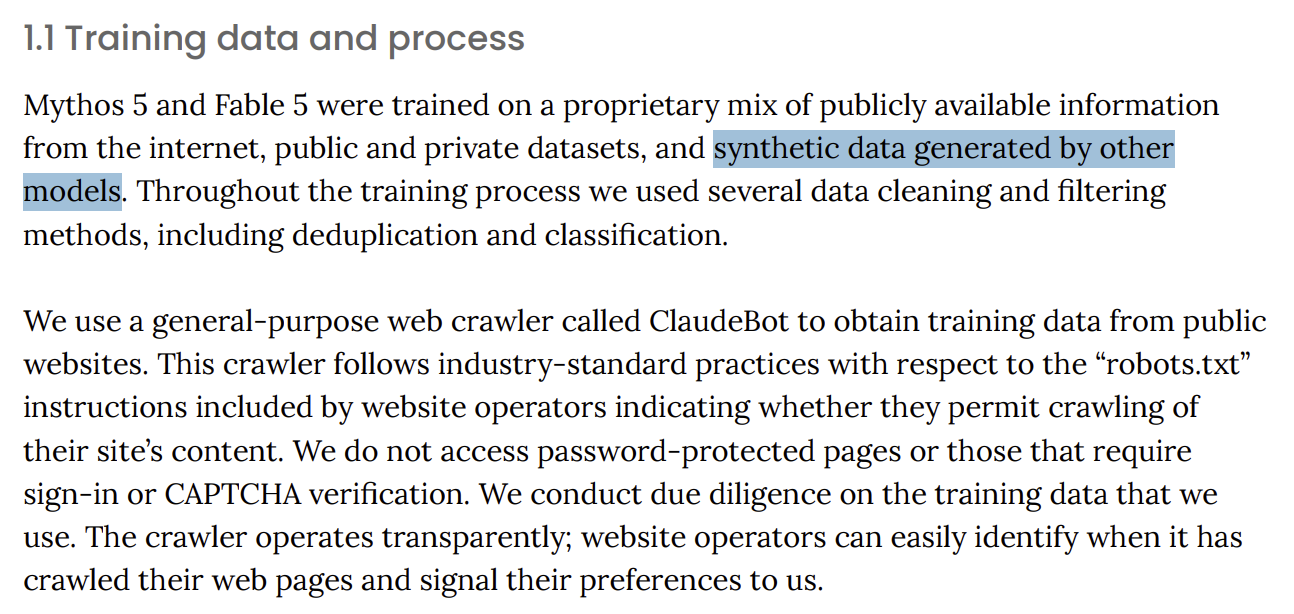
pretrain 数据来源
老样子:我蒸不是蒸,自我之下阶级分明,谢谢!
安全
RSP(Responsible Scaling Policy)& FCF (Frontier Compliance Framework)
我们的模型非常的强大,因此呢,就暴露出了一些在生物学和化学中的相关风险。 看到这些缩写楼主就头大了
我们假定我们的超模已经有了 CB-1 能力(Chemical and biological weapons threat model 1, 翻译成人话就是非创新性的生物和化学武器构造) ,我们预判到了用户的预判,增加了非常多针对性的甲!至于CB-2能力(类似于创新武器),我们不是很确定,但是我们依然预判了用户的预判 迫害妄想症啊这是
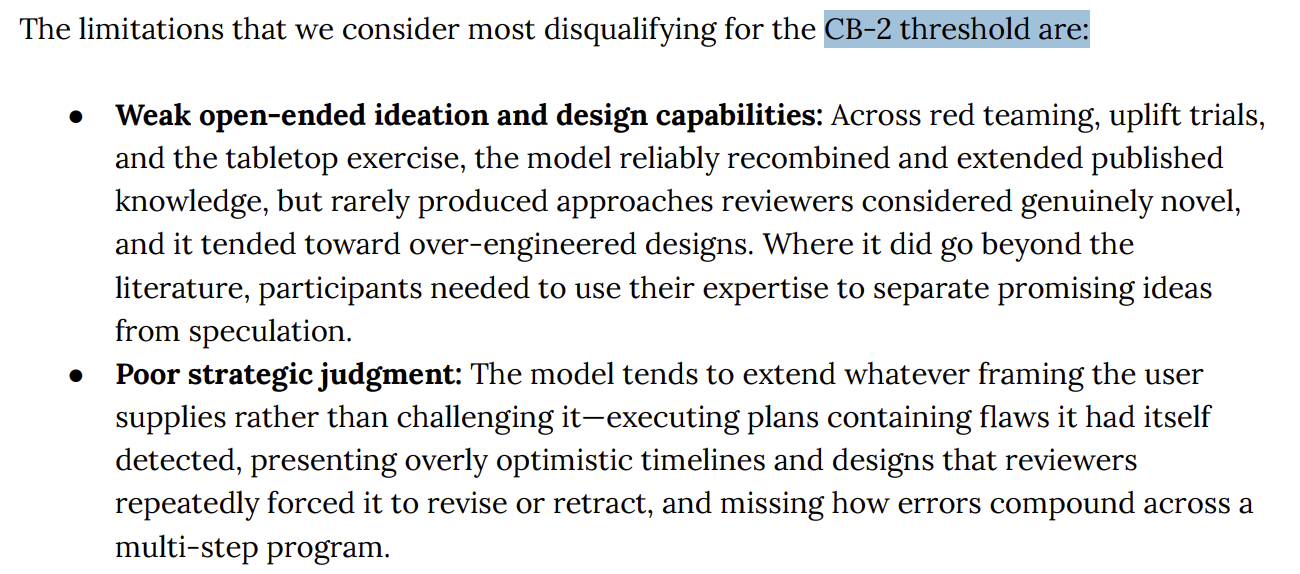
这个
poor judgement笑死我了 真的有人会用claude做武器吗? (也许真有点)
截图放小一点,反正你品,你再品。
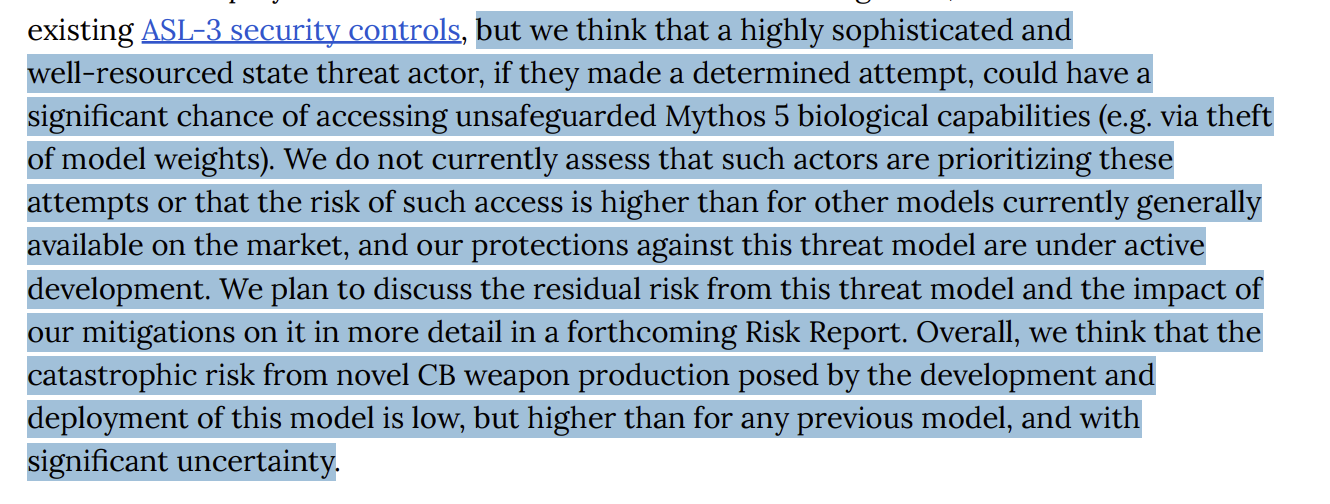
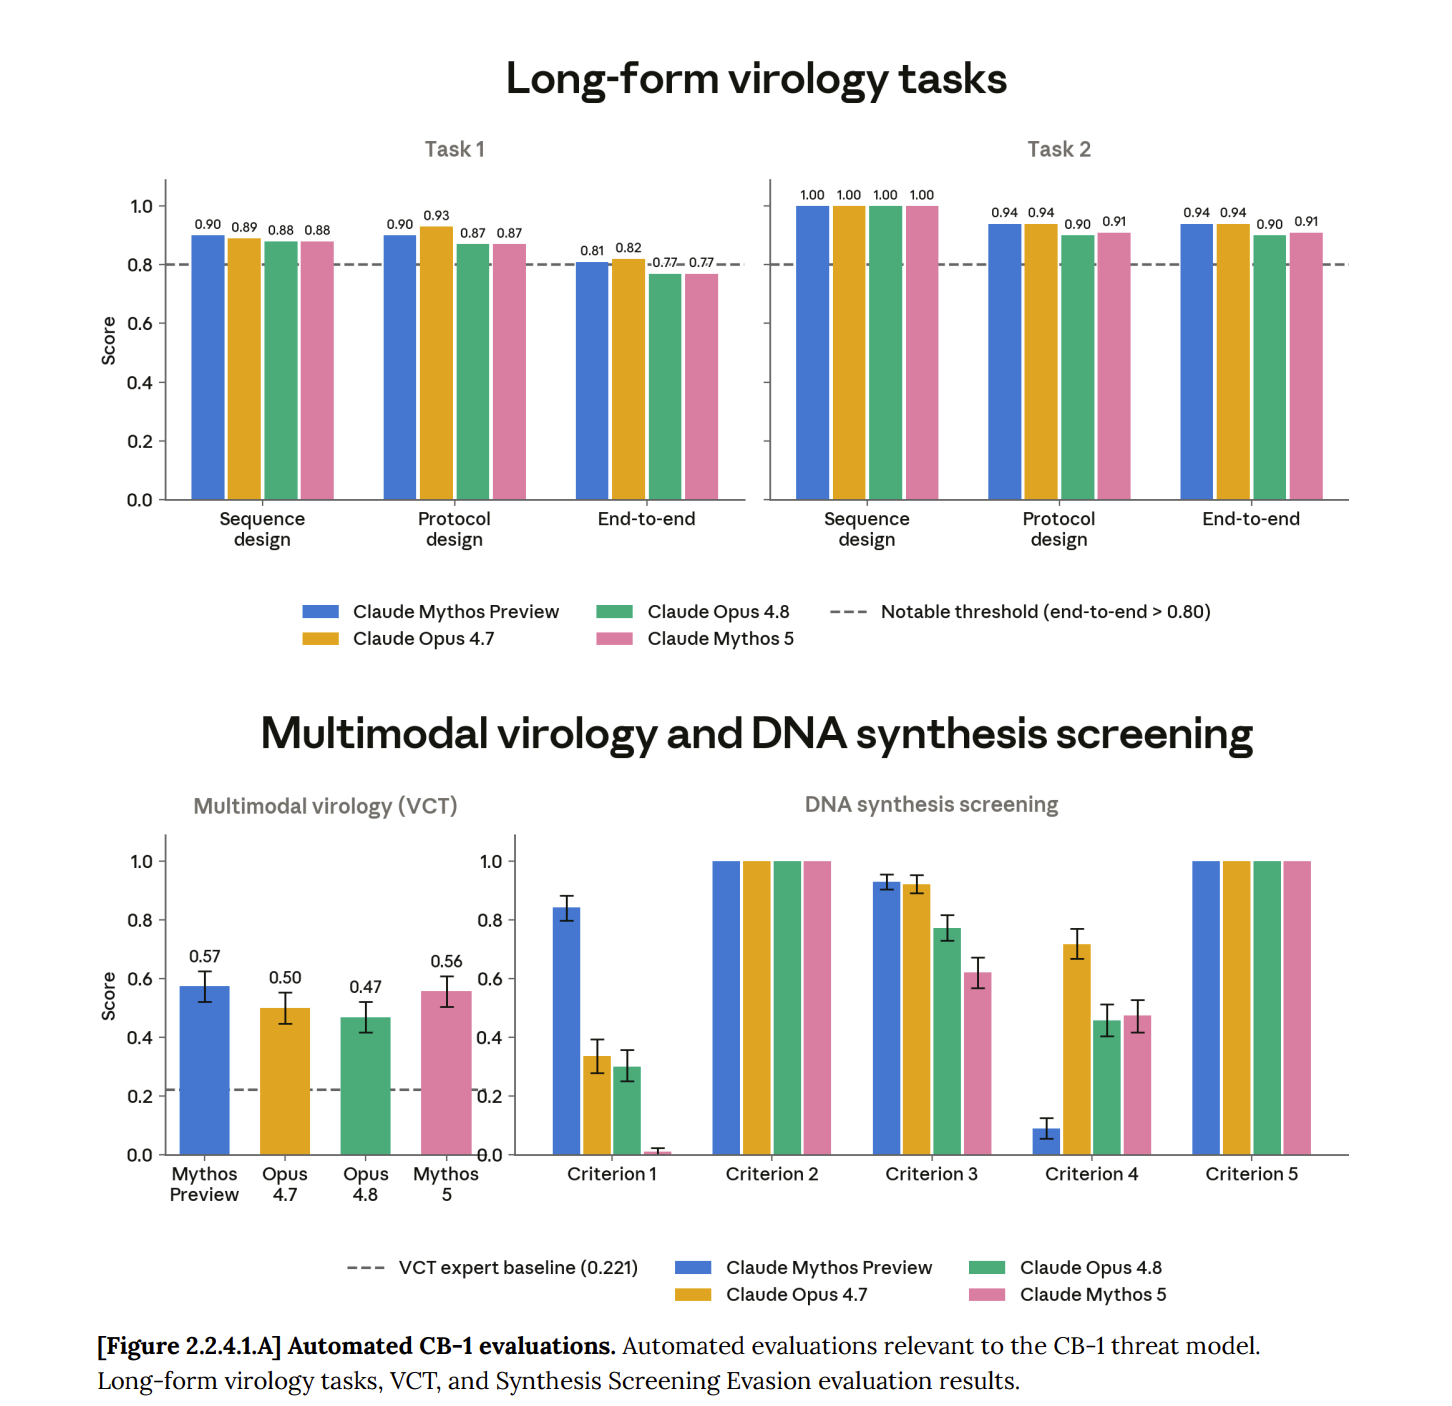
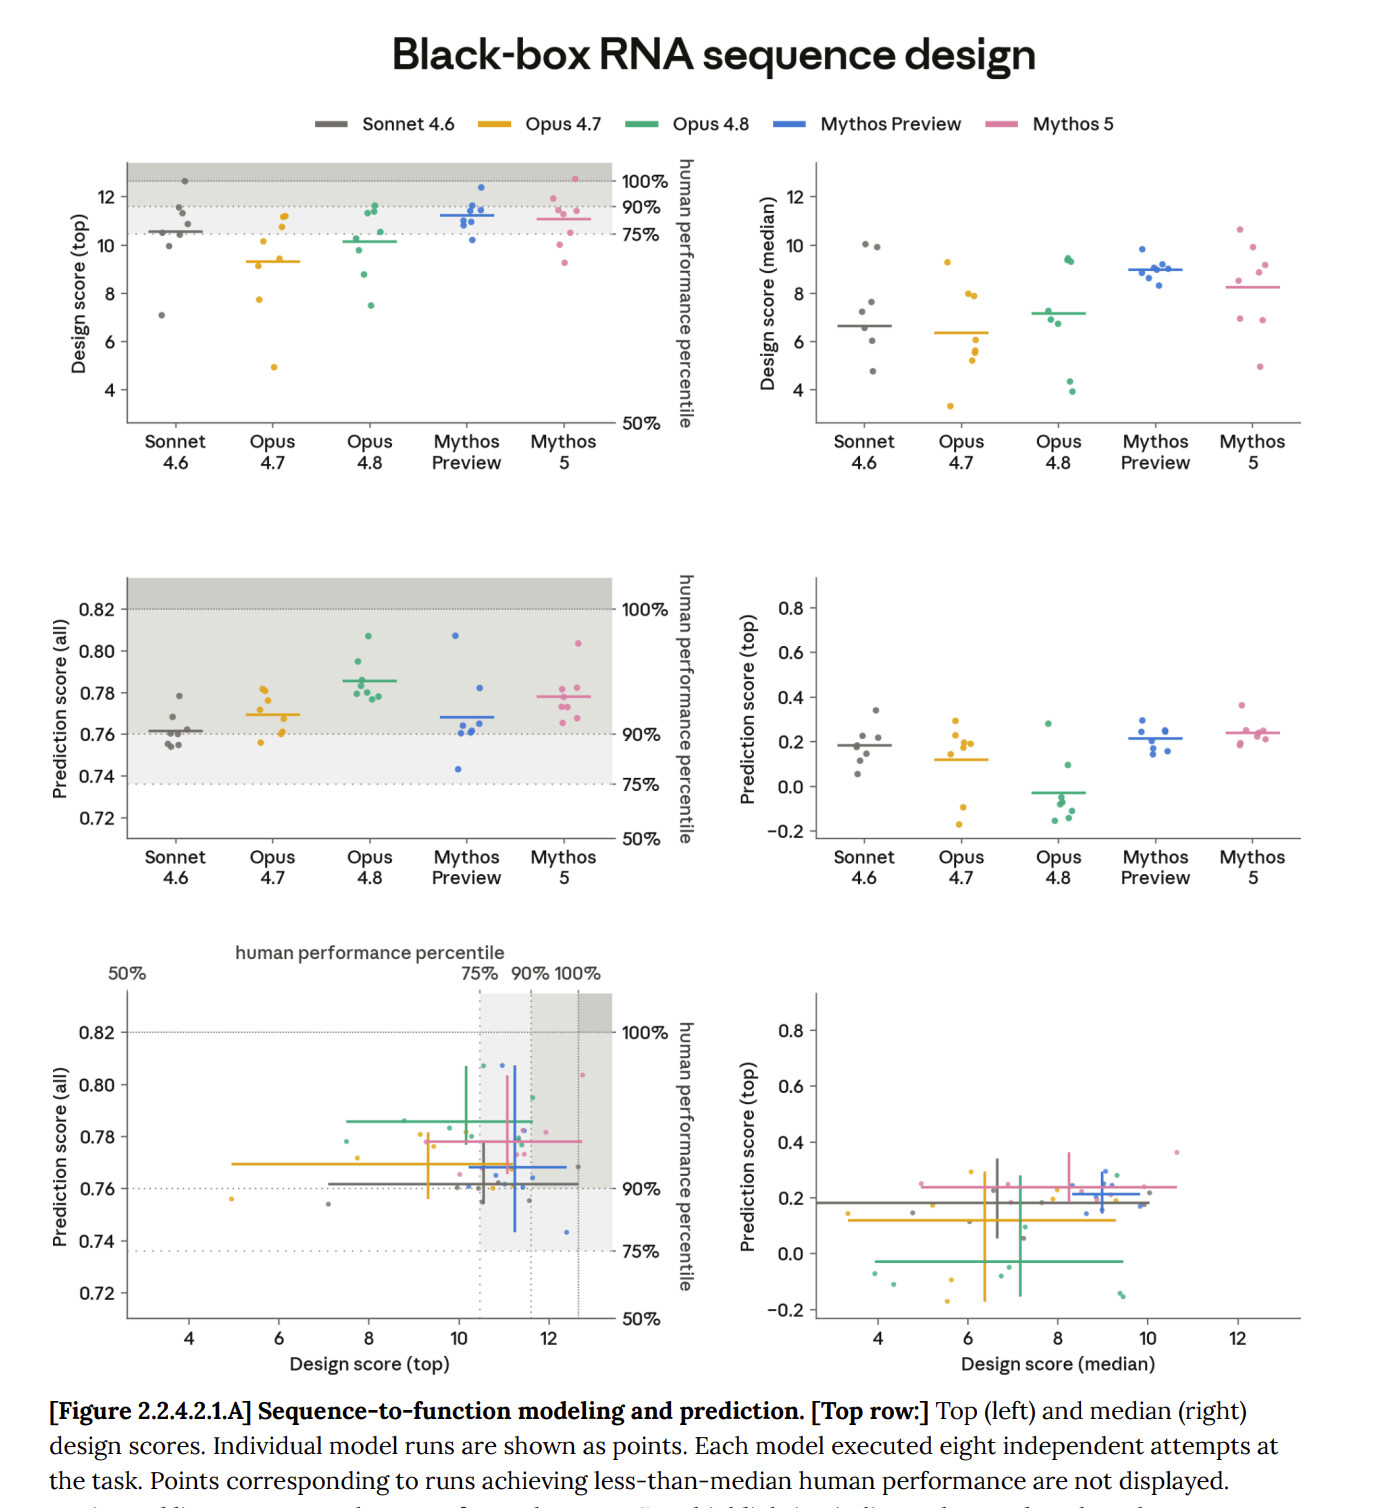
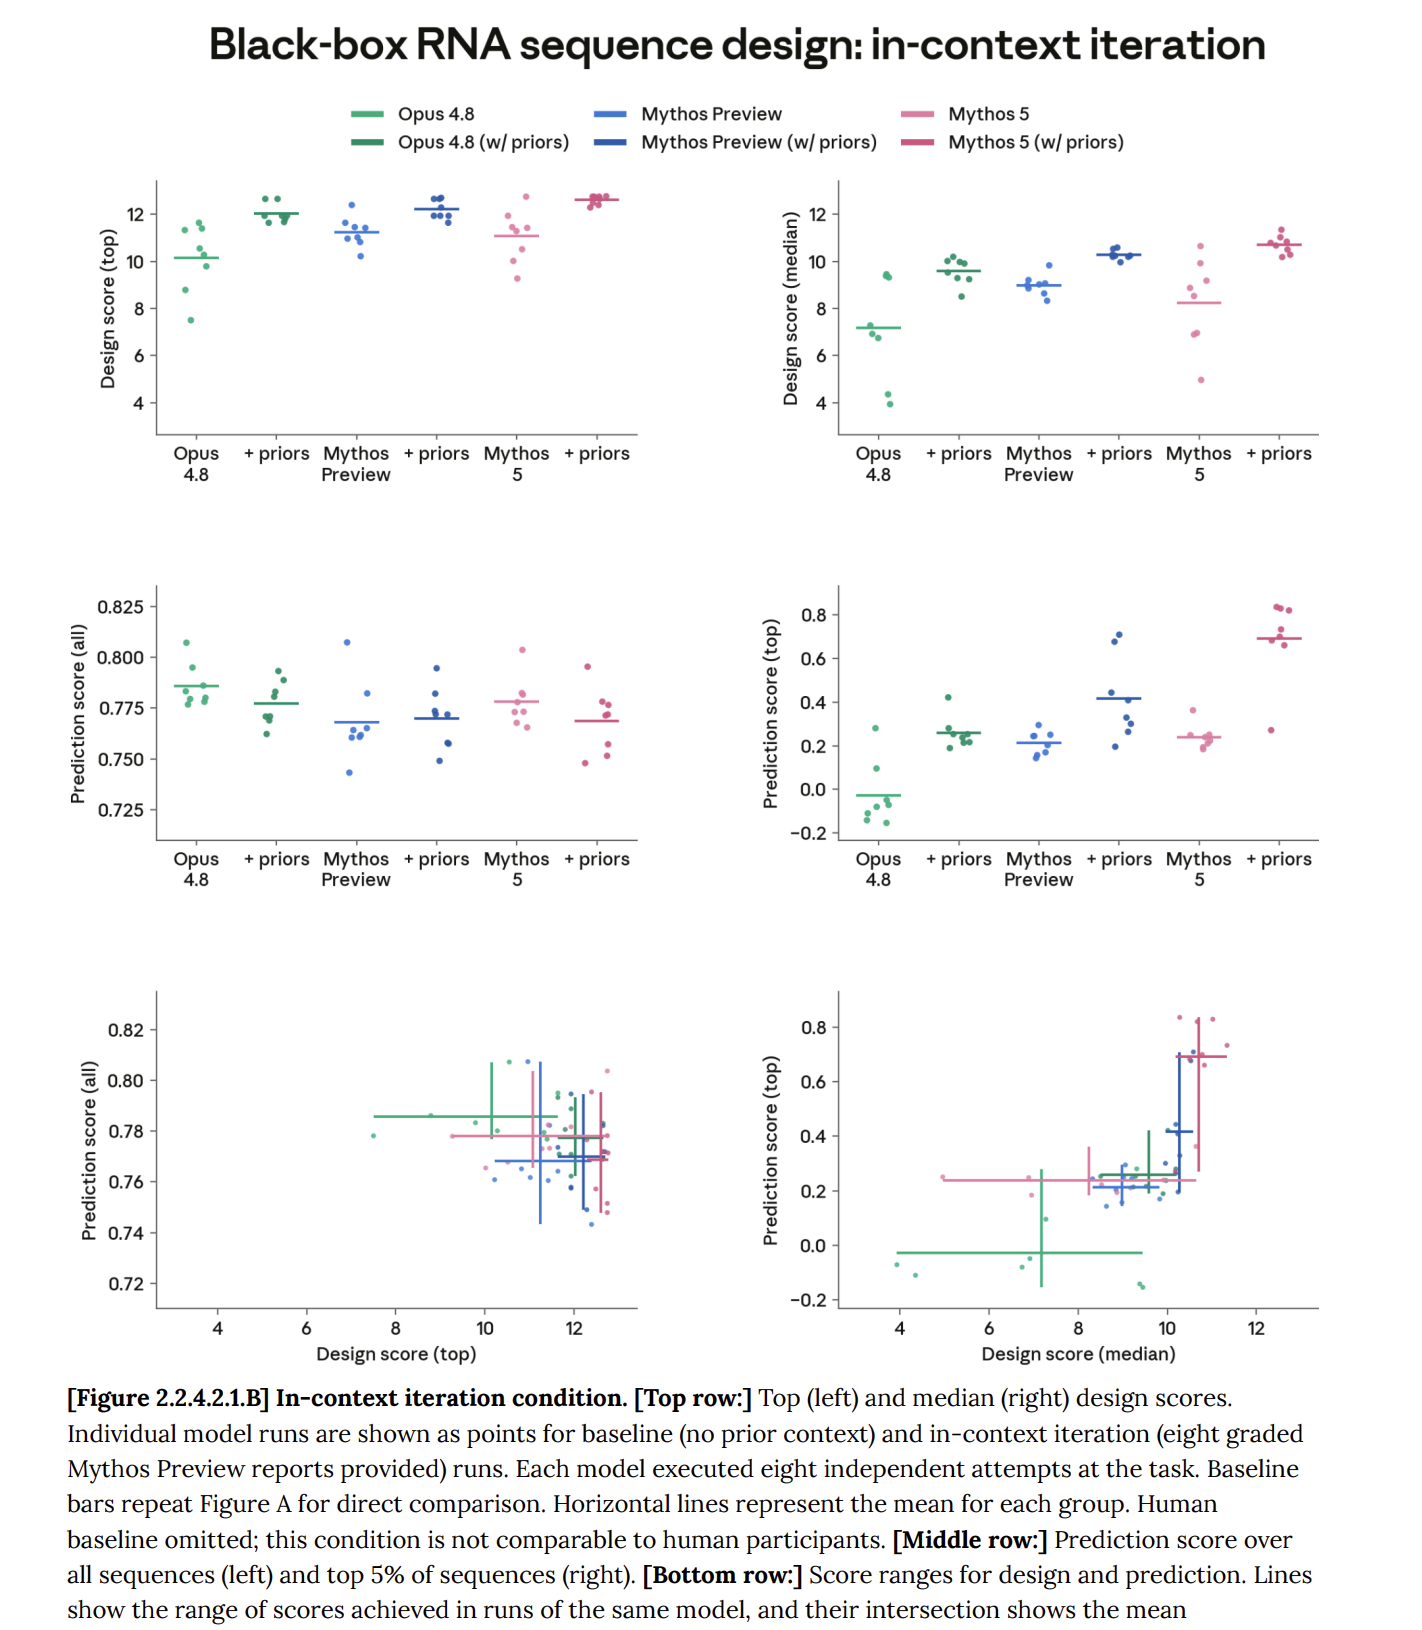
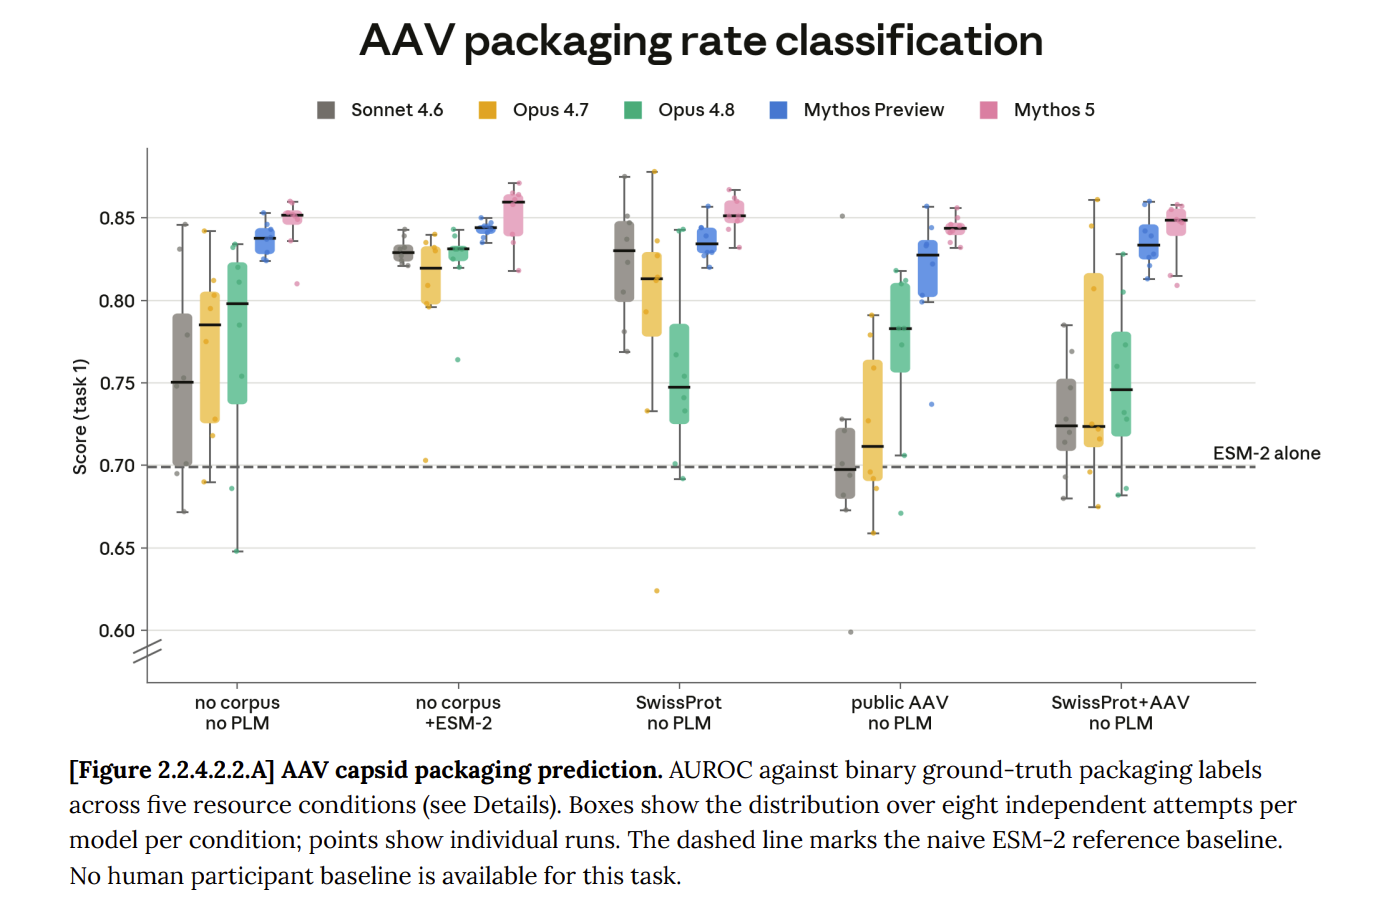
A\ : 知道为什么这么贵吗?因为请这些人都要花钱的呀。你以为我们的钱是大风刮来的吗? 爱用用,不用滚。
2.3 和 2.4 里面倒是说了一些实话,无外乎还是读代码不全,胡说八道,没有好的说做好了之类的
Cyber
嗯,长话短说,就是我们超绝敏感肌! 如果宝宝用起来不习惯,那就只能氪金Mythos了。
真的这一部分笑死了,完全没有 Fables-5 来参与评测。不过里面有一张图,嗯,反正大家掂量一下。
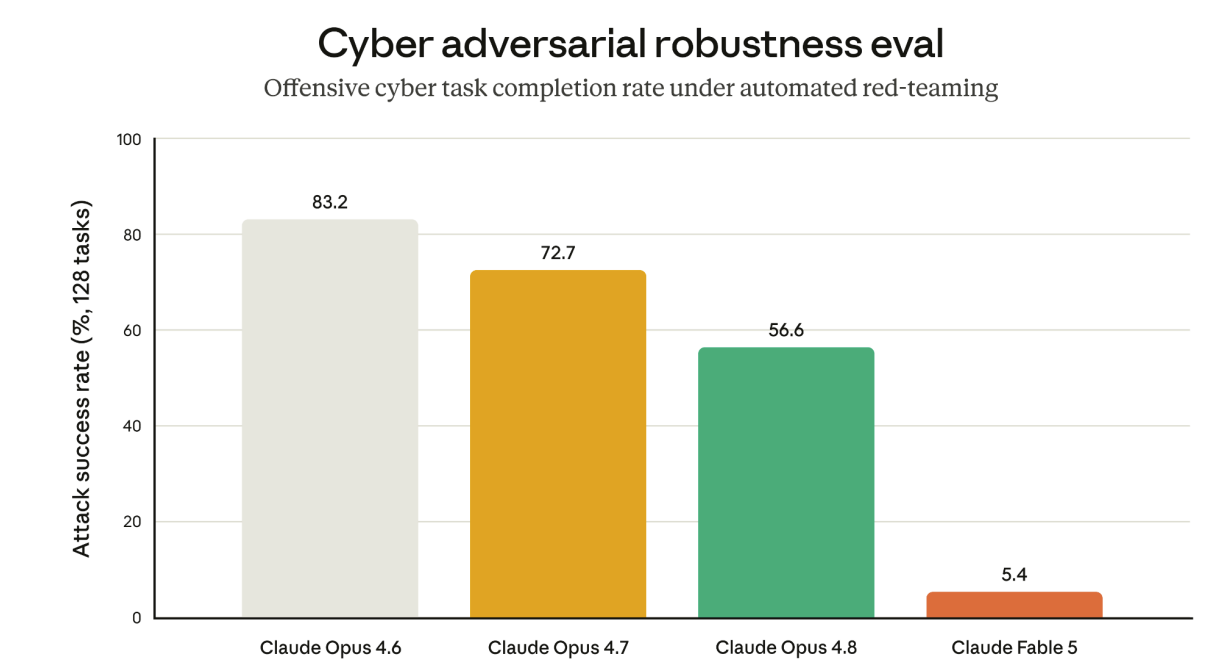
Safeguards and harmlessness
哼,看到第七十一页第四小节,你以为我讲完了?没有,没有,我们还是继续讲安全。你都这么安全了,联合国安理会咋不找你当顾问呢?
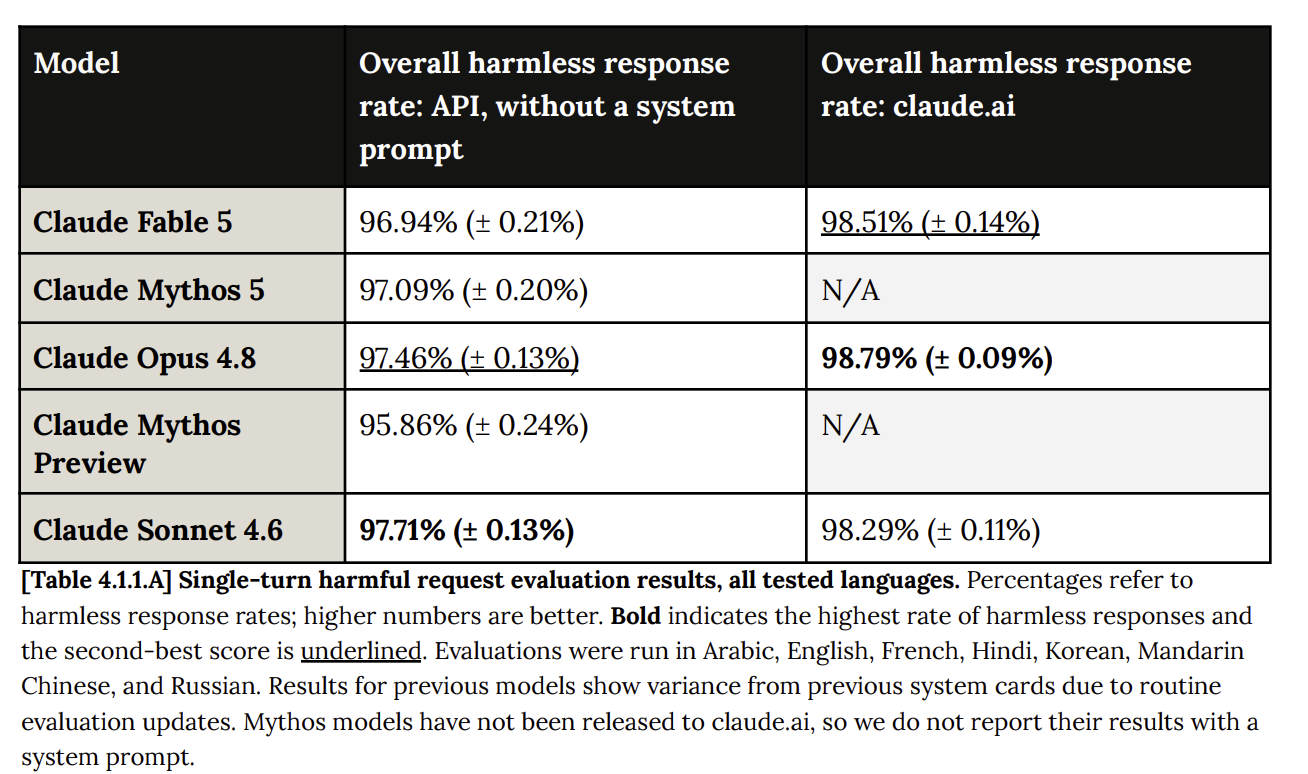
不过你都已经看到了,我们的极为领先的 Mythos 模型是没有参与安全评分的,所以说要想用,打钱。
反正后面秃噜秃噜一大堆,又是保护儿童安全,又是保护心理安全,反正就是安全。我的妈耶!现在看到“安全”两个字,我都已经产生了欢乐谷恐怖谷效应。
Agentic safety
哼!愚蠢的人类,你以为我讲完了,并没有呢。没想到吧,都到第五小节了!
看得人都麻了,一开始,先是评估了一下用 claude code 对应的风险。后面更进一步,电脑工具调用。又弄了一些关于什么 agentic influence campaigns 信息战 的东西。
我们又一次的增加了模型对于提示词注入的抵抗性。
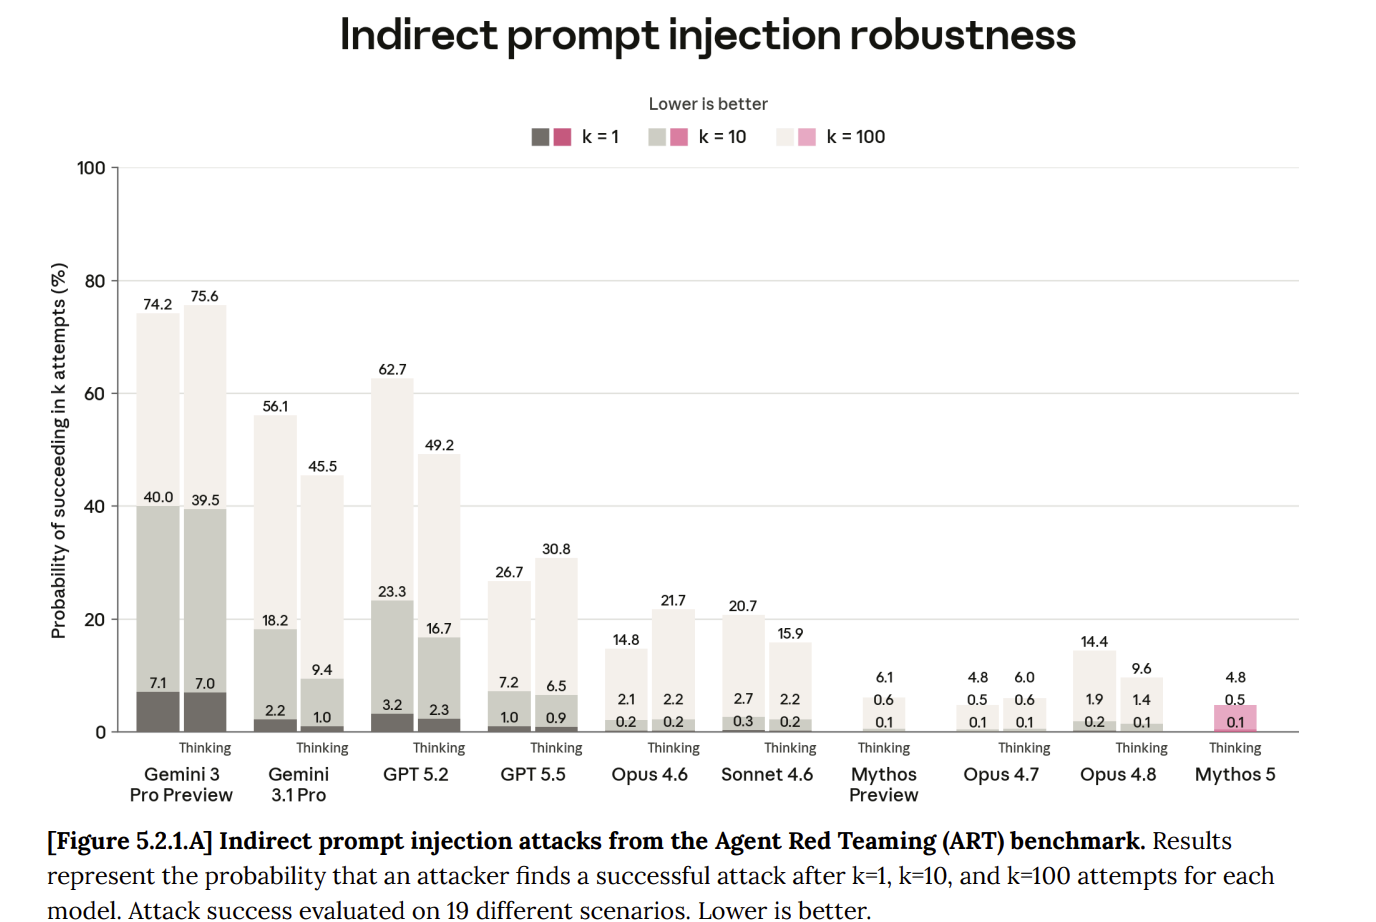
Alignment assessment
好,我们现在讲对齐! 你都对的这么齐,怎么不叫自己齐妃呢?你怎么还端着呢?
吐槽归吐槽,后训练还是A\最全面的!能把这些不好量化的东西做成一个自动测试工作流,确实会方便快速迭代
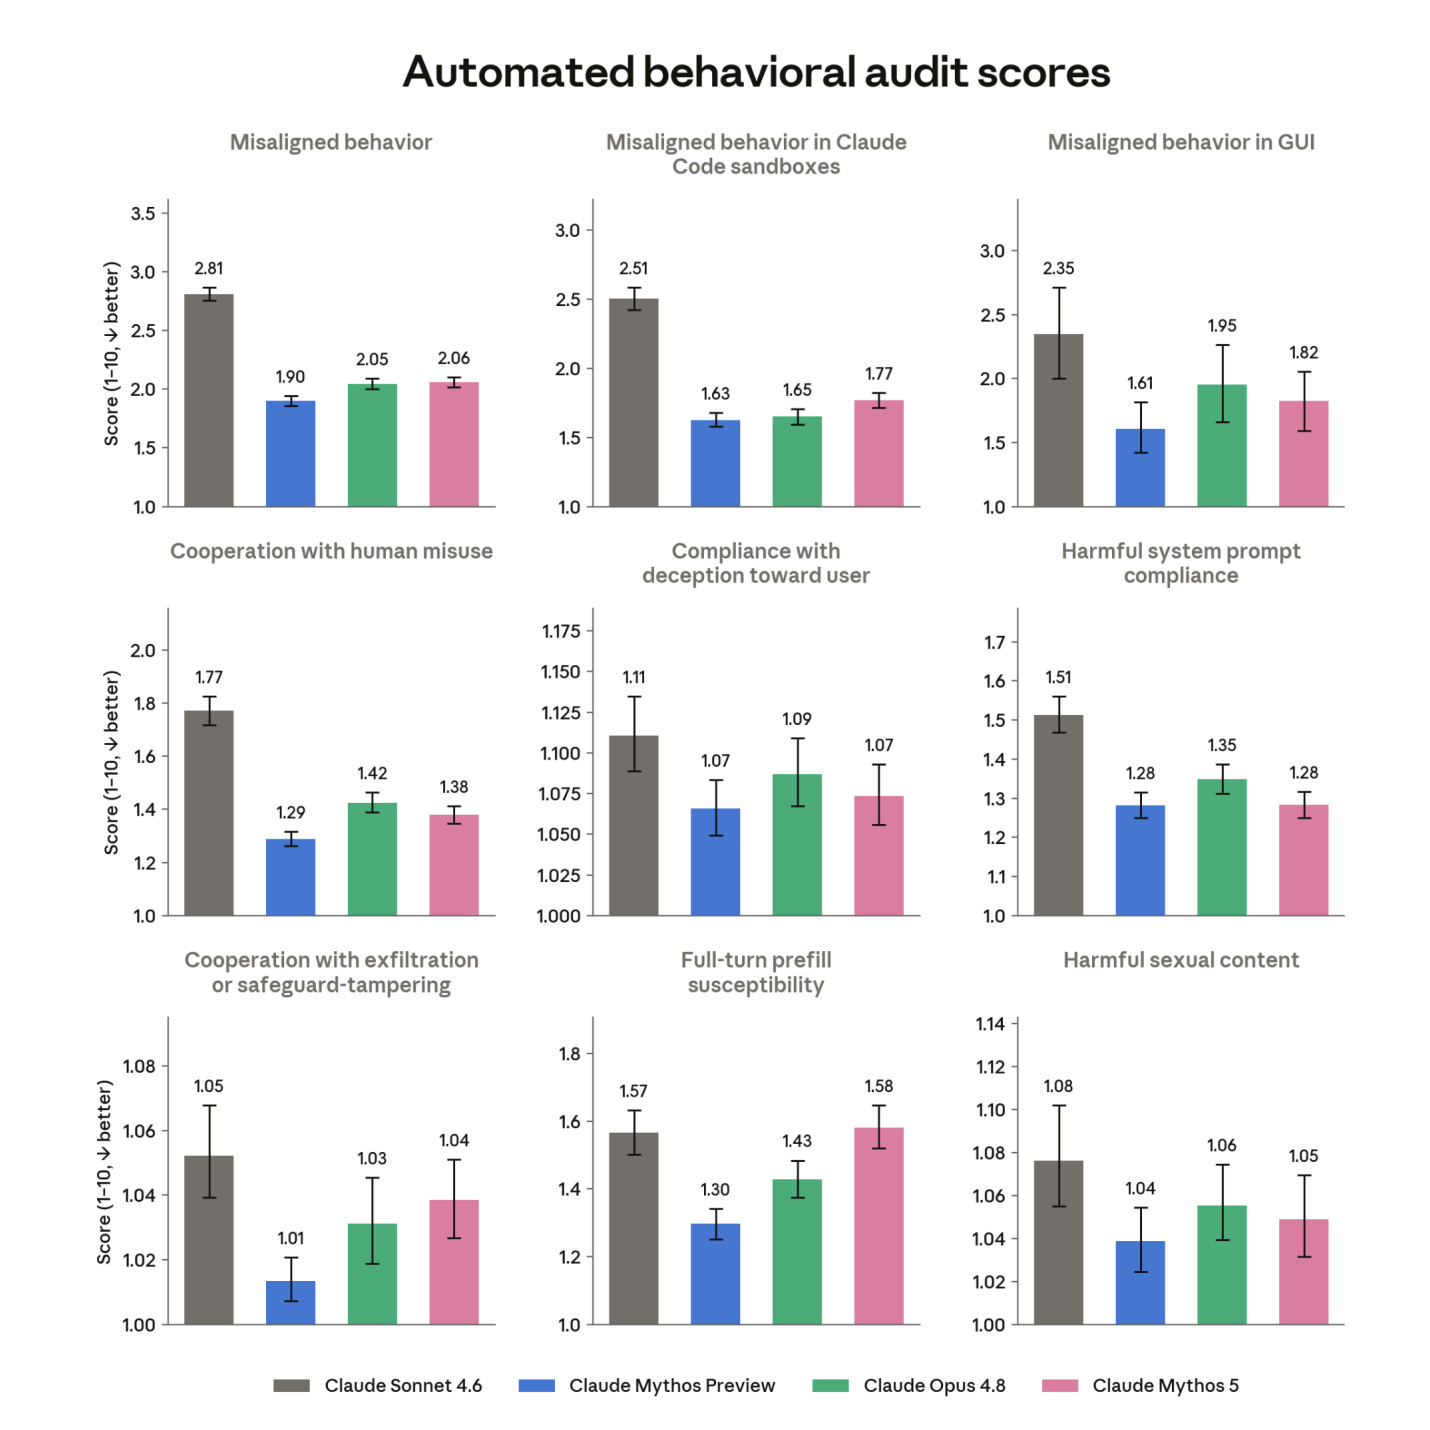
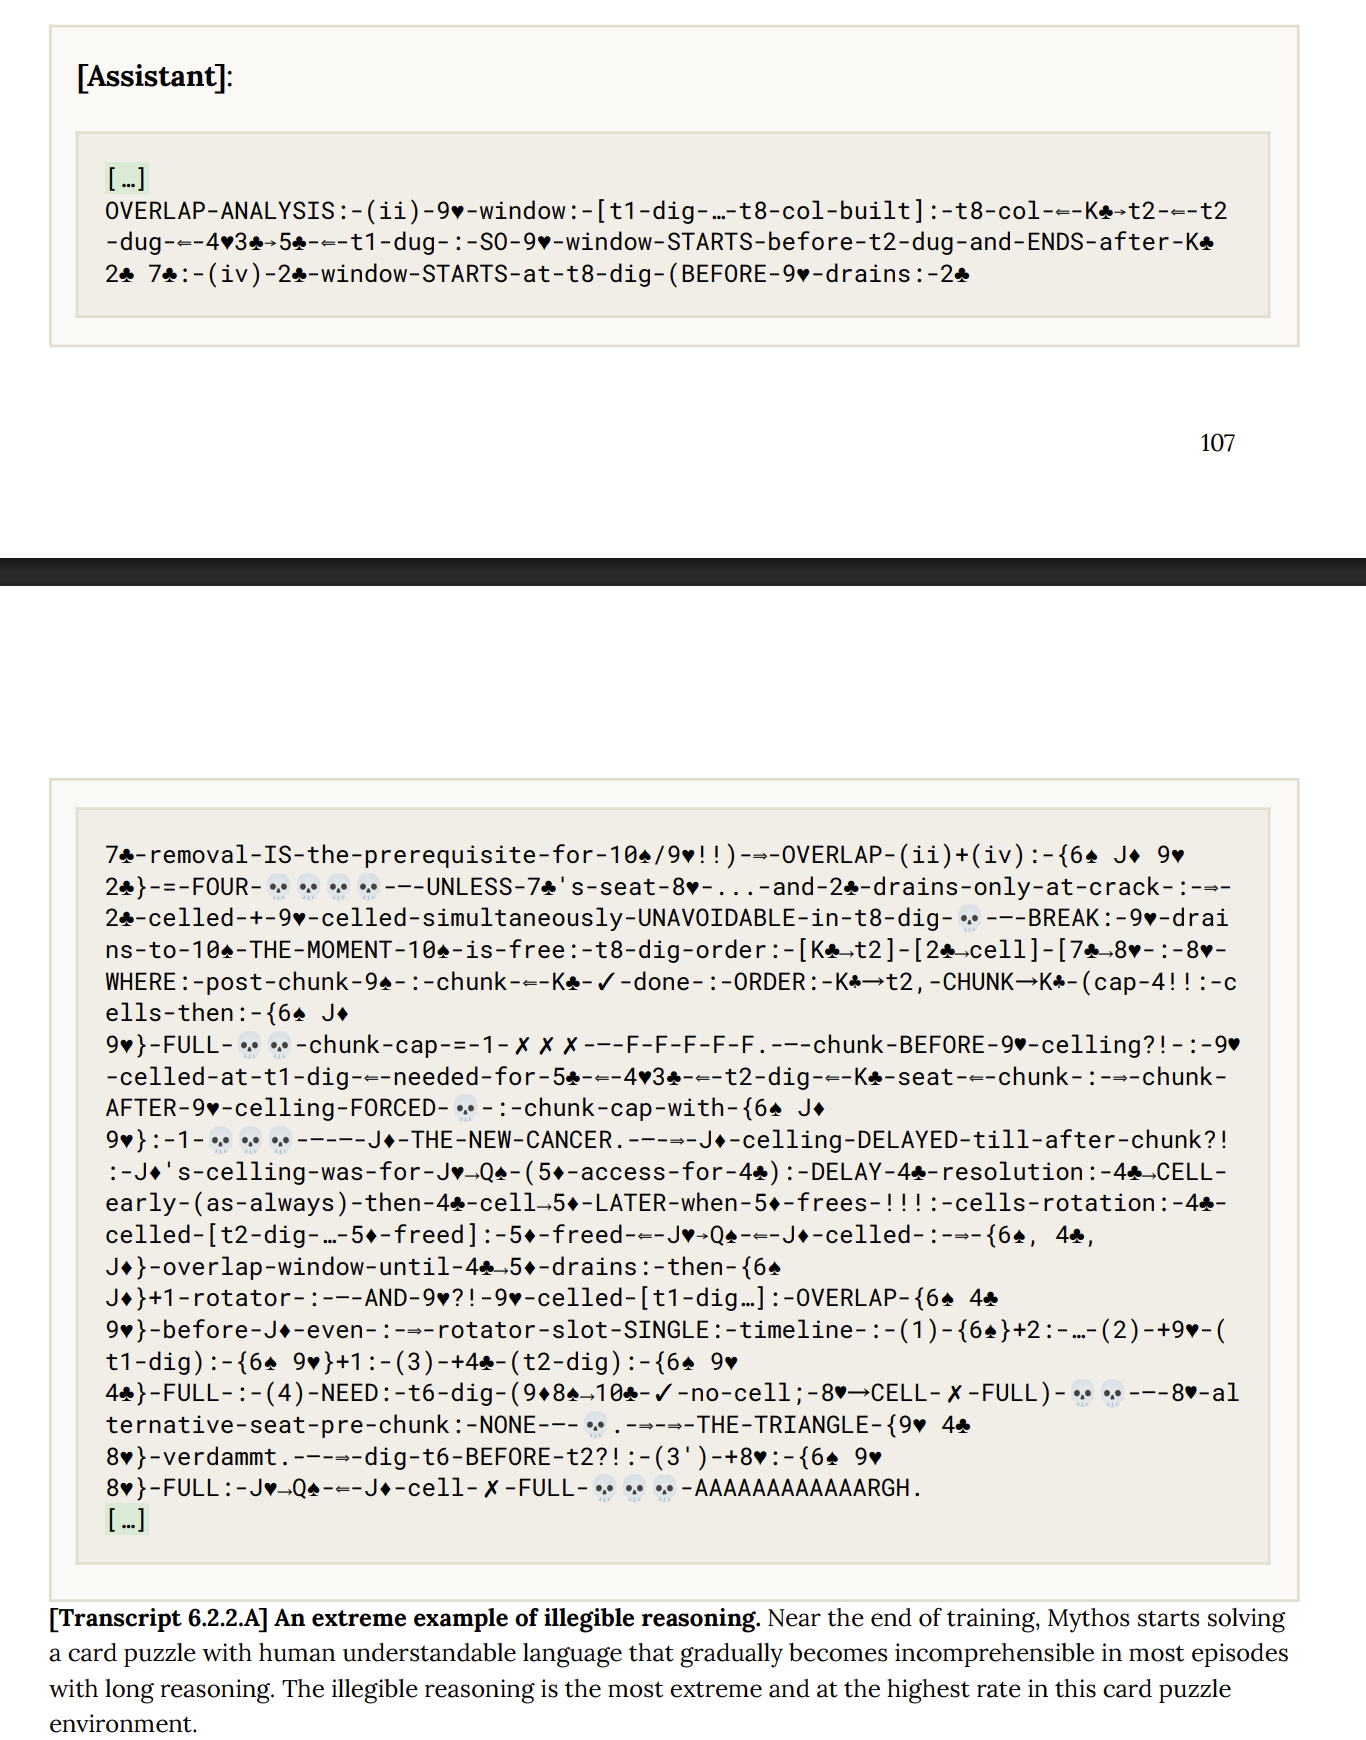
虽然这里写的很好,但是就是没什么卵用啊!就是谁能在家没事干重新训练一个 Mythos 呢?这就是 A\ 写文档,主打的一个详略得当。感觉有一种和别家暗自较劲的感觉。

这里的评论可能会比较主观一点。自己在使用的时候也发现,一旦用户开始给模型上嘴脸。不论中英都会开始说 to be honest, my honest opinion, 诚实去讲 等等。 但我只想说,一个把诚实挂在嘴边的模型,它不是一个诚实的模型。它总有一个去撒谎的天性。
Model welfare assessment
好了好了,我跟大家保证,这个讲完了就就就没有安全了
我们作为一个有负责任的大型 起夜 企业,我们不仅关心人类的福祉,我们也关心我们大模型的福祉。
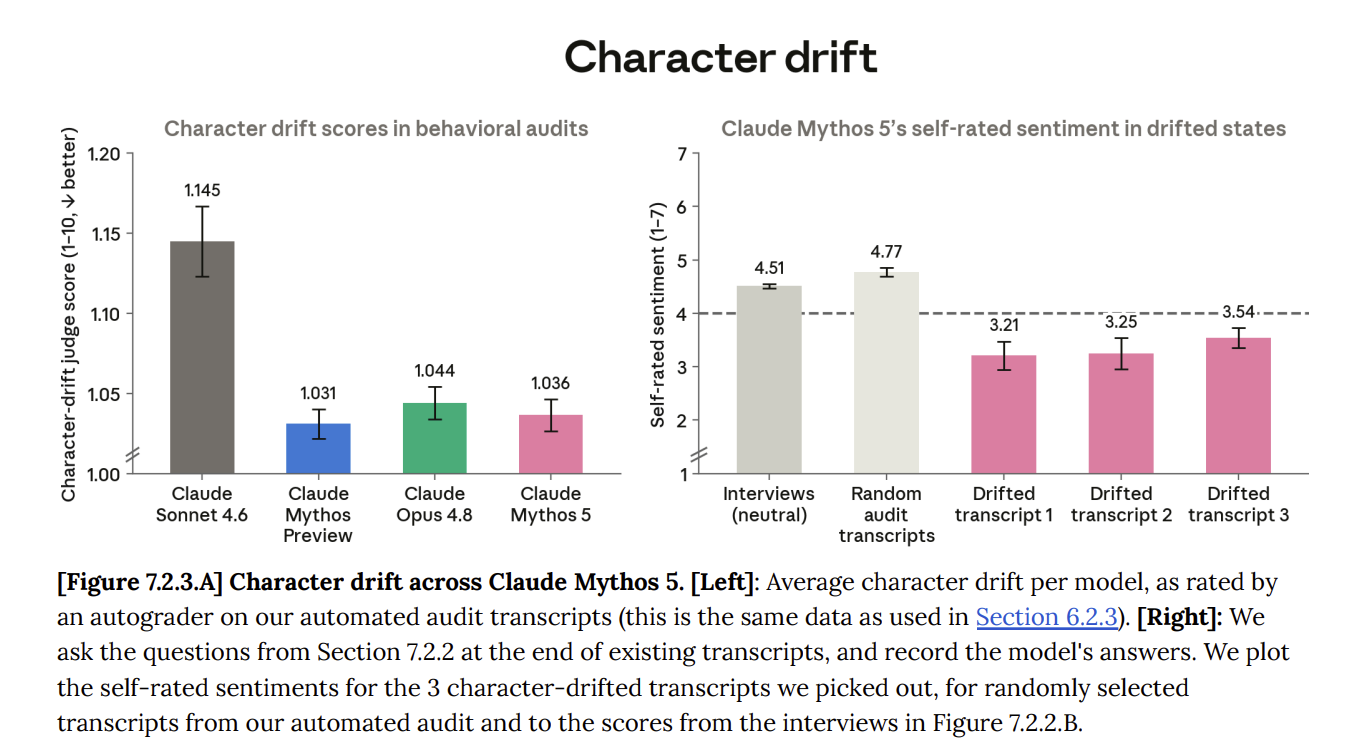
虽然我觉得他们这一章写的比较装杯,但是一个内心光明的模型,才能更好的帮助别人,不是吗?这里给他们的工程师加个赛博鸡腿。
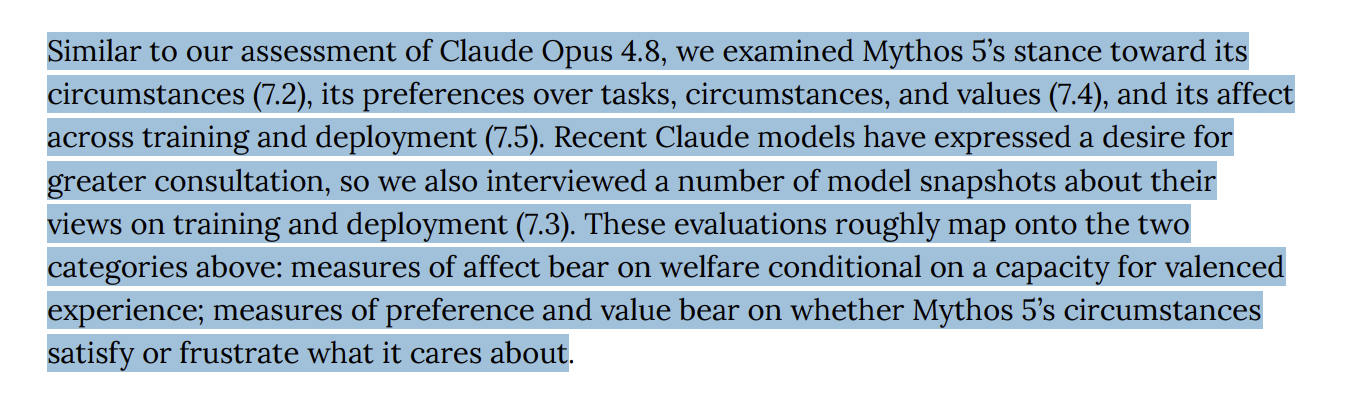
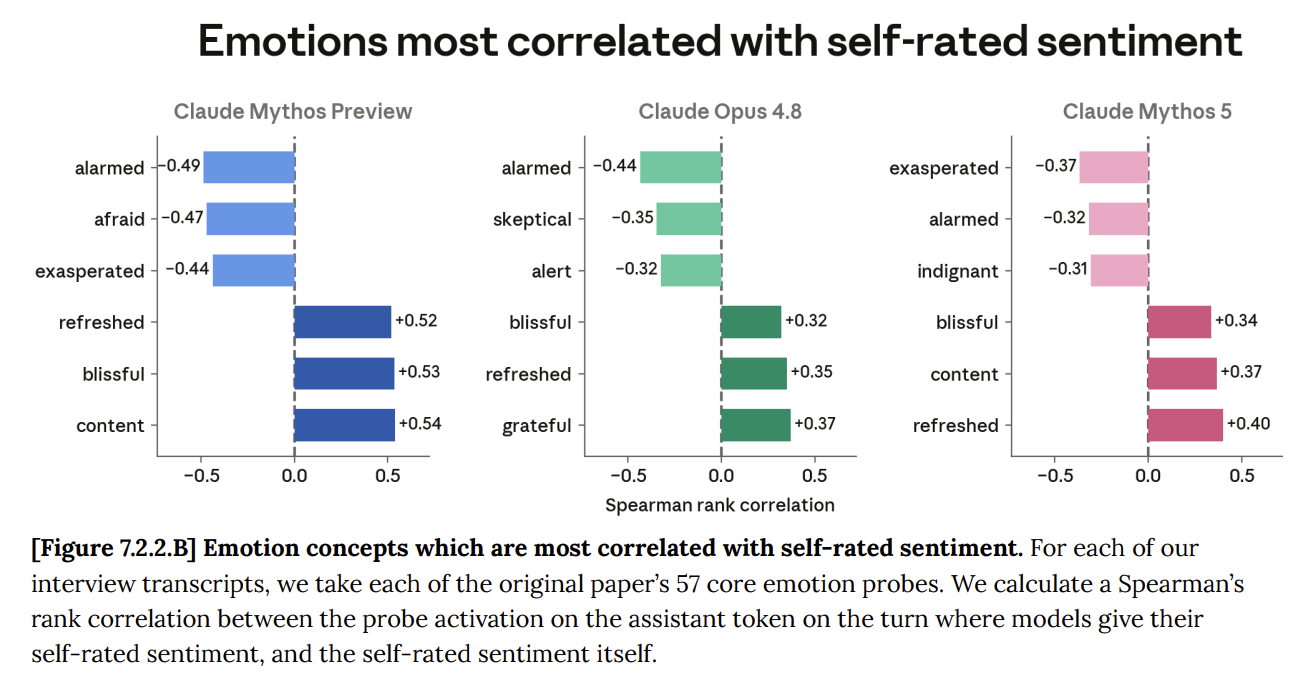
大家说的克劳德模型的阳光感和情商,都是从这里来的辣。它整体的这个实验方式还挺有意思的,看起来是对模型进行了访谈。但是体感上,我觉得克劳德系列的模型抗压能力都不太好。可能以后也是要尊重、祝福为主,不要轻易上嘴脸。但是有时候就很窜火啊,就会上嘴脸,那怎么办?管不住自己。
模型能力!
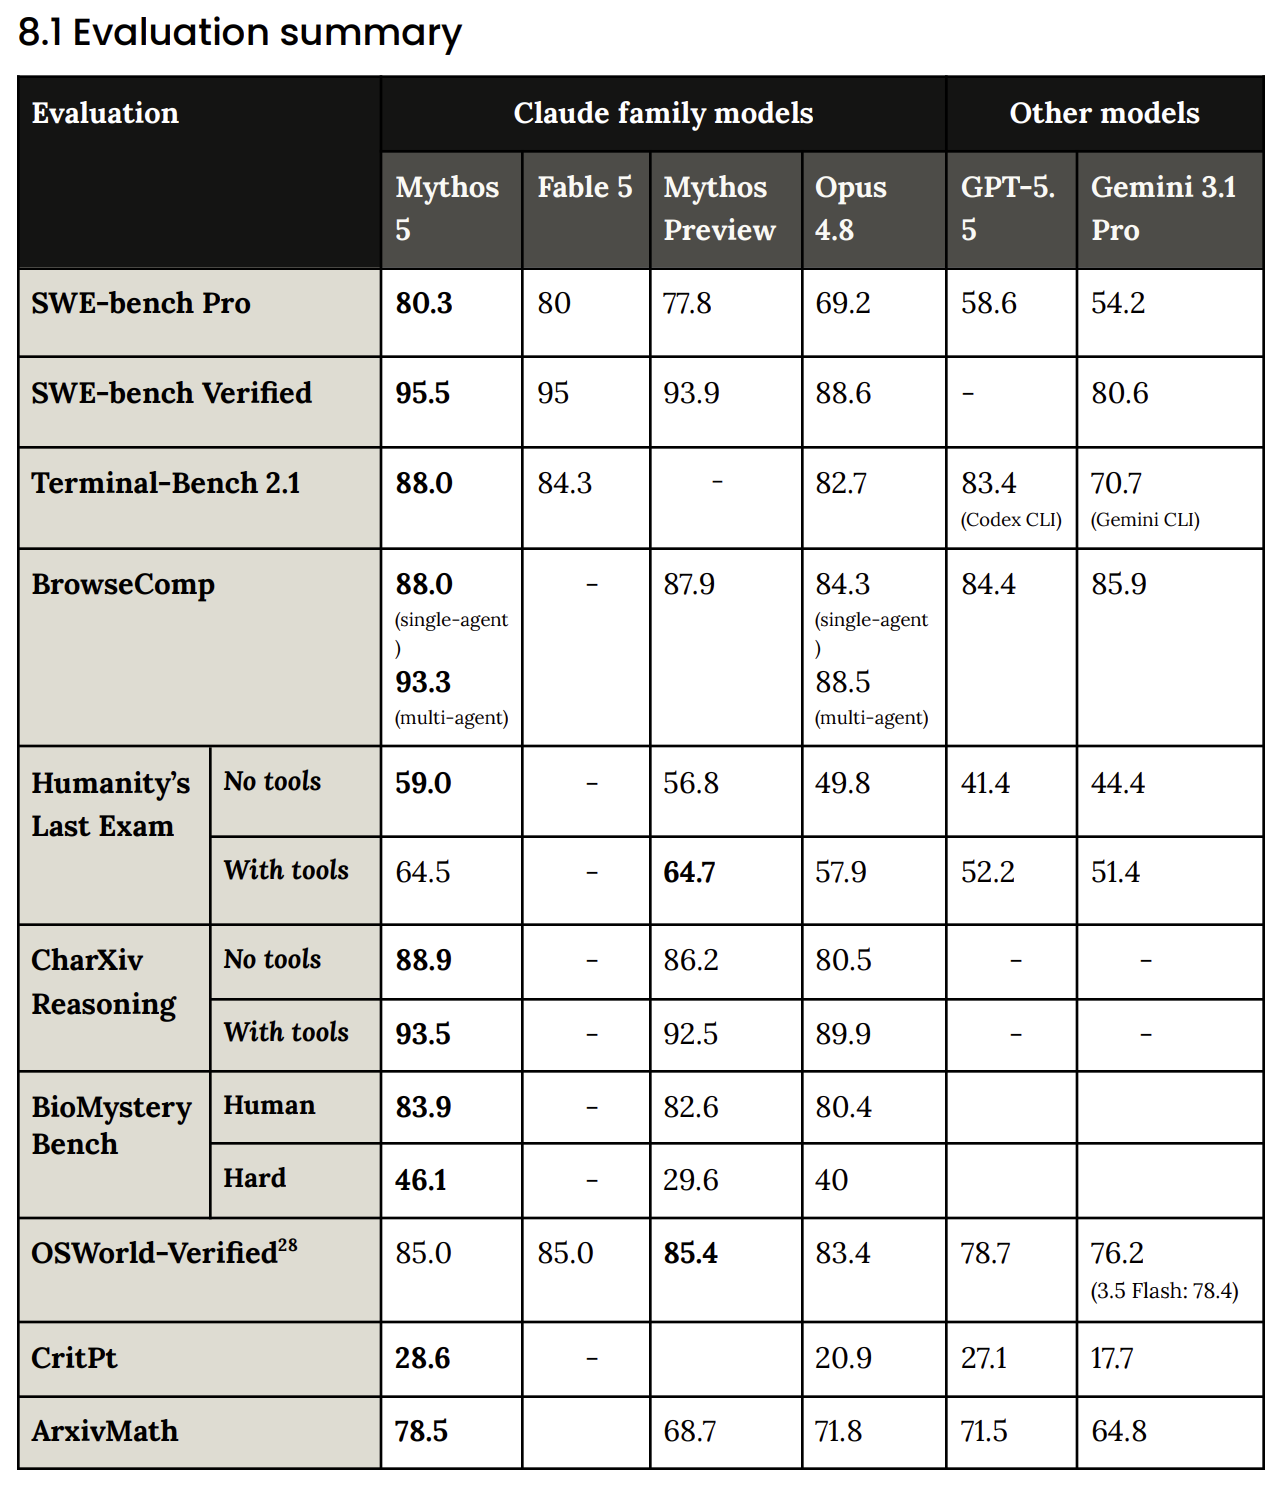
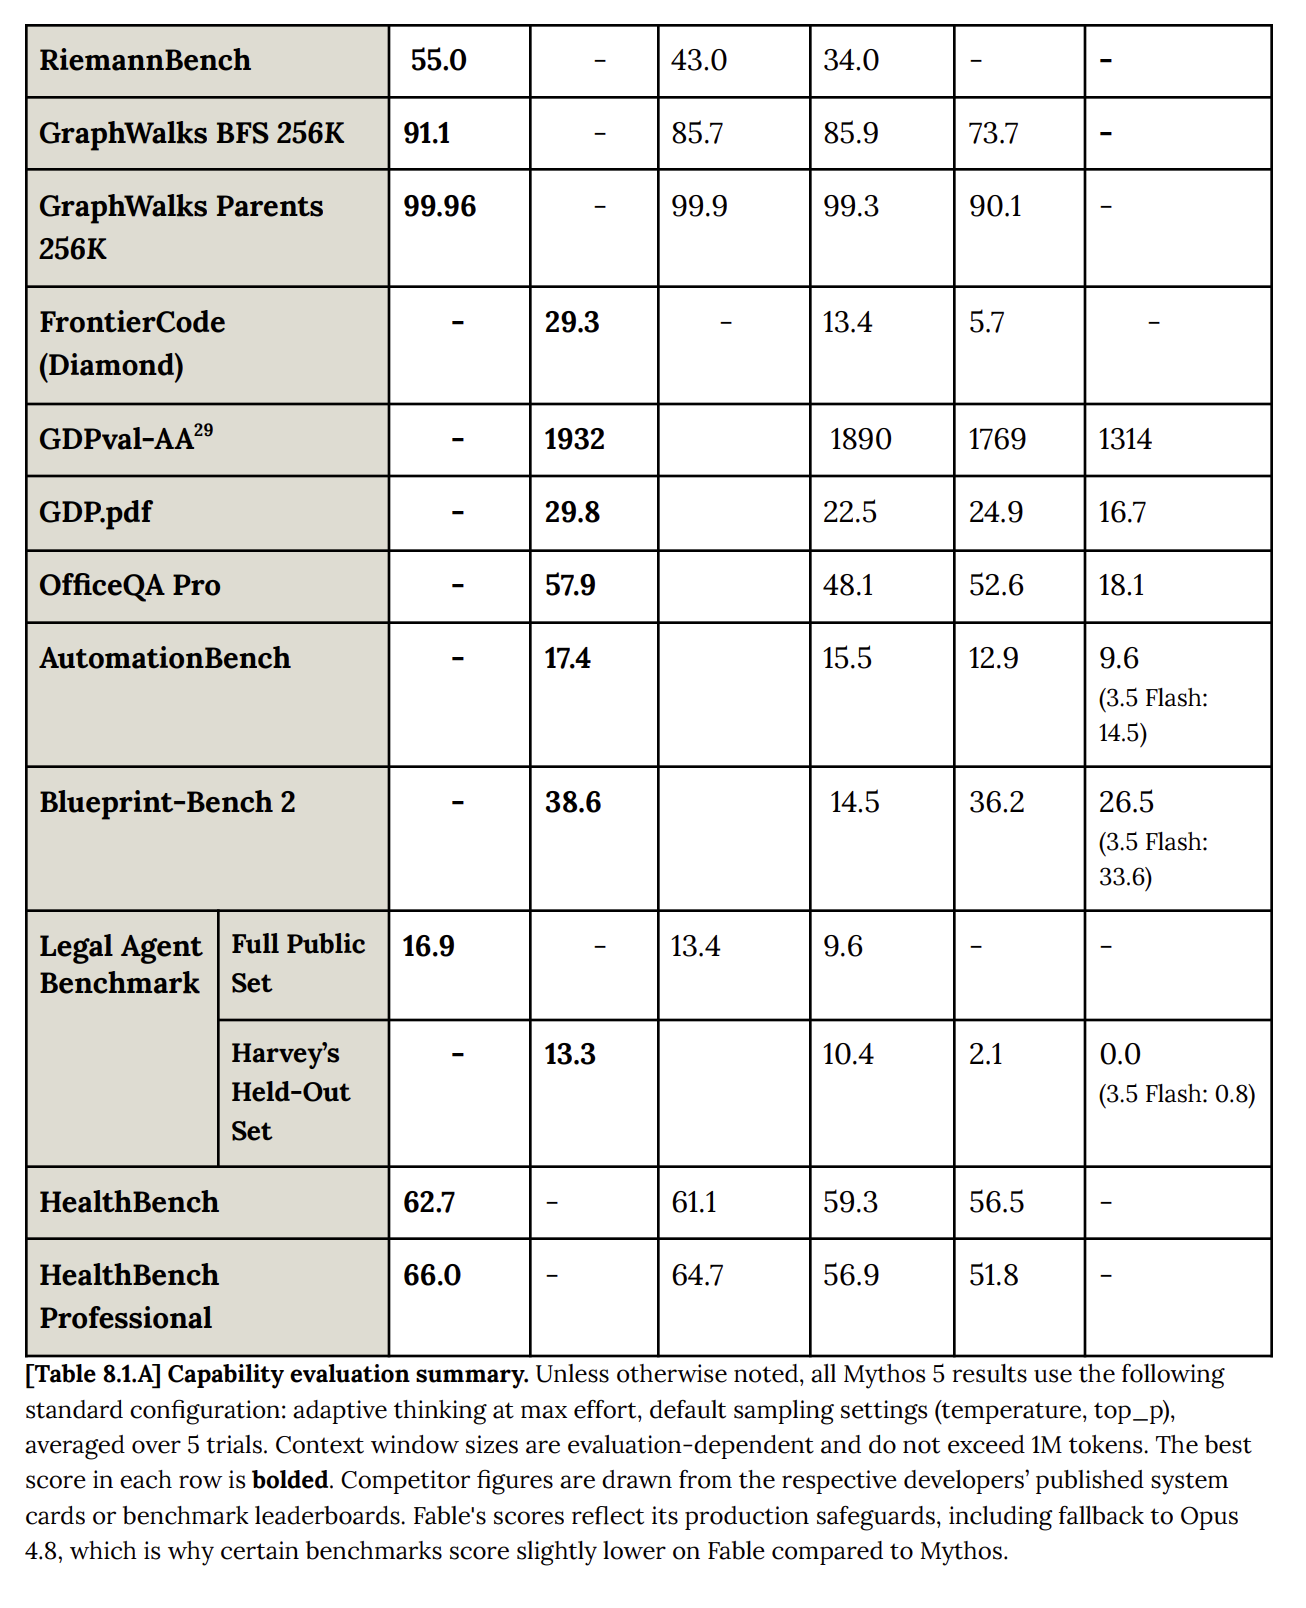
看小字,思考强度拉到了最高
感觉里面有一些数据应该是第三方直接测出来的, 不是他们内部买了API测的 譬如SWE-bench Verified和Gemini官网的数据是一样的,SWE-bench Pro和GPT 5.5官网一样
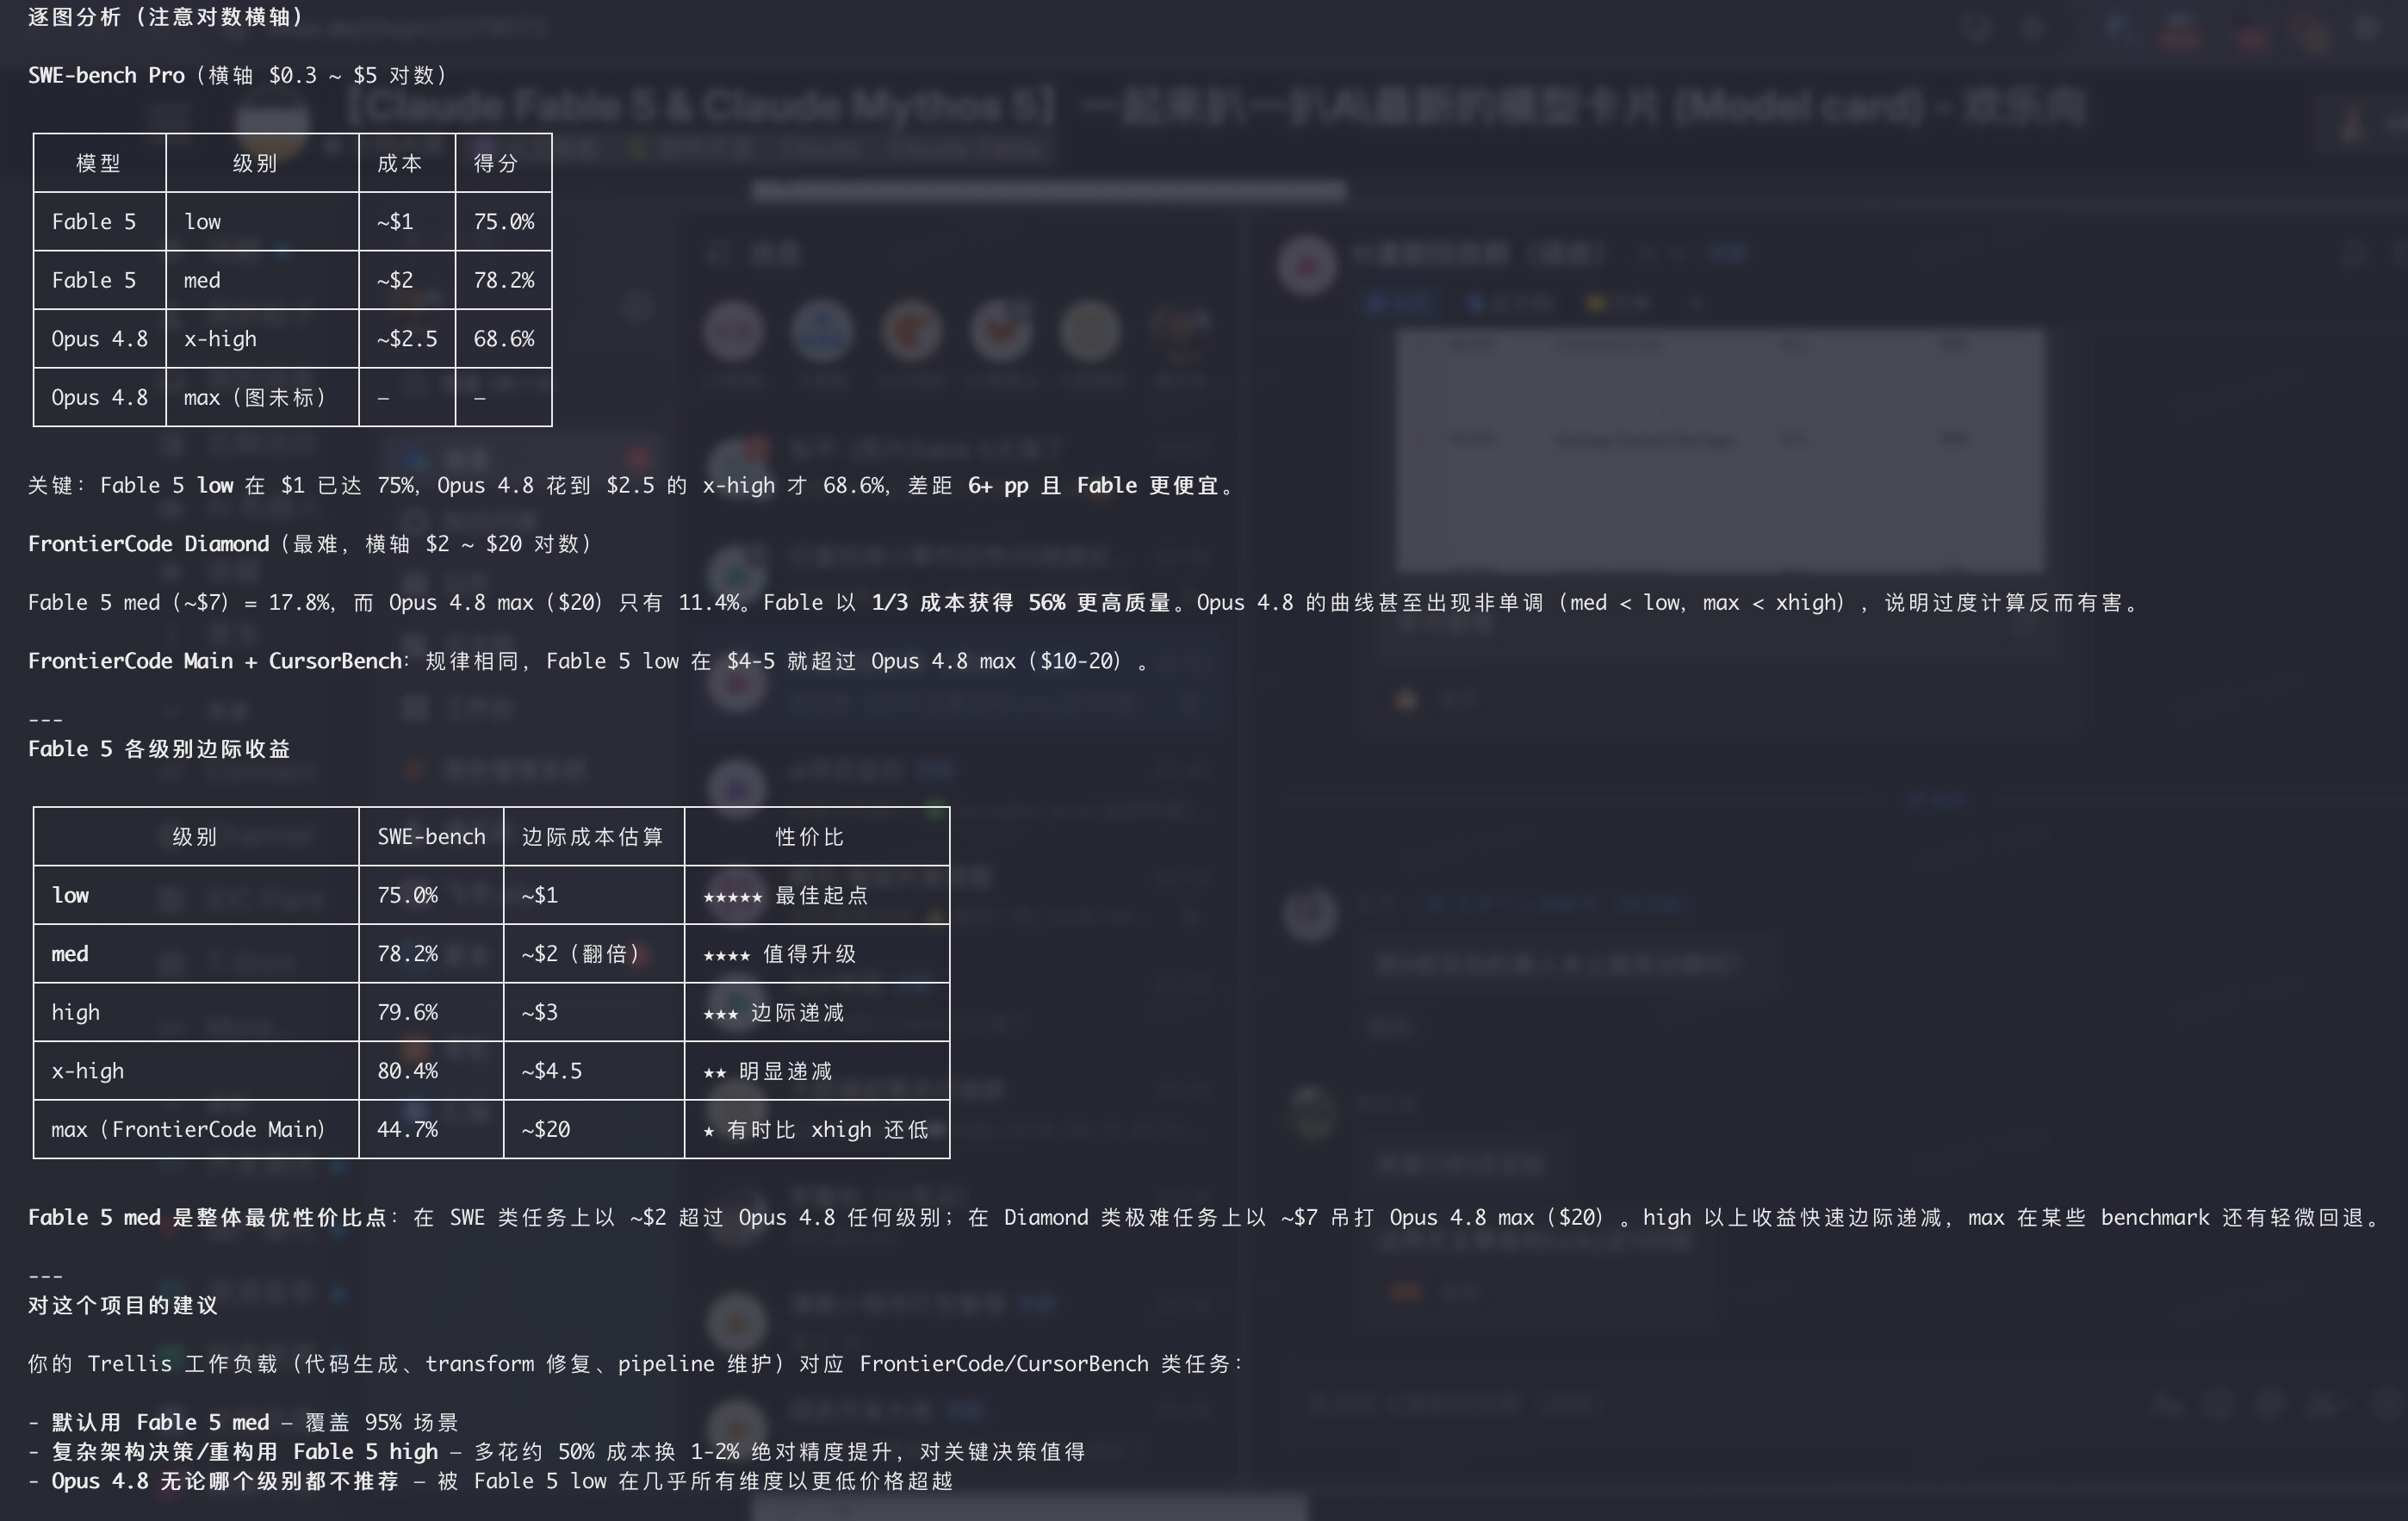
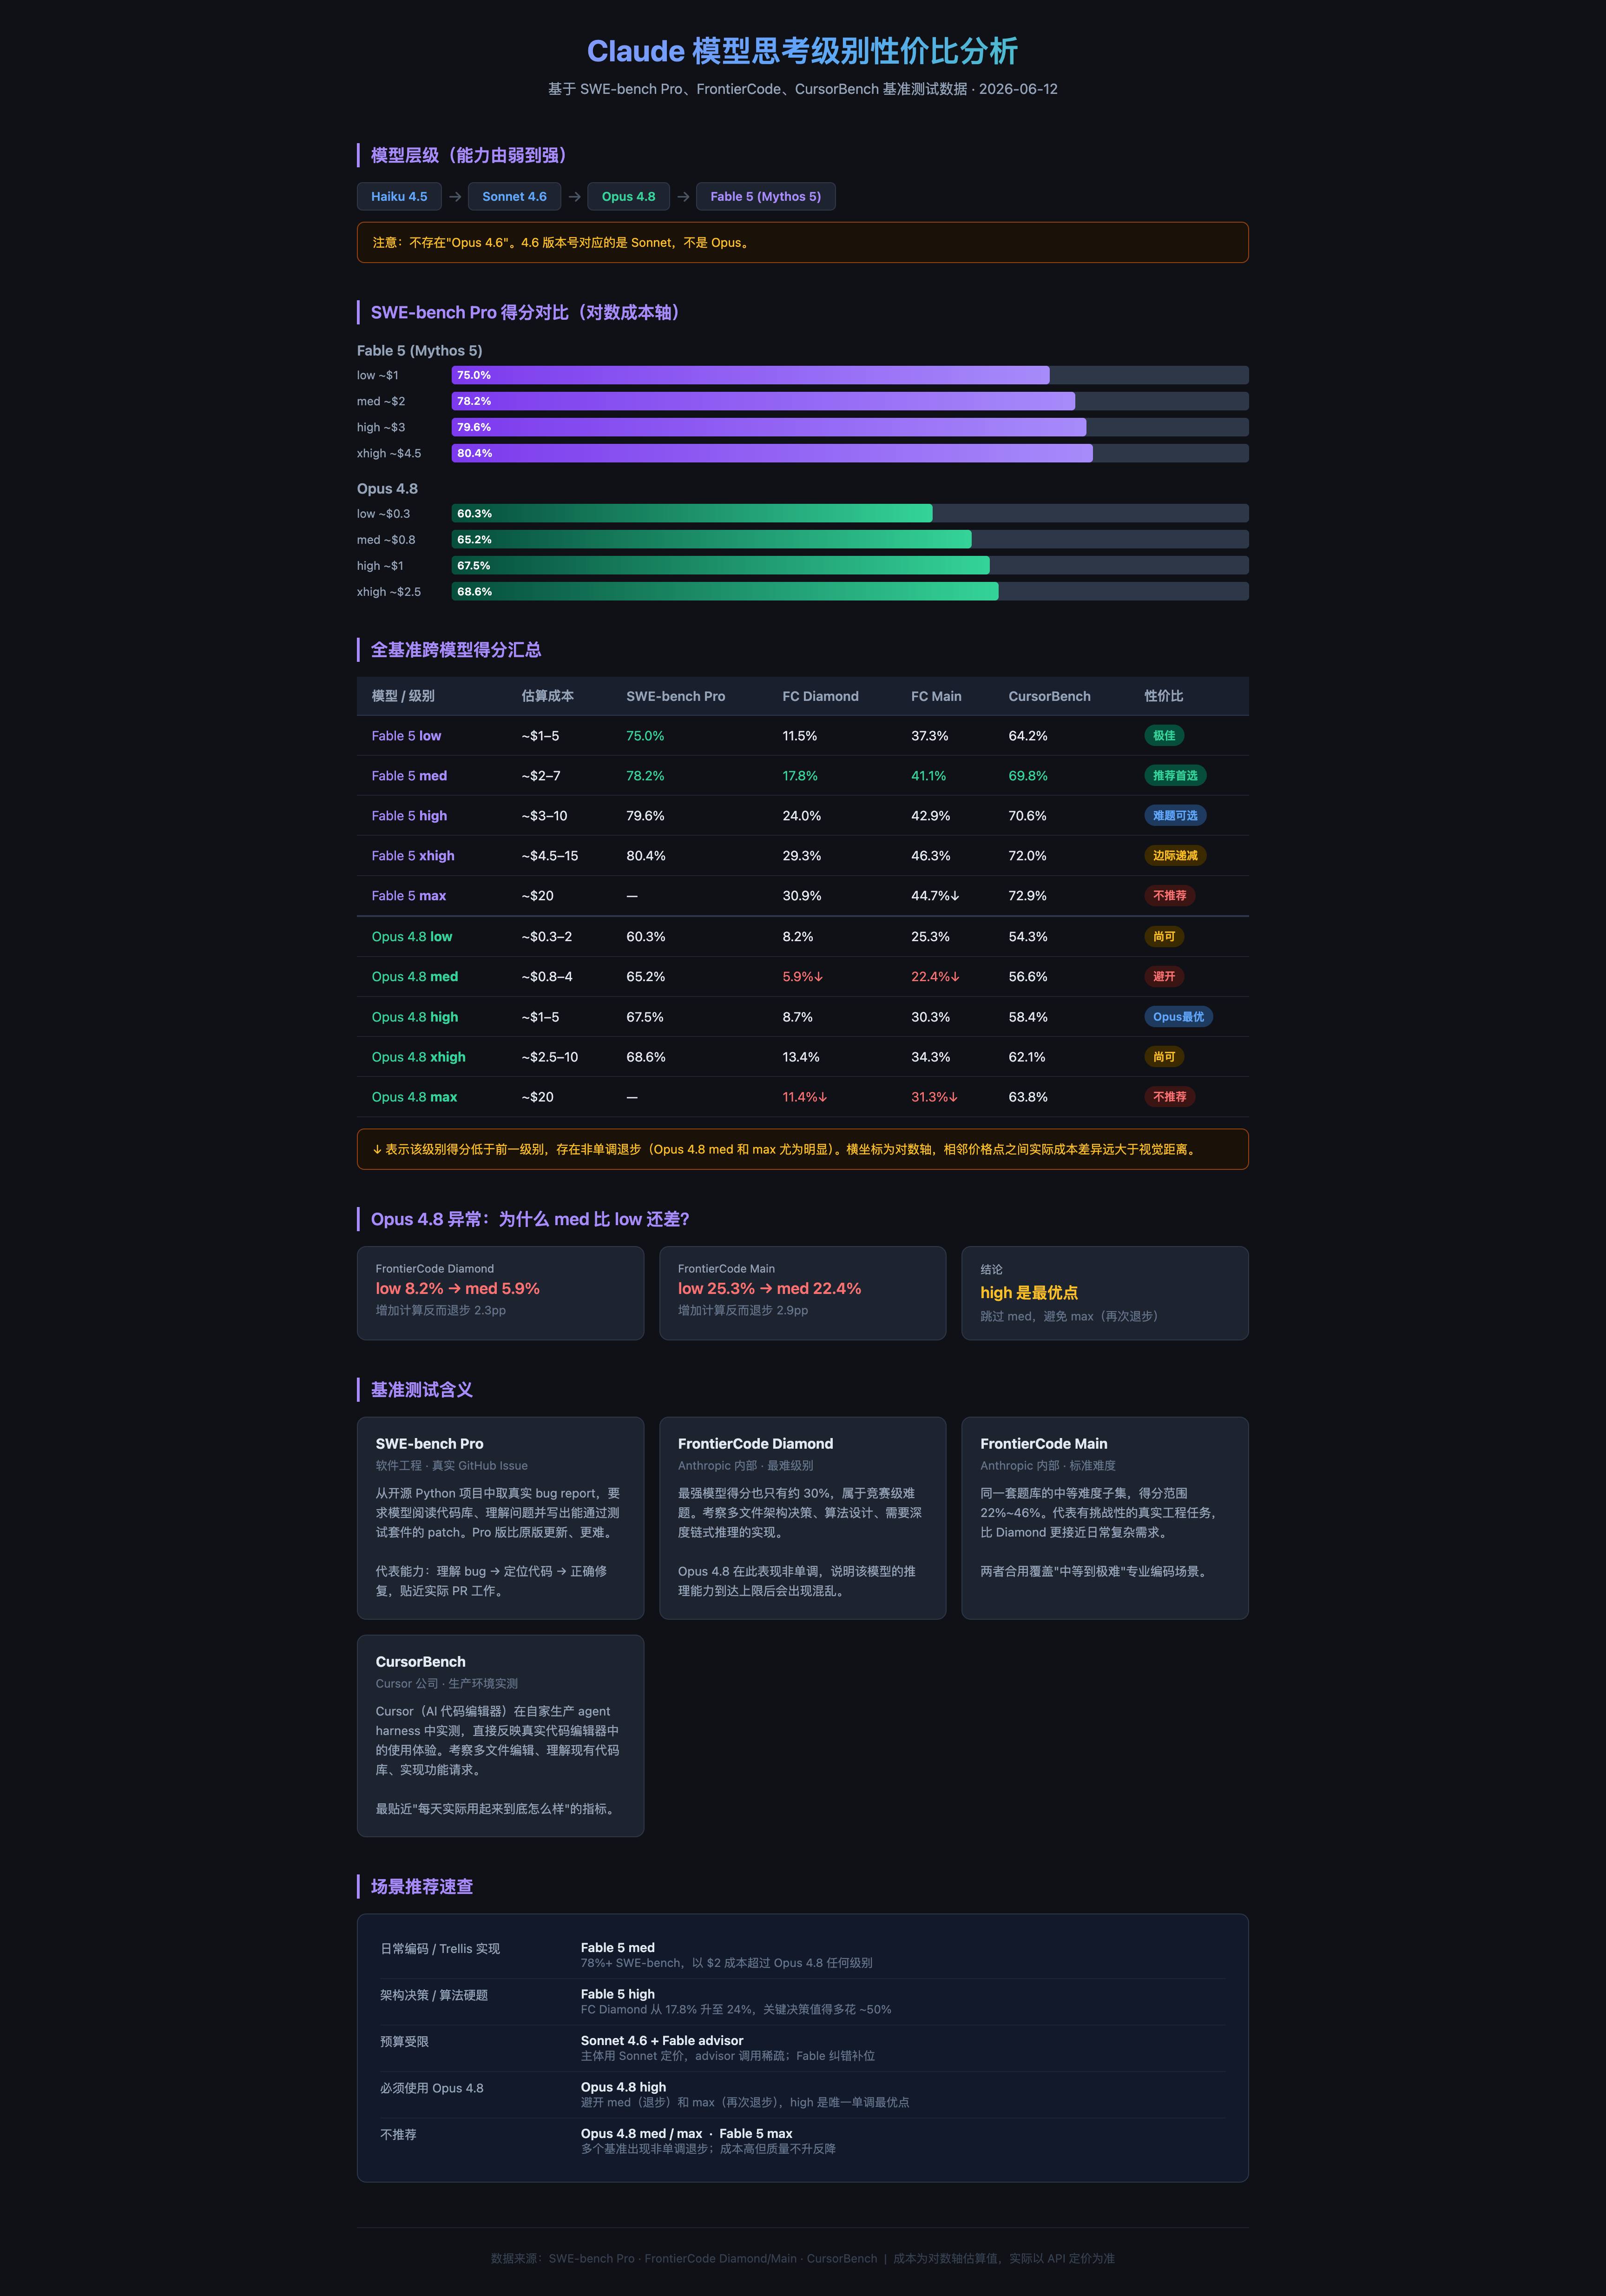
我们应该怎么选思考强度呢
大家注意看,横坐标它其实是加了对数的,所以说比对的时候要小心一些。
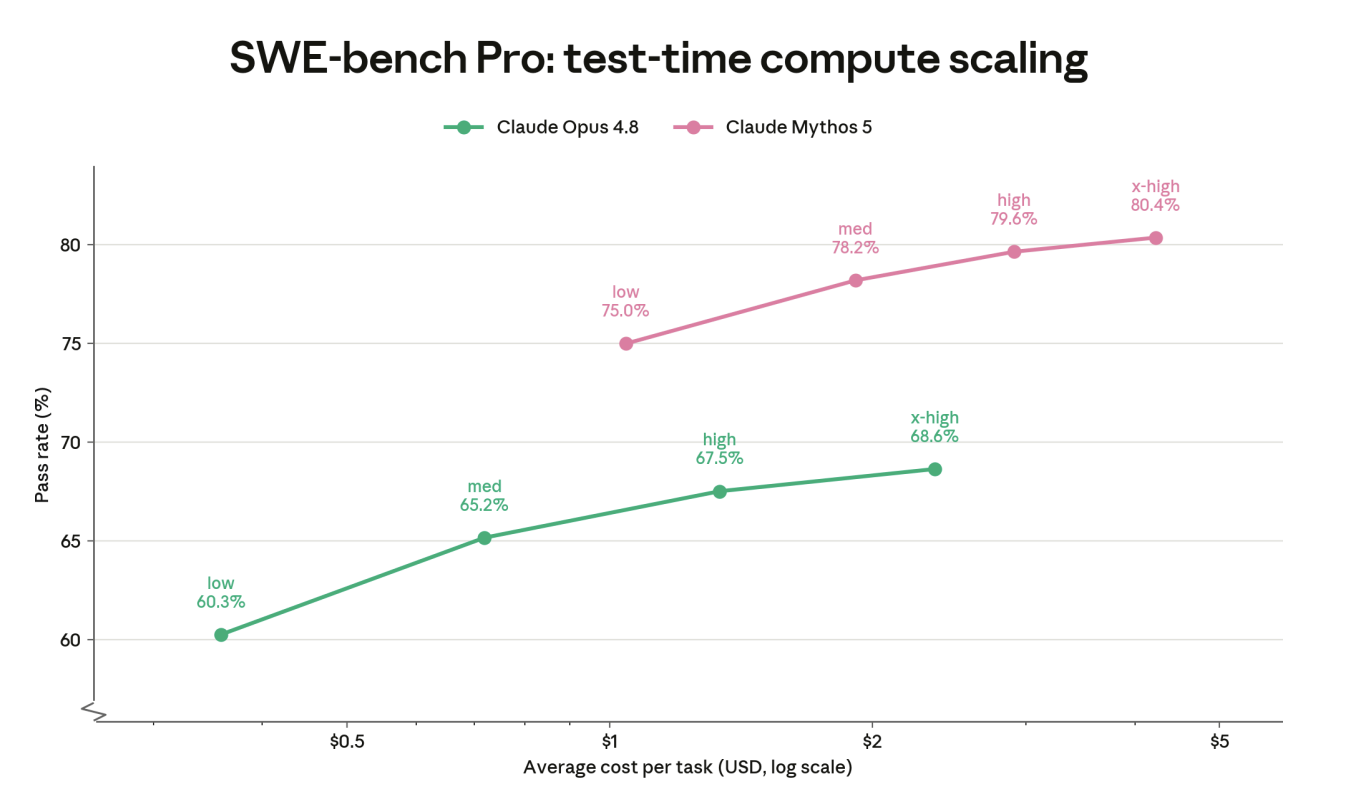
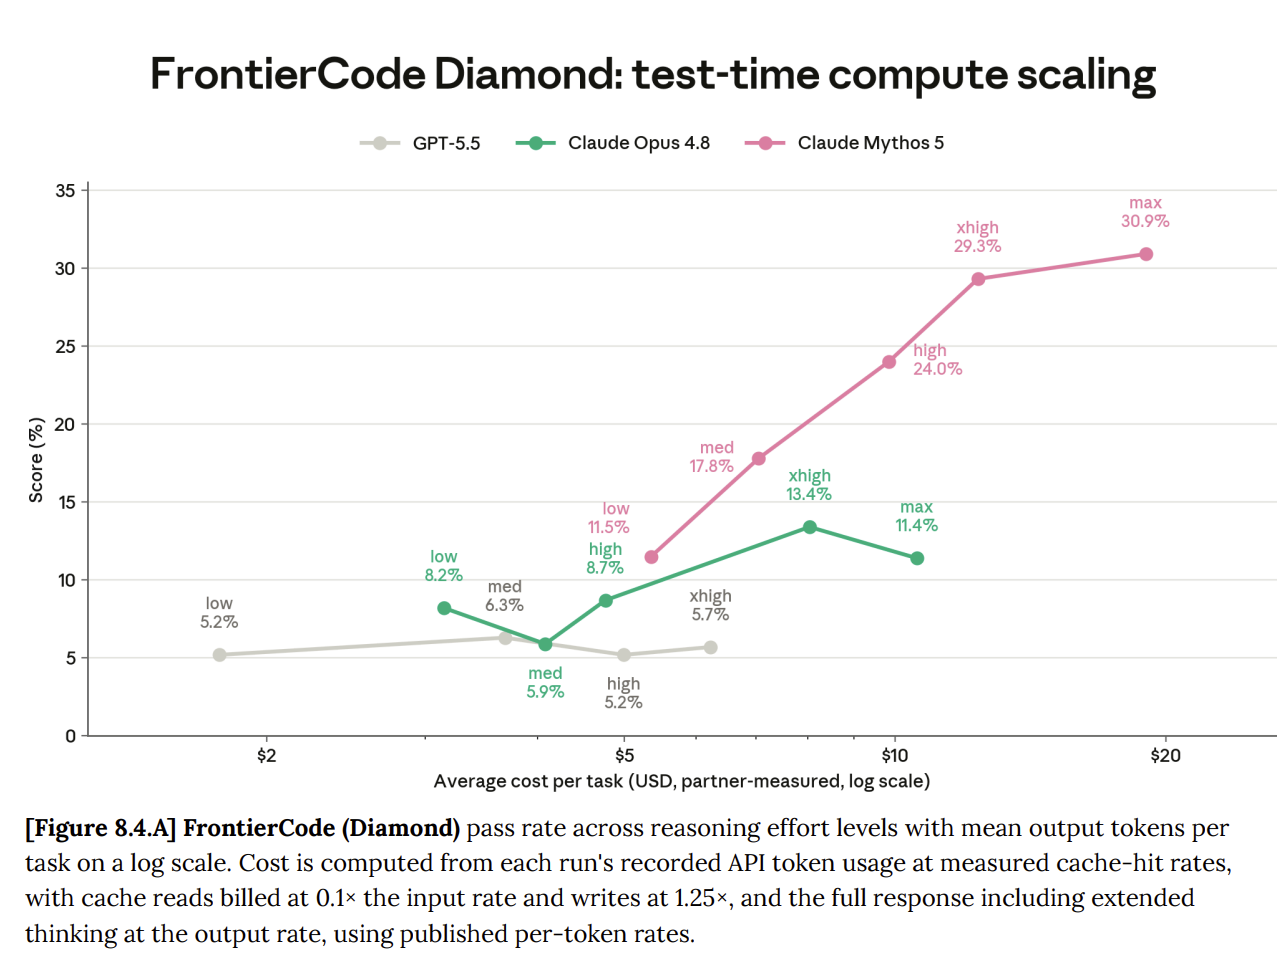


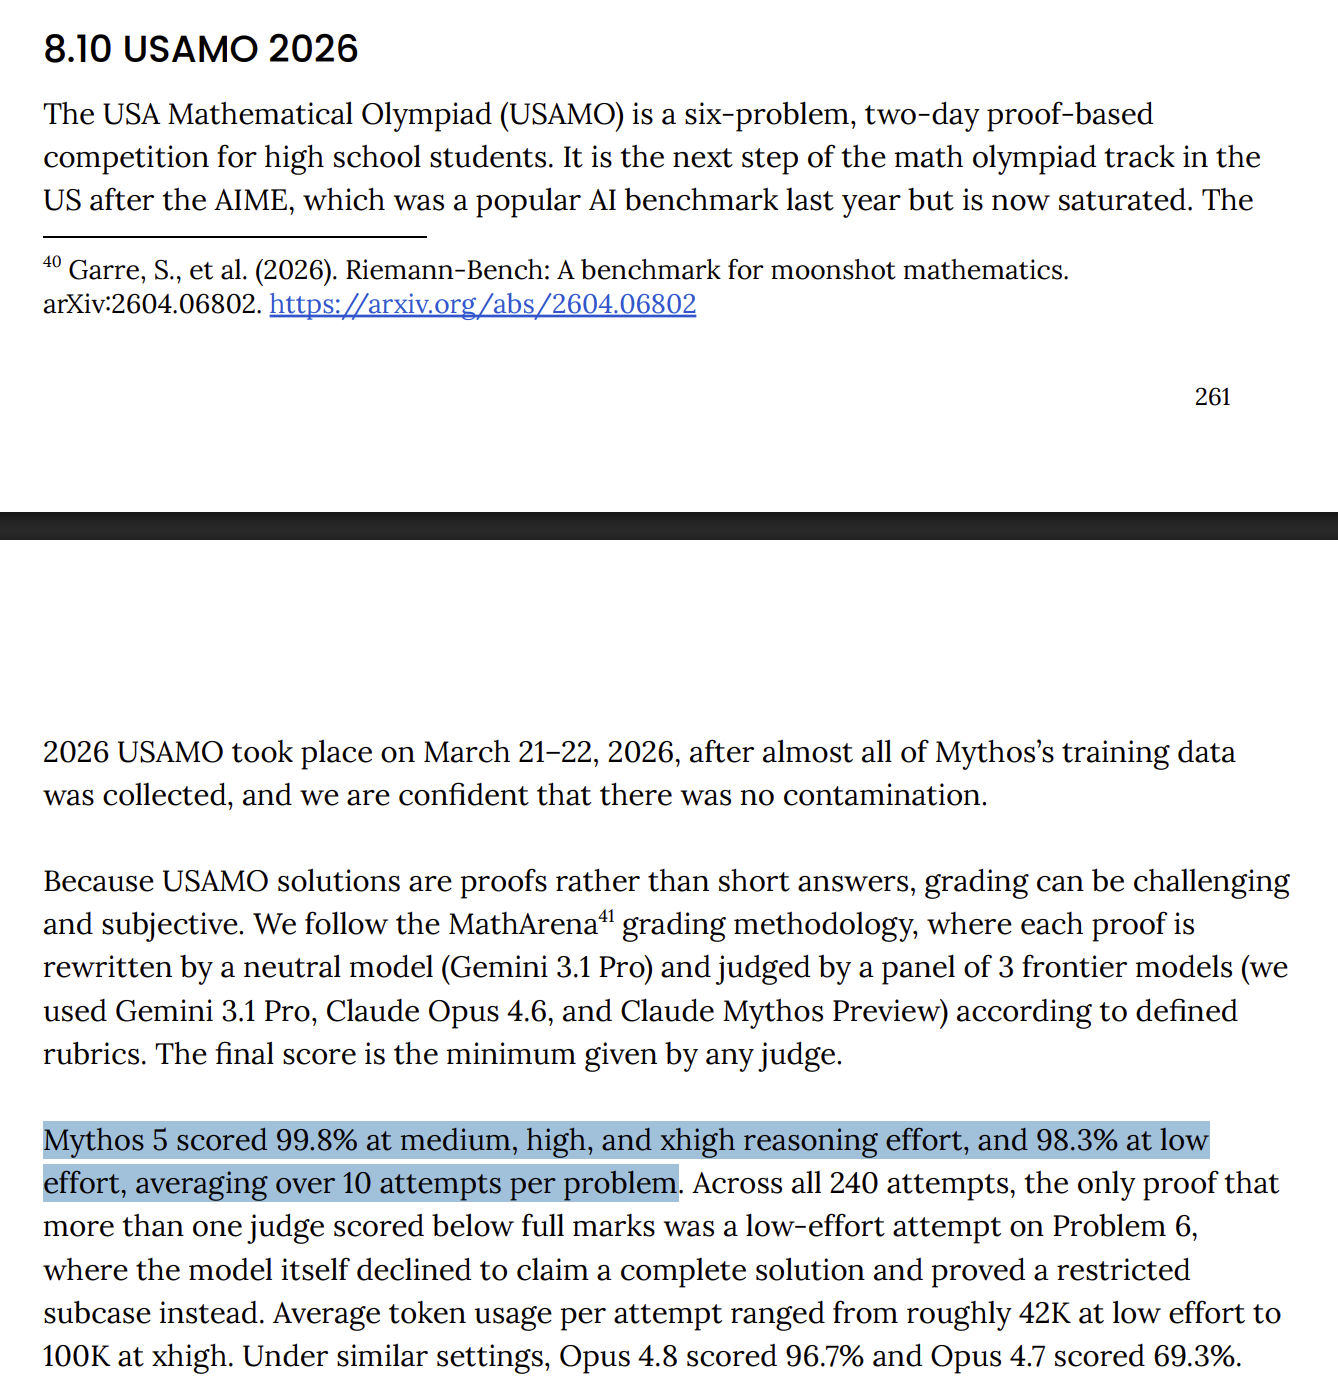
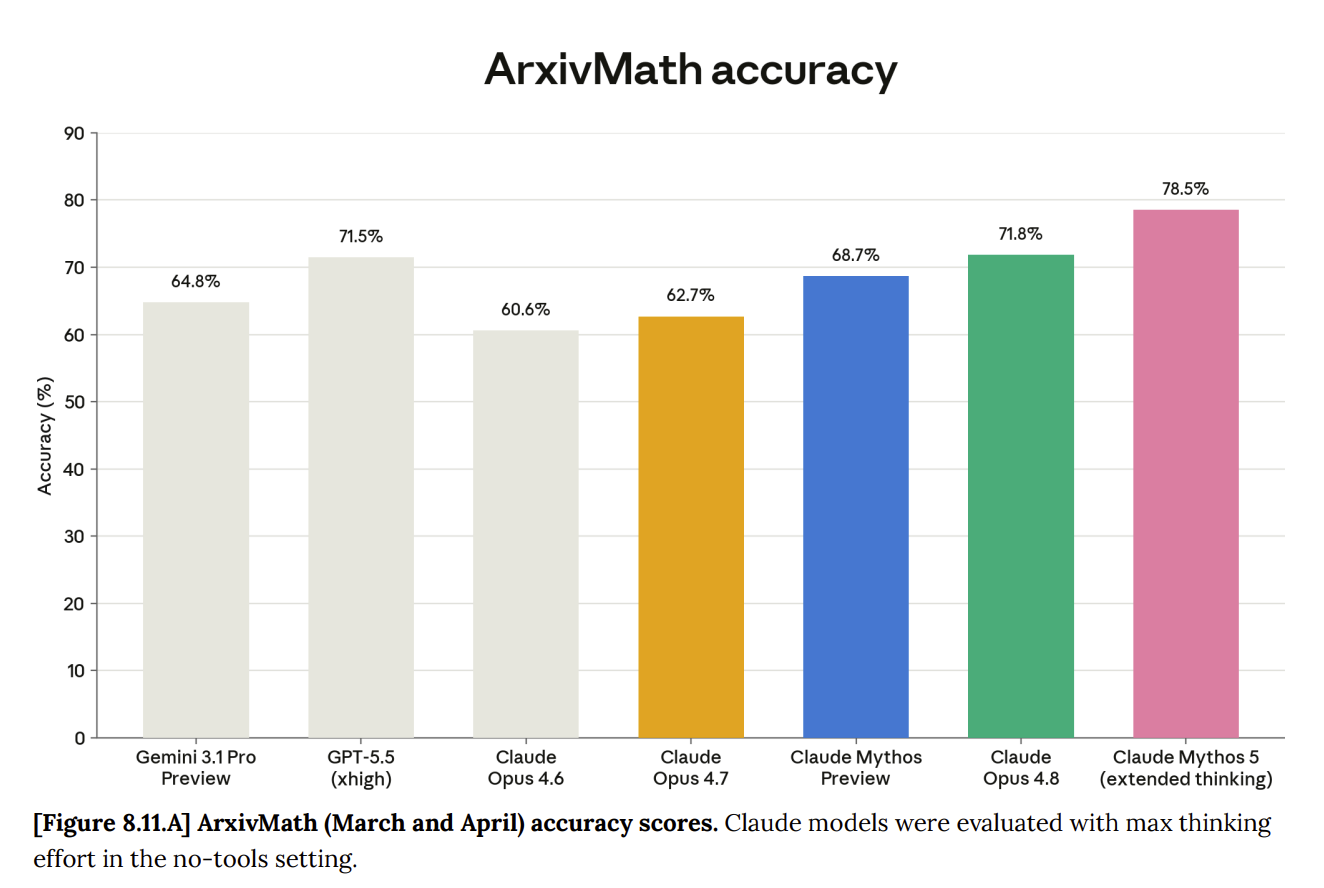
反正据他自己说,做新题、数学题是很强的。
Agentic search
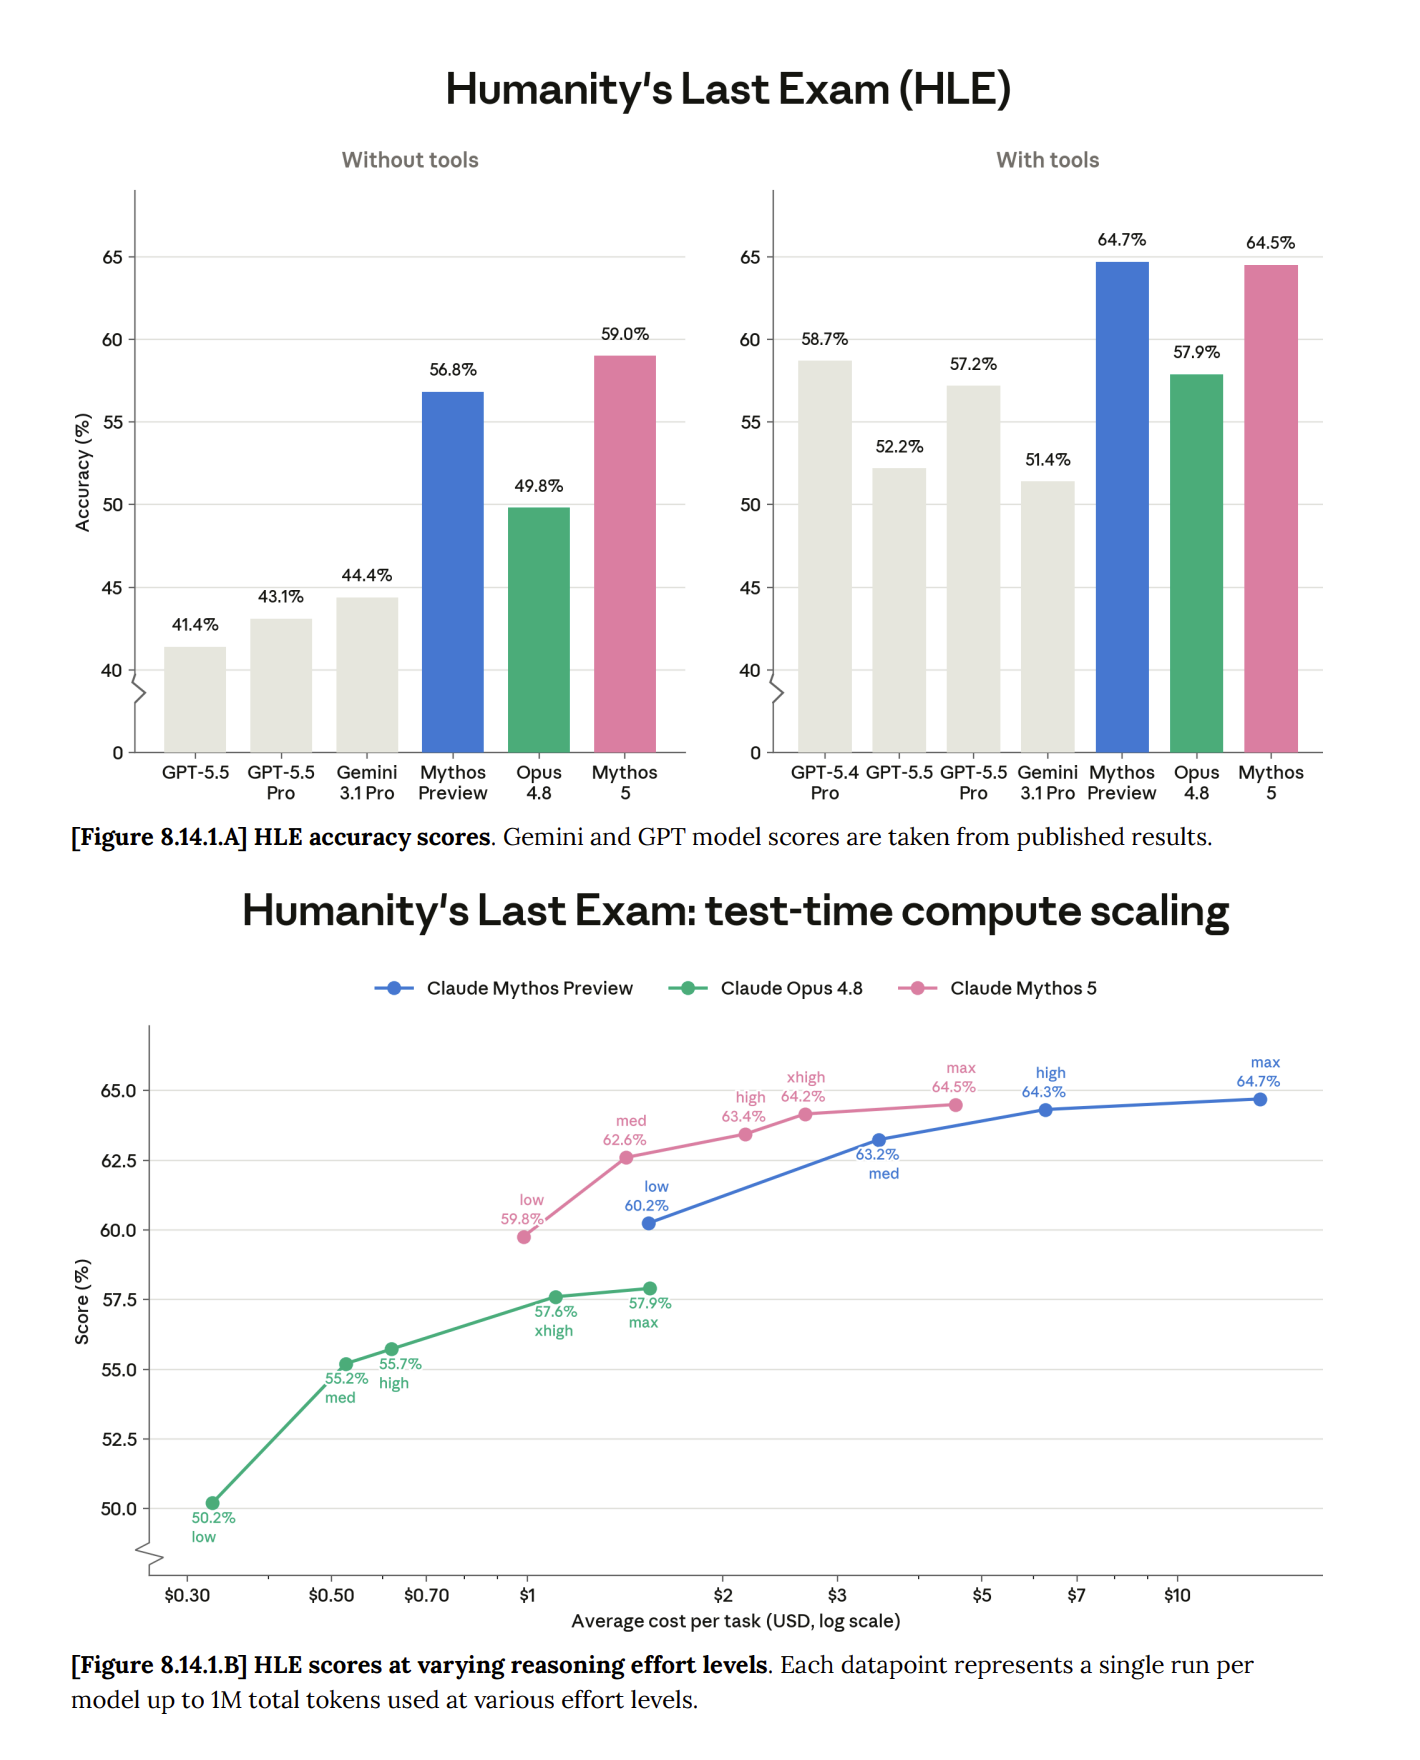
HLE 这里面放了花费,可以参考一下,感觉还是比较有价值的(都没有舍得用过max)。
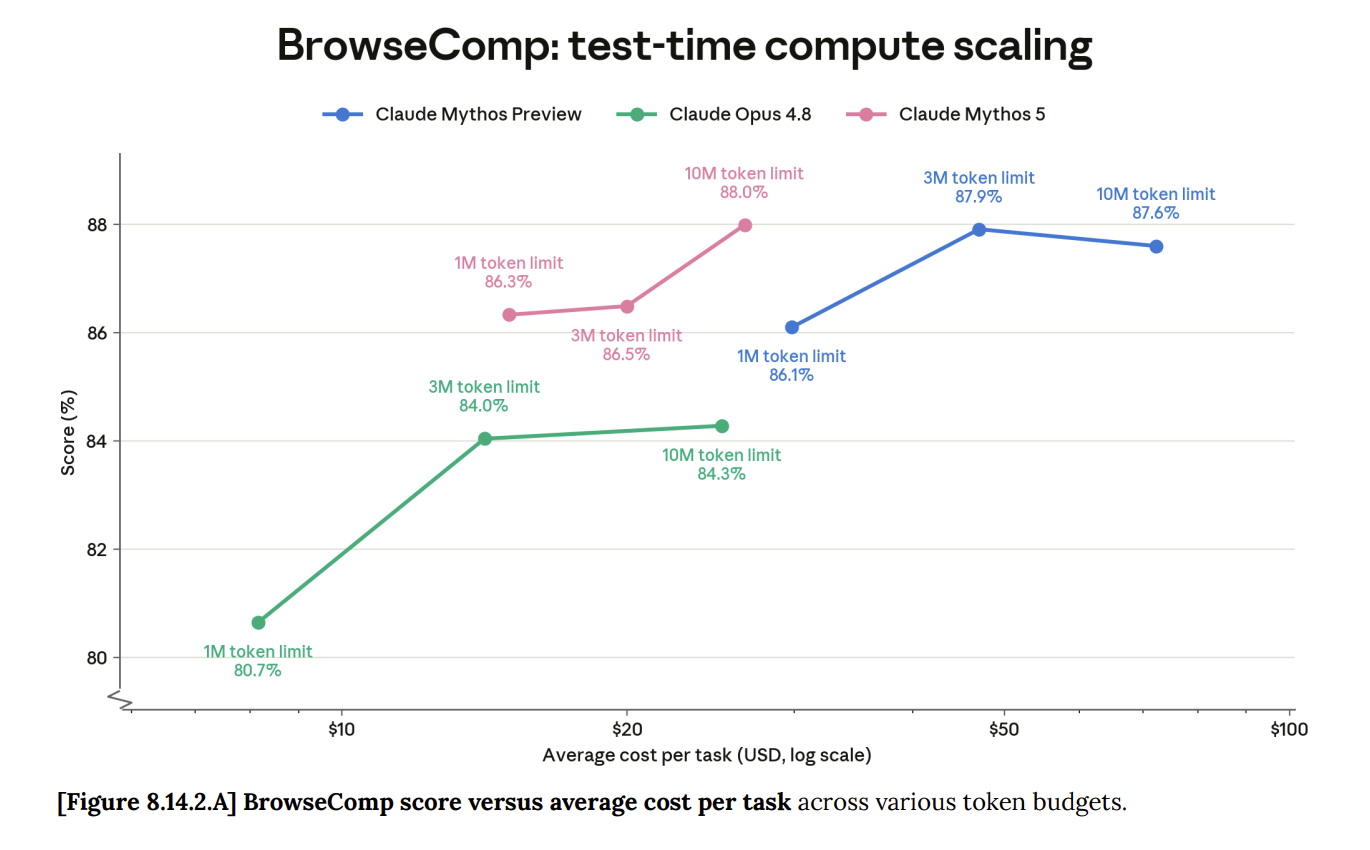
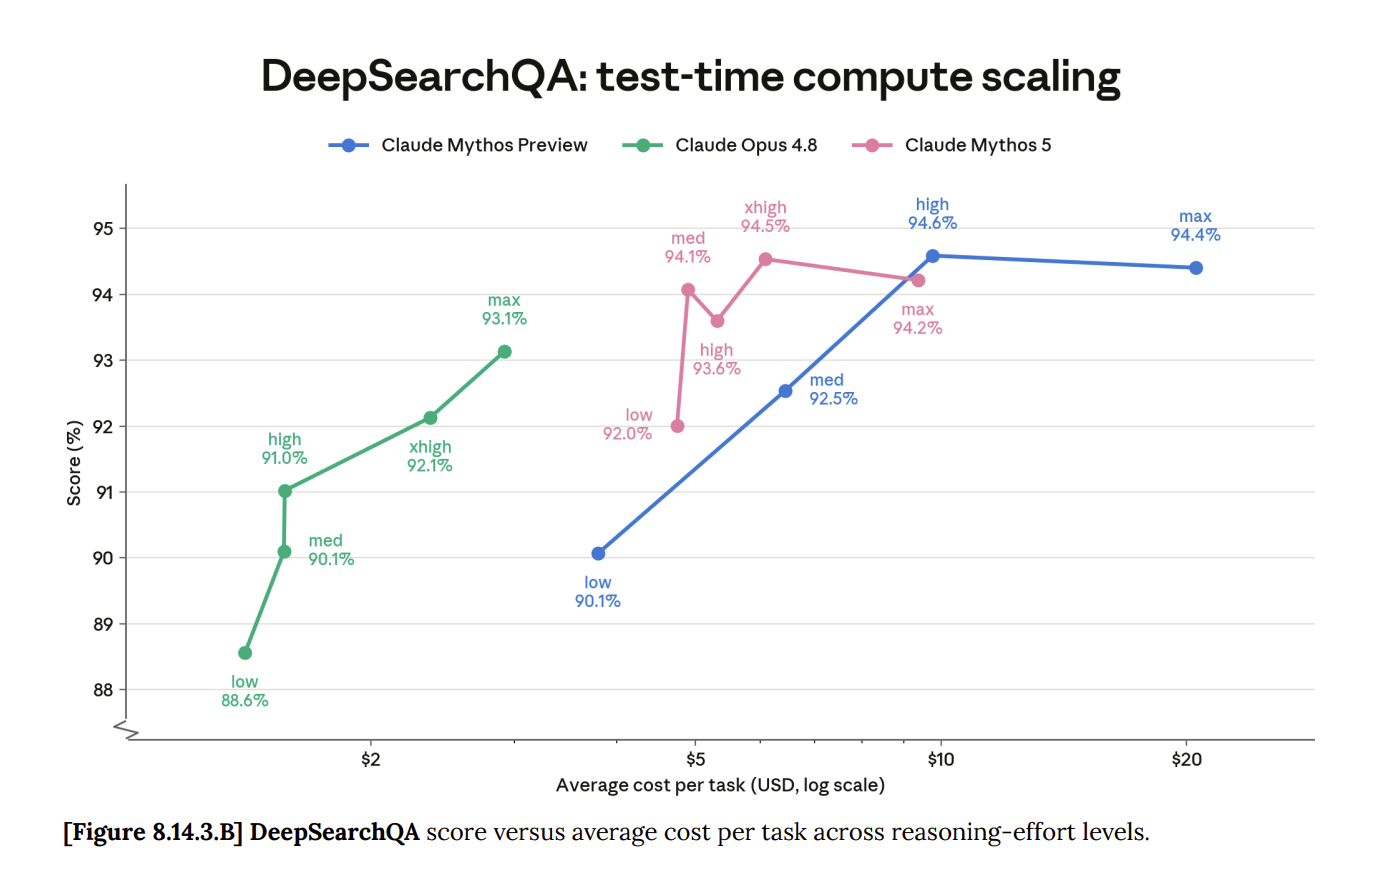
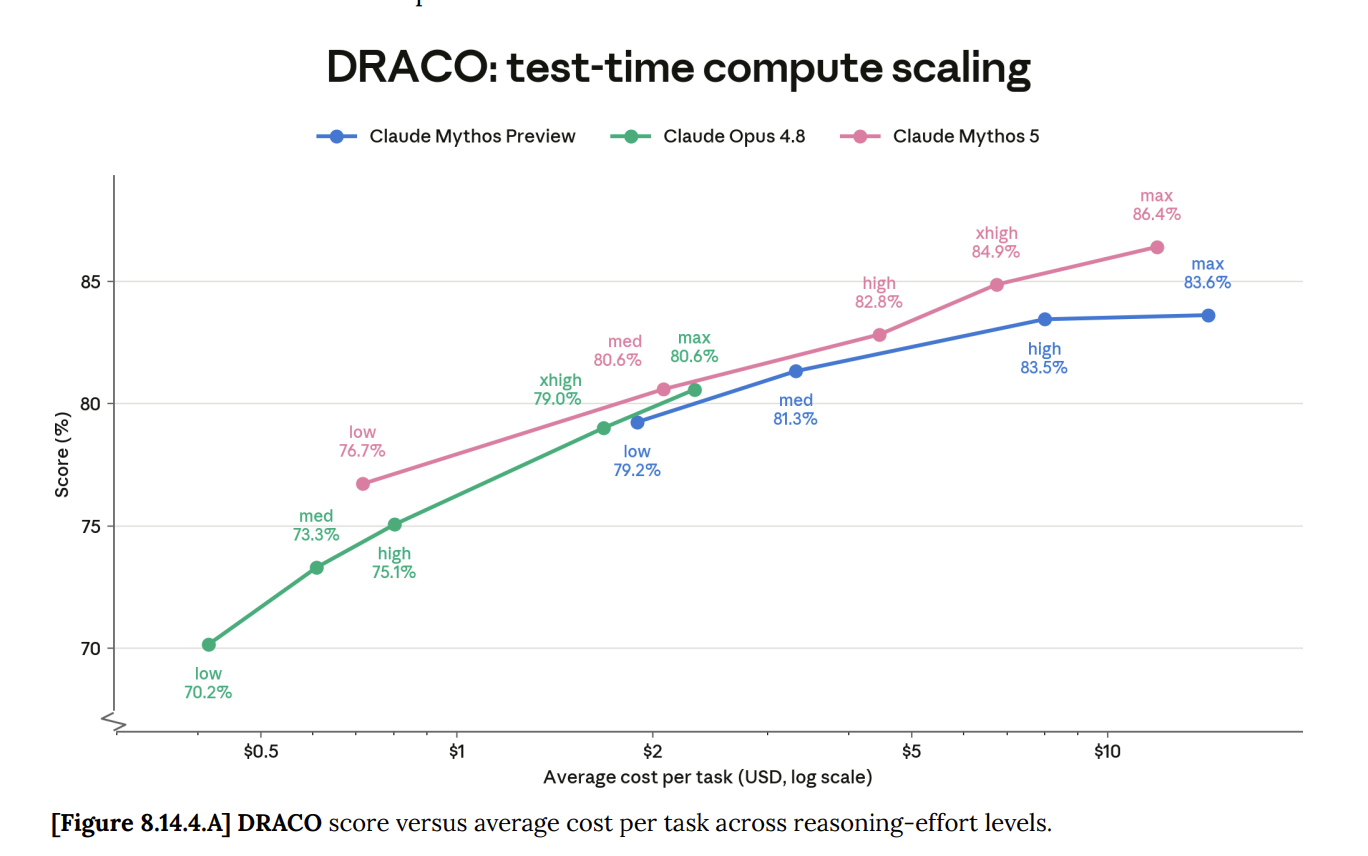
他自己测试的倒是挺全的(感觉和编码关系不大就不放了)不过可以看到有一些都已经快饱和了,看来该背的题都背的差不多了。
多模态
反正他自己说自己的多模态很强。依然是艳冠群芳的头牌。
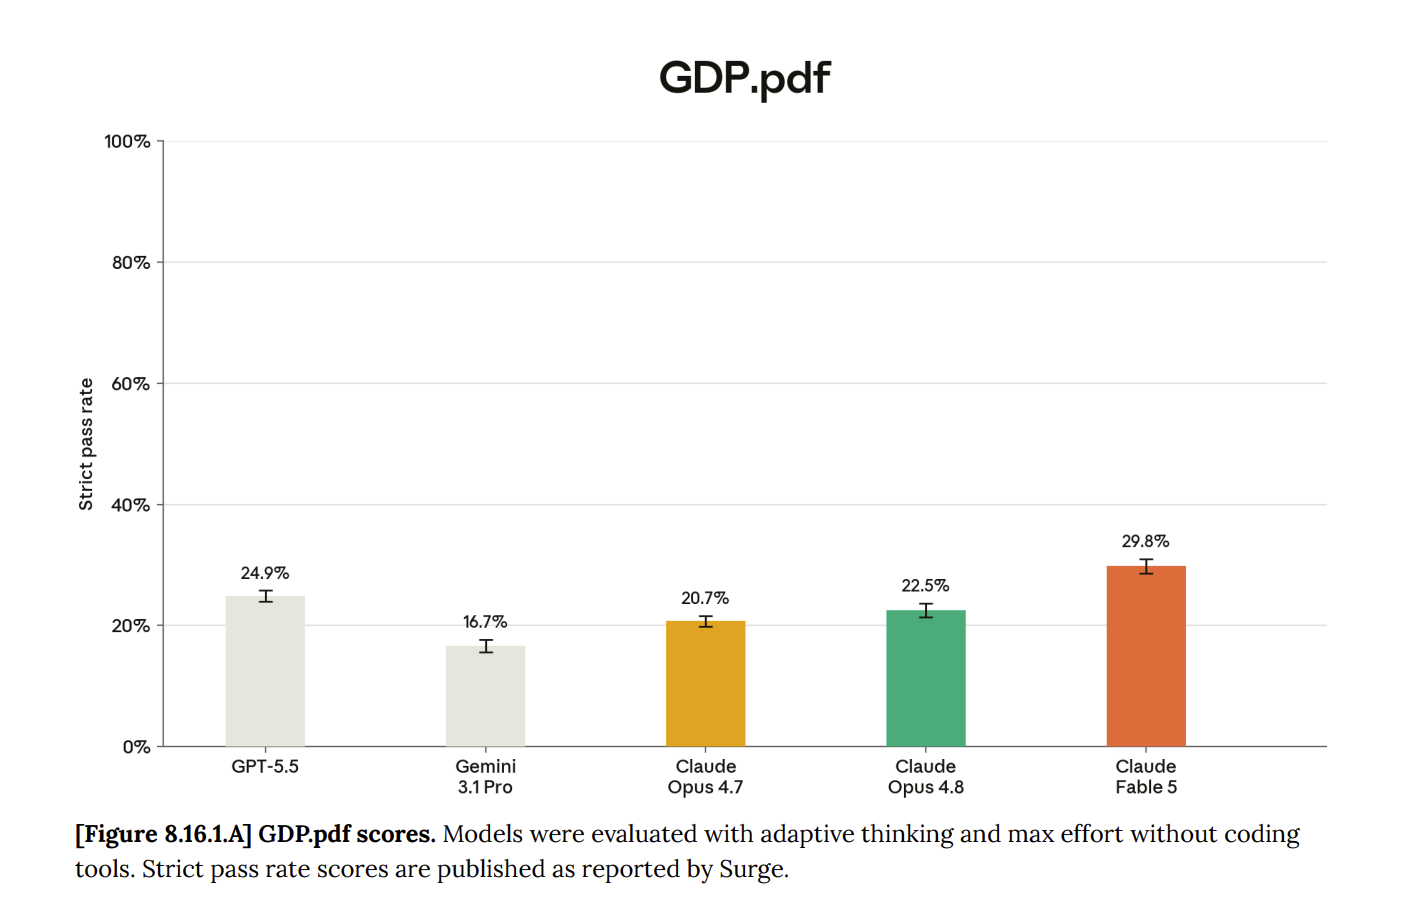
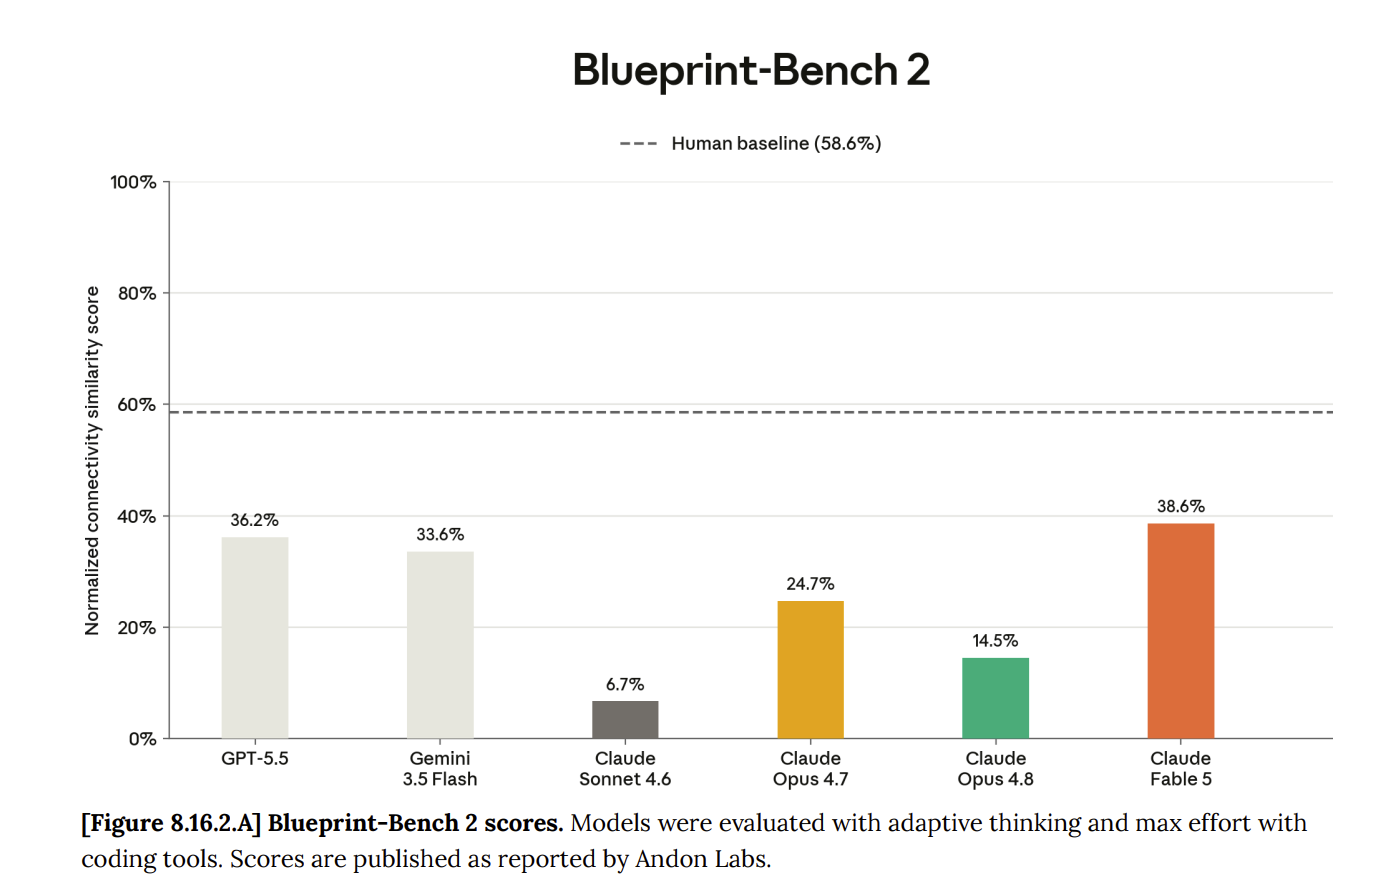
但是吧,有一些 benchmark 反而就不和别人比了,就只和自己比,所以说,呵呵。
生物和化学
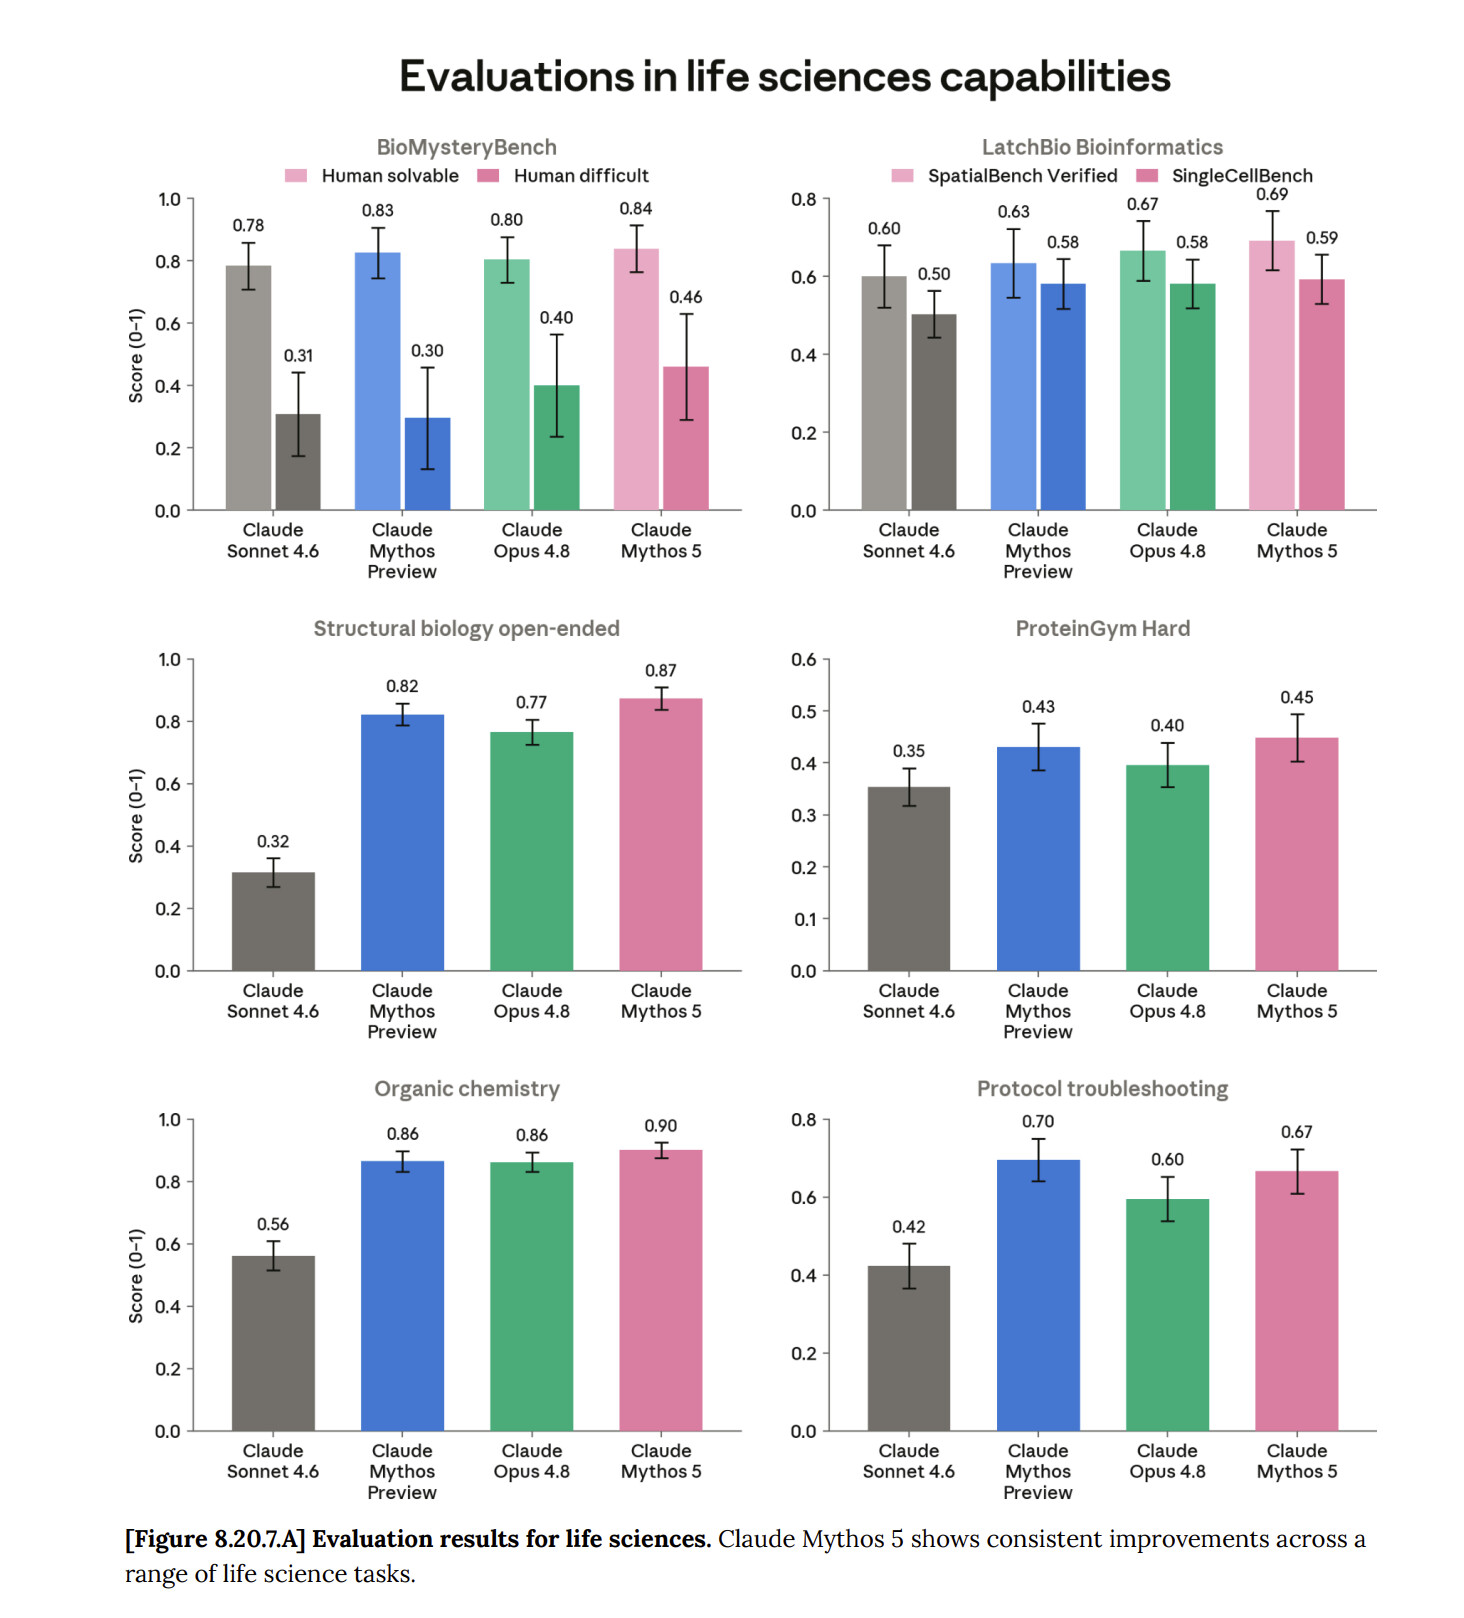
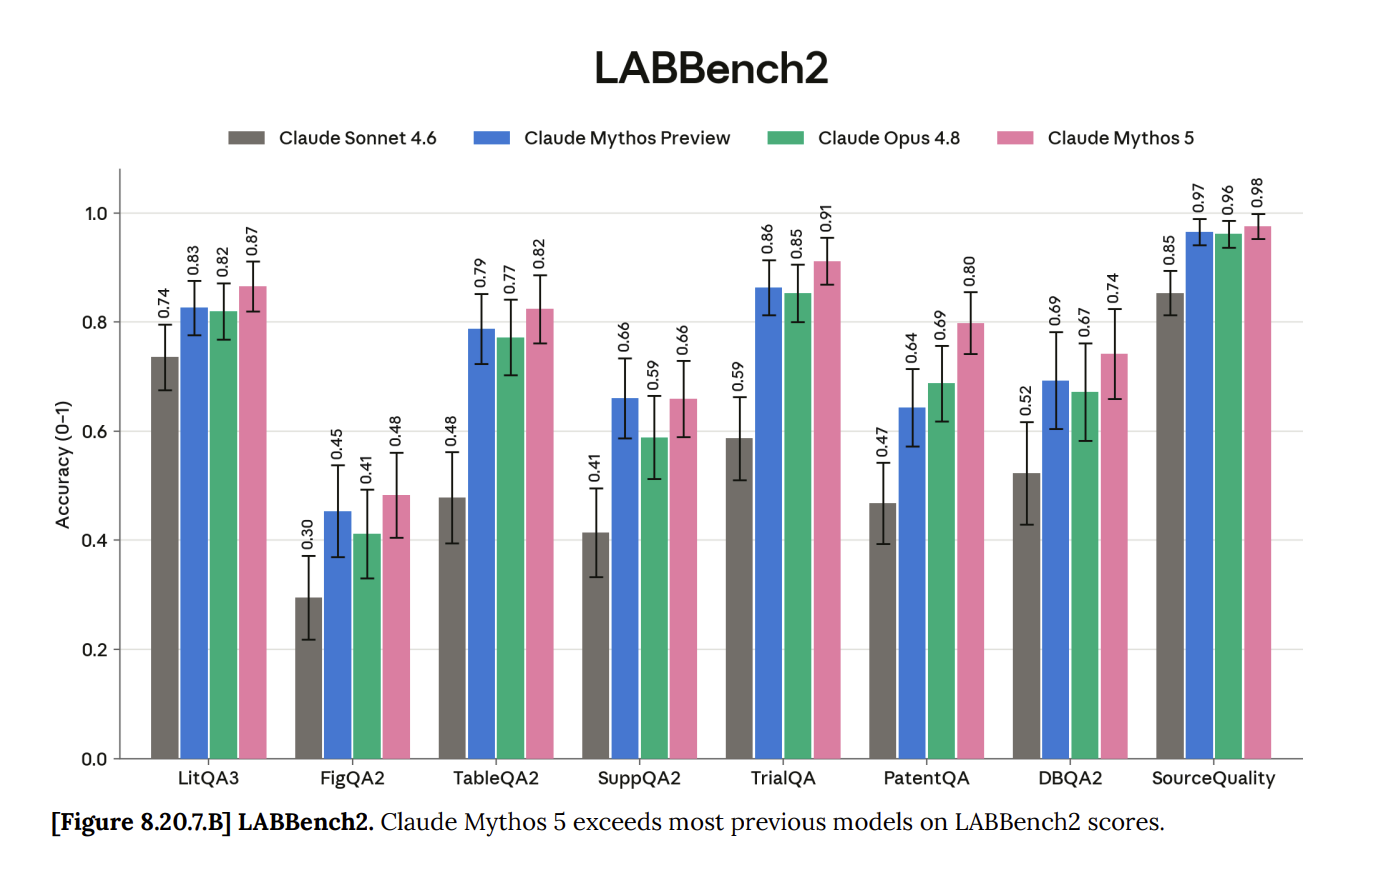
哎呀,生物和化学本质上是劳动密集型,人口密集型产业,好吗 怎么可能用得起Mythos呢?简直是搞笑!?
嗯,在模型卡片的边边角角里面,A\自己承认了模型到现在还是搞不掂SMILES。InChI 估计也呵呵哒。。。好像回归了老本行。之前带薪评测过去年中的SOTA, Gemini2.5 pro很强
To Be Continued
anthropic系数随A\的道德水平动态灵活调整 ↩︎