求GLM 5.0以上版本在消费级显卡(16G显存)部署的可行方案。
5 Likes
你这也太夸张了
没这样的技术啊 
能部署也是流口水的啊
2 Likes
应该只能用量化版本的吧,用起来体感估计不如api吧,glm有没有量化版本也是问题
有相关量化版本的部署教程么?求教
消费级多卡显存够还能勉强跑跑,16G单卡主流量化微调模型都费劲的
有的有的,github搜JustVugg/colibri
1 Like
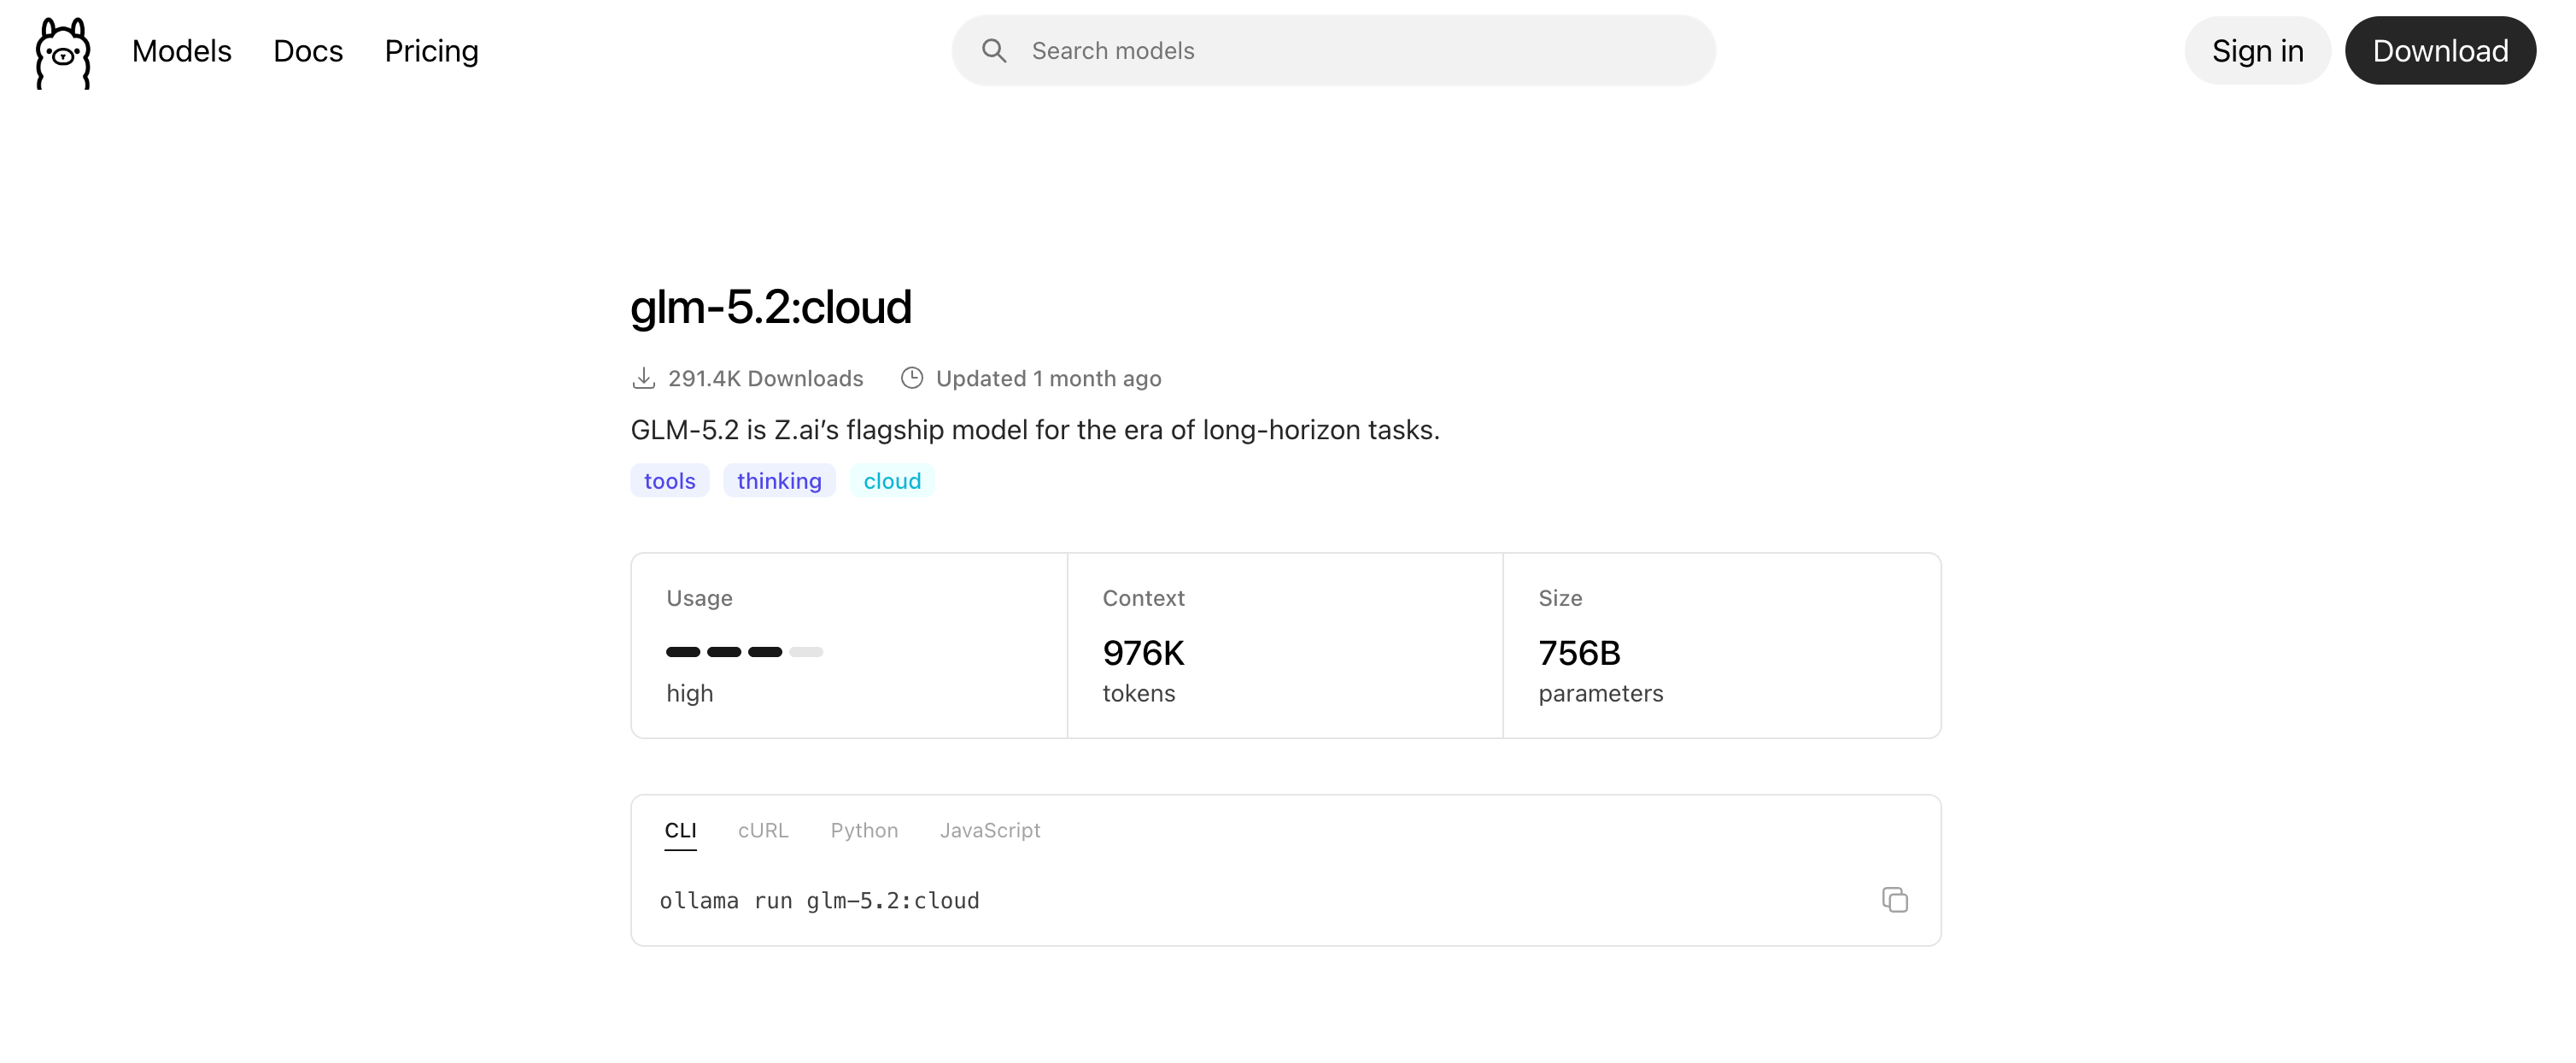
看看 ollama 里面能不能找到量化的模型先,如果没有 ollama 就走不通
1 Like
只存在理论上的可能
实际上是根本用不了的, 因为出字太慢太慢
1 Like
你不会是想单卡16g显存跑glm 5.0吧
glm5.2发布的是未量化的版本吧,感觉就他家直接全盘托出了。。
差不多 20 多 second / token 吧,注意单位
7 Likes
我记得kimi-K3好像倒是有个c的版本,至于token速度嘛,好像是33s/token
3 Likes
方案很多,有内存的和硬盘的,但是别人 1s 几十 token ,你跑起来 1token 几百秒,没啥实用价值
如果能再加点钱,让 GPU 能装下激活参数的部分,可以看看 ktransformers 或类似方案,这种速度 10token/s 应该是有的
找q1量化,然后找能兼容的混合推理方案
极低性价比,16G弄个qwen3.6 MoE的混合推理都好用很多
的确,只能等能打的小模型出现了。企业信息安全,只能是使用私有部署的模型。同时兼顾性价比
可以看看下周的 qwen3.8 27b,这个应该有惊喜
另外 GLM5.2 Q2 极限量化版本 + llama.cpp 我在 4xA800 80GB 上试过了,245GB 权重,剩下的给 kvcache,tg 其实还行,10~20 是有的,输出质量也看的过去,但是 pp 非常差,并发几乎没有
现在不合适,服务器级别的 DDR5 内存都死贵,你要想走消费级显卡的路子,那么购买数据中心淘汰下来的服务器 DDR5 内存、主板和 CPU 是必须的,走 CPU+GPU 混合推理的路子。但是你也知道,现在内存的价格完全都是畸形的,购买内存的钱已经比当初攒整机都贵了。所以呢,等等吧。过两年再说。
的确需要兼顾硬件成本的性价比。现在泡沫太大了。对deepseek 小型化比较期待
点进来之前我以为的消费级显卡:RTX5090x8 
2 Likes