我们日常使用各种网关、中转、aistudio,他们有我们完整的请求记录,会怎么用来训练呢,放到系统提示词会相对安全一些吗,我看有的网关只存储用户问题和回复?
谷歌政策里说付费的不用于训练,至于真的还是假的就看他的良心了,国内的kimi已经爆出过用用户数据训练了,有人的简历被吐出来给别人了。
我要不要担心我的问题都太抽象,会把喜欢的模型厂商带偏
看良心,大厂的一些企业API要是明确说不训练、ZDR的还是有可信度的,要是被抓到证据商誉会严重受损
明确拿去训练的部分,乱七八糟小中转不把你邮箱一起打包就很有武德了,然后到模型厂商手里基本就是清洗、脱敏、筛选质量后再训练,尽量保证不关联到个人(但肯定有手法不精和漏网之鱼的)
怎么可能……个人用户的数据量才多少,杞人忧天也不带这么担心的
不用担心,你一个人带不偏的,另外应该可能还会进行标注的。
小中转还有可能会卖给灰产,比如你的env文件等其他机敏信息。
有重要信息的话,就要稍微小心一点
哈哈哈, 之前我还在想中转站作恶, 后来自己维护了一个小中转站.
发现除非是真坏, 要不拿用户数据和偷敏感信息还是挺麻烦的.
你看马斯克收购cursor 之后模型进步多大就知道了,会不会参与模型训练很明显。。
收购和不收购就是两个级别的模型。
我的垃圾提示词人家都懒得看,丢垃圾桶里面都闲占位置
这有什么麻烦的 就是机器性能要好点 不要让记录请求和返回成为性能瓶颈就行
如果有渠道卖对话数据 很是一门很没良心但是用户极难发现 而且利润可能比单纯卖Tokens更高的生意

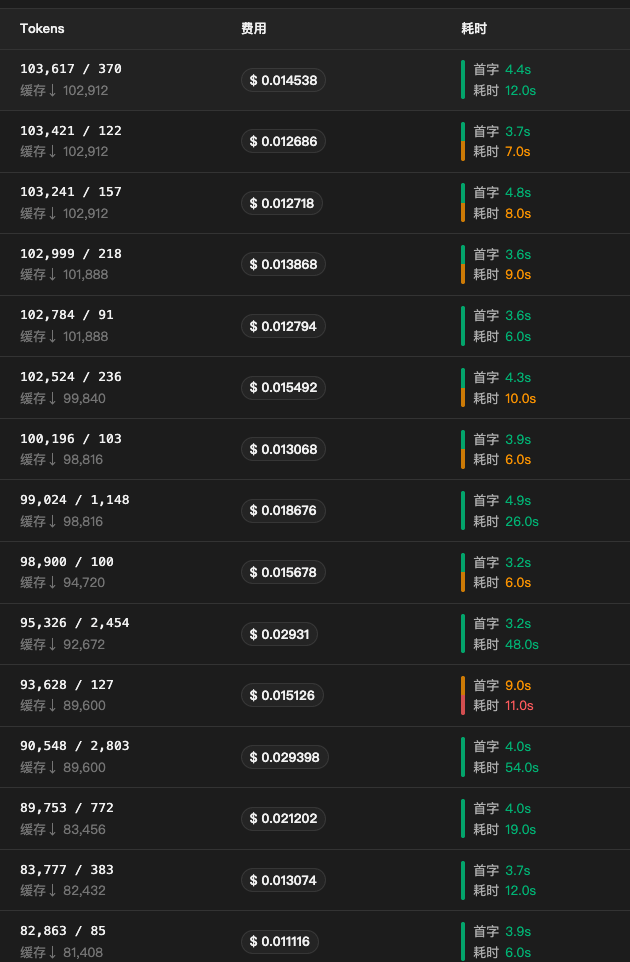
普通的网关没有记录那么多,商业网关那必然是记录很多东西的,然后对外可以说保护用户隐私.
记录更多东西主要还是为了实现风控算法,跟用户产生纠纷时,也有的查.这时候,中转想把完整数据倒卖给其他人也是轻而易举的,用户的输入+输出提示词,上传的图片,文本,都可以进行数据清洗——》提炼有价值产物流水线式进行处理.
个人也只能尽量从可信渠道使用中转来避免,要不就是无所谓隐私去用。