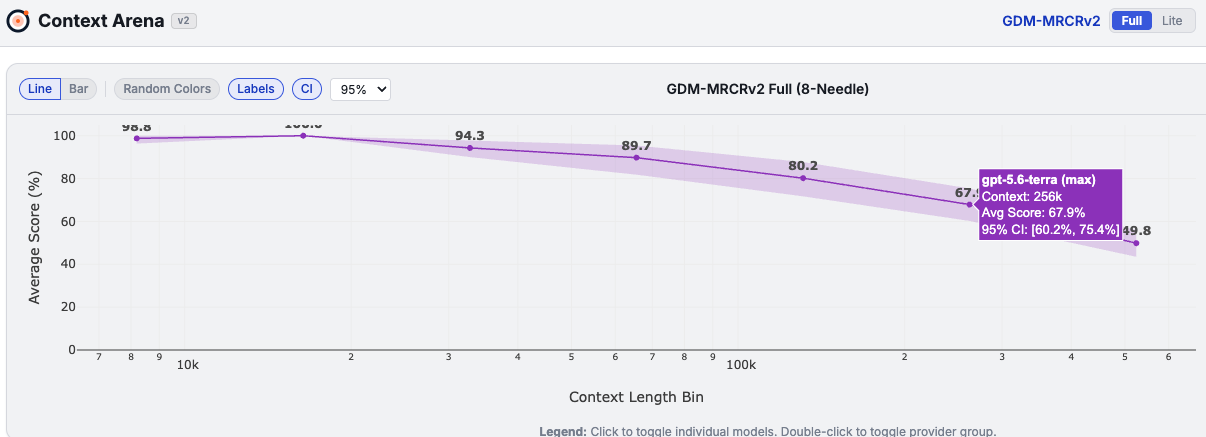
具体情况是: 我使用 gpt5.6 terra:max 做主线, 带着一群luna或者deepseek/glm flash做开发, 但是在最后收尾的那段时间, 任务基本都给到了主线, 导致1M上下文到300K左右就开始注意力涣散了, 直接降智
怎么感觉这个1M更加是为了追赶市场搞得噱头啊, 佬们都是怎么配上下文长度和压缩阈值的?
具体情况是: 我使用 gpt5.6 terra:max 做主线, 带着一群luna或者deepseek/glm flash做开发, 但是在最后收尾的那段时间, 任务基本都给到了主线, 导致1M上下文到300K左右就开始注意力涣散了, 直接降智
怎么感觉这个1M更加是为了追赶市场搞得噱头啊, 佬们都是怎么配上下文长度和压缩阈值的?
不配置,多写文档
我是差不多放弃上下文了,等技术革新吧
所有模型基本上都是到300K左右就开始注意力涣散了. fable5 一样..
确实如此,我一般就是在300K的时候压缩一下,并且让主线经常维护进度文档,确保压缩后不忘事。我自个实测效果比指望他自个不断延展上下文要好,钱还花的少一点。
我是开1M上下文,目的是为了防压缩,压缩一下上下文再继续工作直接蠢到家了。然后多写文档,上下文窗口用个300k左右就要开新窗口接着文档继续弄
都一样吧 谁家说自己的 1m 不分散?
佬,你的进度文档是怎么写的?我感觉我维护的文档太长了,塞到压缩过的上下文中也很占空间,能让我参考一下吗?
我主要是要求他维护一个主开发线主进度文档和主开发线的每个子开发线文档,在主进度文档里维护的内容包括开发线简述;开发规则(基于具体的项目约定描述,也可以随着开发过程中的发现而更新);子开发线的文档的文件路径;子开发线的工作流安排(定下来后就不用动了);子开发线开发进度表(根据实际进度描述状态即可)。然后主开发线文档基本上就只会更新维护开发进度表,如果有什么额外的约束就放到开发规则里。到每个具体的子开发线的时候,里面写了该子开发线的具体plan,推进到哪个开发项了,进度日志。通常子开发线不会很大,太大了就拆分成额外的存在依赖的子开发线。然后划分一个编排者-worker架构。编排者维护进度文档,分发worker agent,但不干活。worker就只干编排者安排的事情,干好后写个简报。这样编排者的上下文一直会比较精简并且只关注进度问题,只要每次wait的时间长一点,别一直轮询,基本不怎么消费token,并且确保整个开发线基本稳定,哪怕压缩了直接读一下过往文档很快就知道实际进度了