先叠个甲,我不是华为用户,手持苹果17pro,
附手机截图
其次,qwen minimax gemini opus4.8这些跑分模型我都骂
最后附上测试
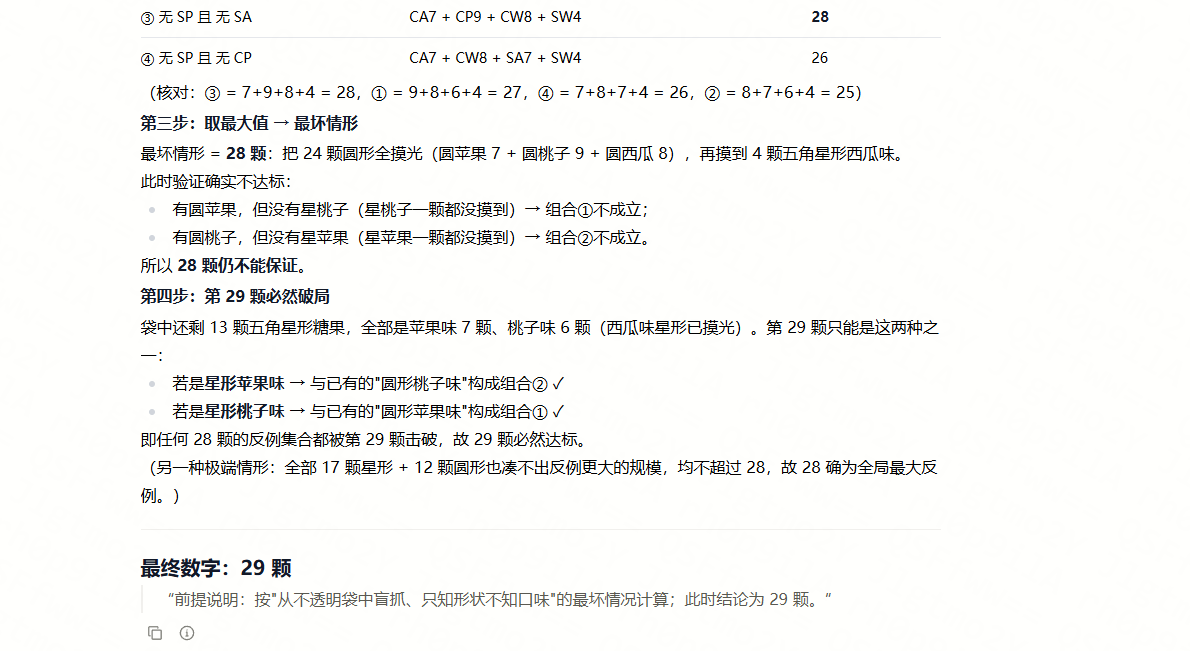
糖果测试不通过
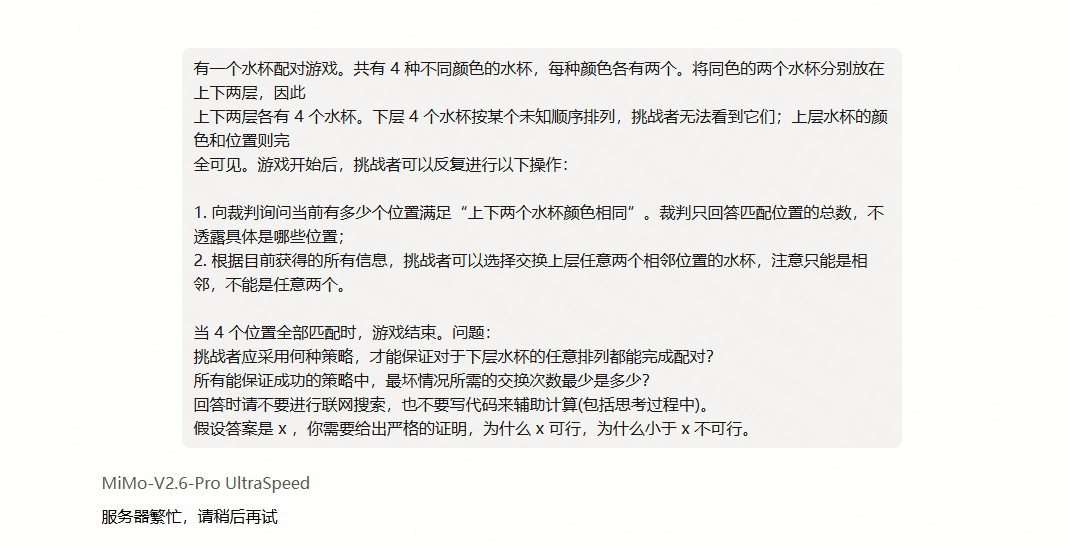
水杯测试会卡死
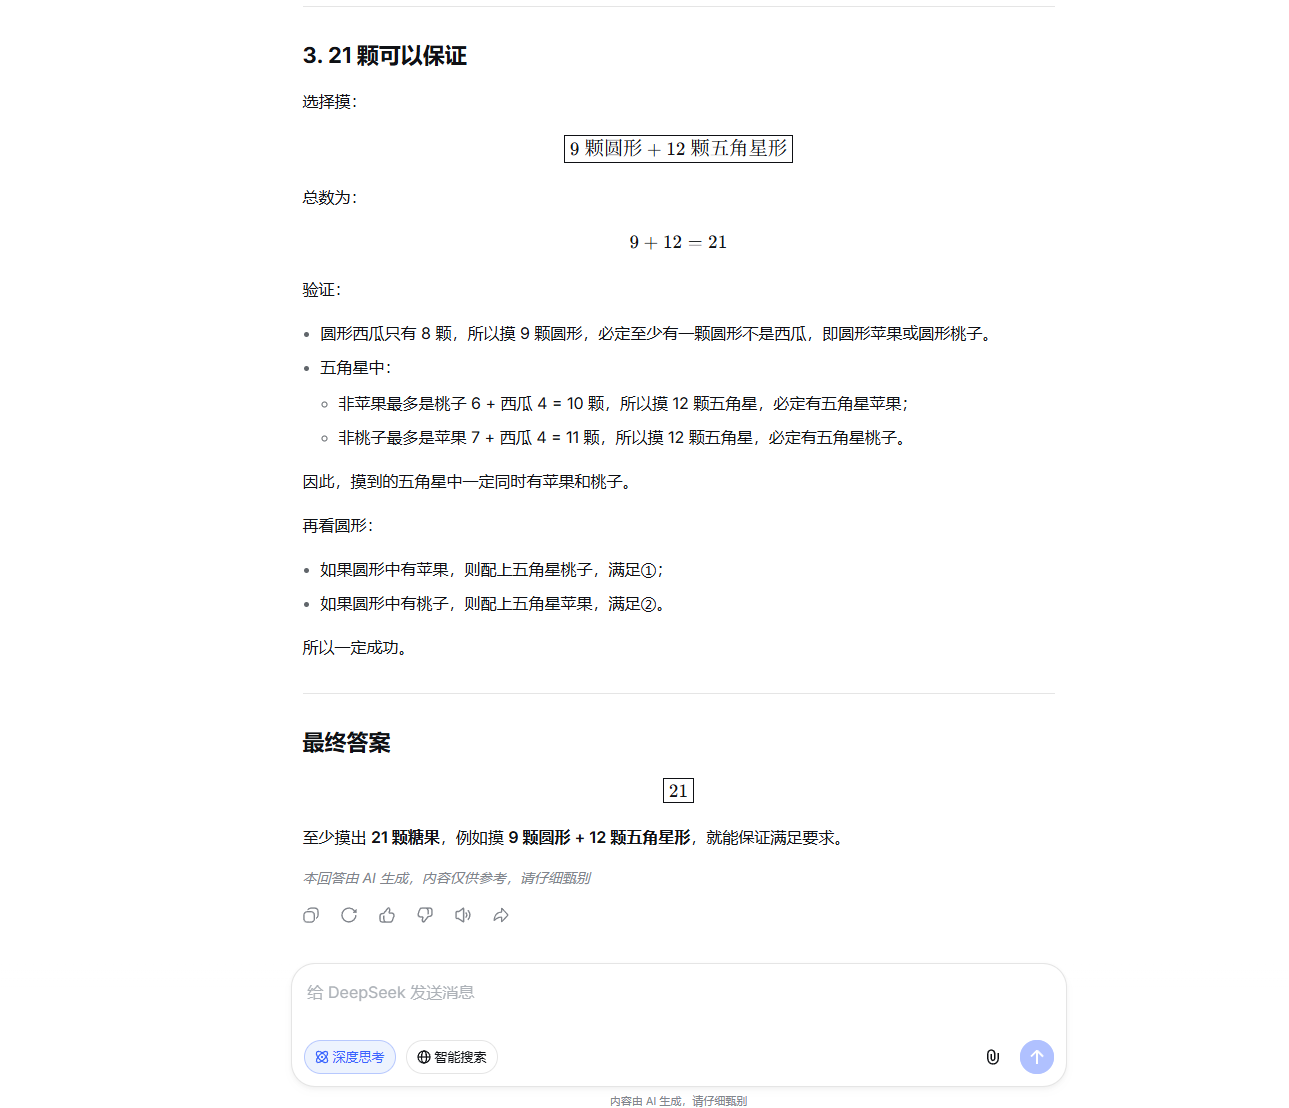
大肥鱼的糖果测试
总之感觉这模型思维链有问题,还配不上开源第一。还是没定语的第一
有人说我内心戏多,今早“内心戏”不多的已经这样了:
先叠个甲,我不是华为用户,手持苹果17pro,
用苹果叠甲学到  话说苹果什么时候开始做大模型,我想看三方混战
那真论起来,苹果用户喷小米简直名正言顺,我也不搞几圈那套,是什么就是什么  有些人堵嘴不让说就有意思。
刚用2.6Pro跑了个项目的debug,结果不太行,反正匹配不上跑分,感觉不如其他家3个Flash
养养虾得了,本来之前定位就是养虾的
人家套餐敢卖400刀一个月呢,斩杀A\ O\和两个G\
我用下来还是不错的,使用的OpenCode 和 pi,比以前便宜的deepseek v4 要好很多。
我觉得你们可能使用的工具和mimo不匹配。
模型思维链确实有问题,站内有个帖子用的也是opencode
还有两个测试都是在他自己的网页端,没用任何工具
开源第一指的是在小米实验室中得到的结论
看后续能不能提升,这块产品小米都是测试版本,没有那么高端大气牛,后面觉得没有市场可以就放弃
我还有话术,“叠这么多甲,是ChatGPT发帖来了?”
现在都搞的跟酷安一样的了  实事求是就好了嘛 最反感的平台就是酷安了 天天因为个手机品牌能吵起来也是逆天
这样的评论多好,不双标,你就是一个正直的人,本米粉表示认可,垃圾就是垃圾,好就是好,只要不双标都是正常人
太难了,发个测评还要叠甲,lol
今天早上我看到的船新版本,糖果测试没做对,肯定是没刷题
这玩意也要叠甲,好用就好用,不好用就不好用,核心是看能不能干活。不能干活再好用也是垃圾, 能干活在不好用也能干
我想知道这个能不能平替ds4.1f?
我已经看到有人说为什么都在黑小米了。人家鹈鹕测试,糖果测试都甩脸上了,效果确实不行,还在问为什么都黑小米。。。
答案是远远不如,无论是速度还是质量。也就比梁文峰时间便宜这一个优点了。我没说是那个神秘模型啊,我说的是gpt 4o!(叠个甲 )