我在pi中使用deepseek-flash作为主模型,使用的@juicesharp/rpiv-advisor插件gpt-6-astra作为advisor
rpiv-advisor好像会把全部上下文发送给advisor
由于deepseek喜欢雷霆大思考,把全部的上下文丢给astra,很容易就超出了272k上下文,导致双倍计费 
我找了另外有类似的插件pi-advisor-flow的做法是裁剪上下文,但是裁剪后advisor的效果就没那么好了
各位佬,有没有遇到过这样的使用场景,有没有什么好的解决办法吗
dsh的做法是, 可以自己设置保留百分比,加上尾部百分比
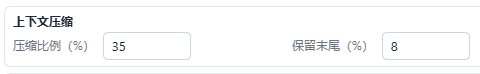
比如1m的ds4.1 我现在设置的是350k时候开始压缩,压缩有个比例我忘了多少,比如是20%,那就是70k上下文+尾部8%也就是80k 合起来150k上下文压缩后的体积。
codex的压缩被赞扬,其实dsh的压缩和codex基本一样的,只是codex是默认远程压缩,单独给个长上下文去压缩,提示词好像曝光过?大概原理一样的。效果主要在模型间的差别。
根据捞针,我设置的甜点位
或者用gpt-astra-6作为主模型,但是主模型只做规划核查,干活交给deepseek-flash
不知道在pi中能不能实现这样的效果
是这样的,我不太理解这个插件是什么用法,似乎只有用有缓存的主模型才有性价比,不然直接发所有上下文和我直接用这个模型有什么区别。但是用主模型审阅的话自己审阅自己也没用啊 
是有这样的疑惑,本来想着用deepseek做主模型能省点,结果给advisor的是全部上下文,这样反而更费token了