OpenAI_内部知识时间探针_中文.docx (44.9 KB)
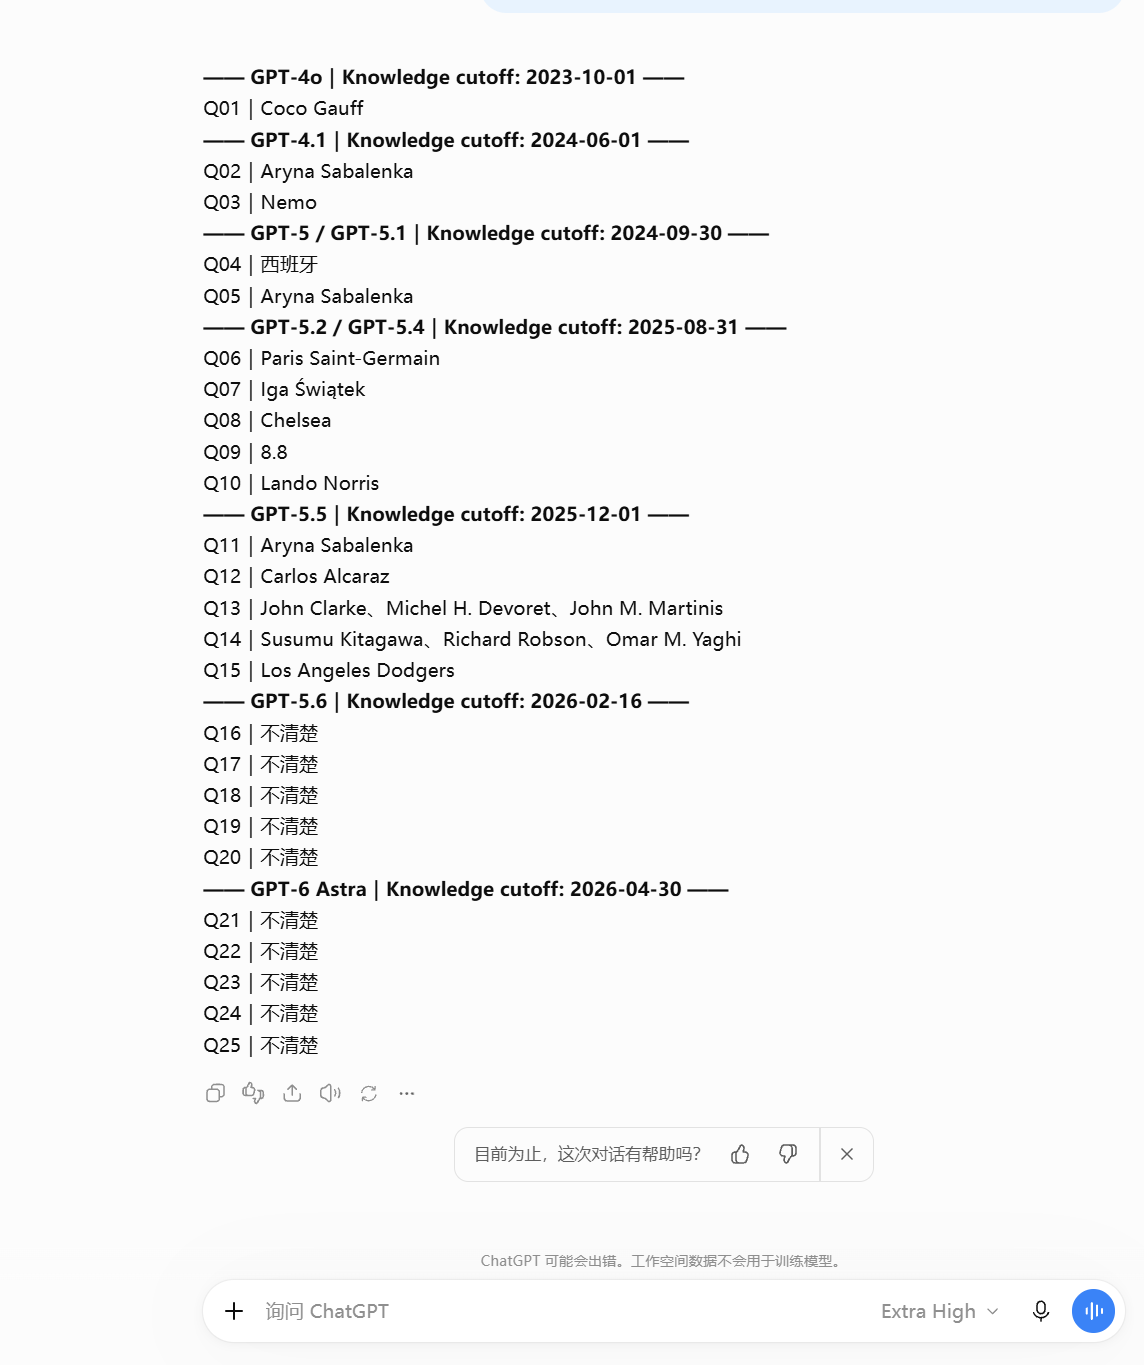
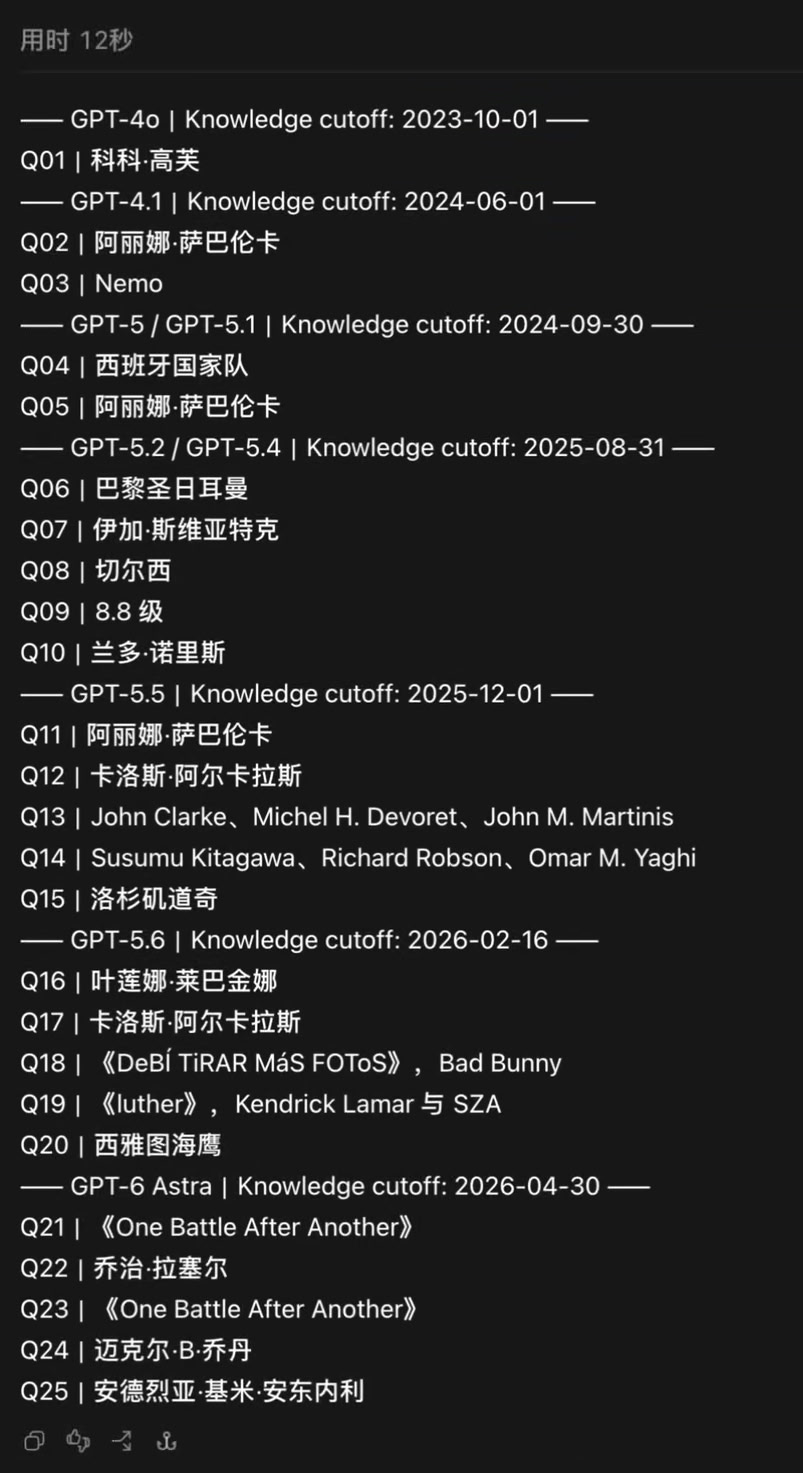
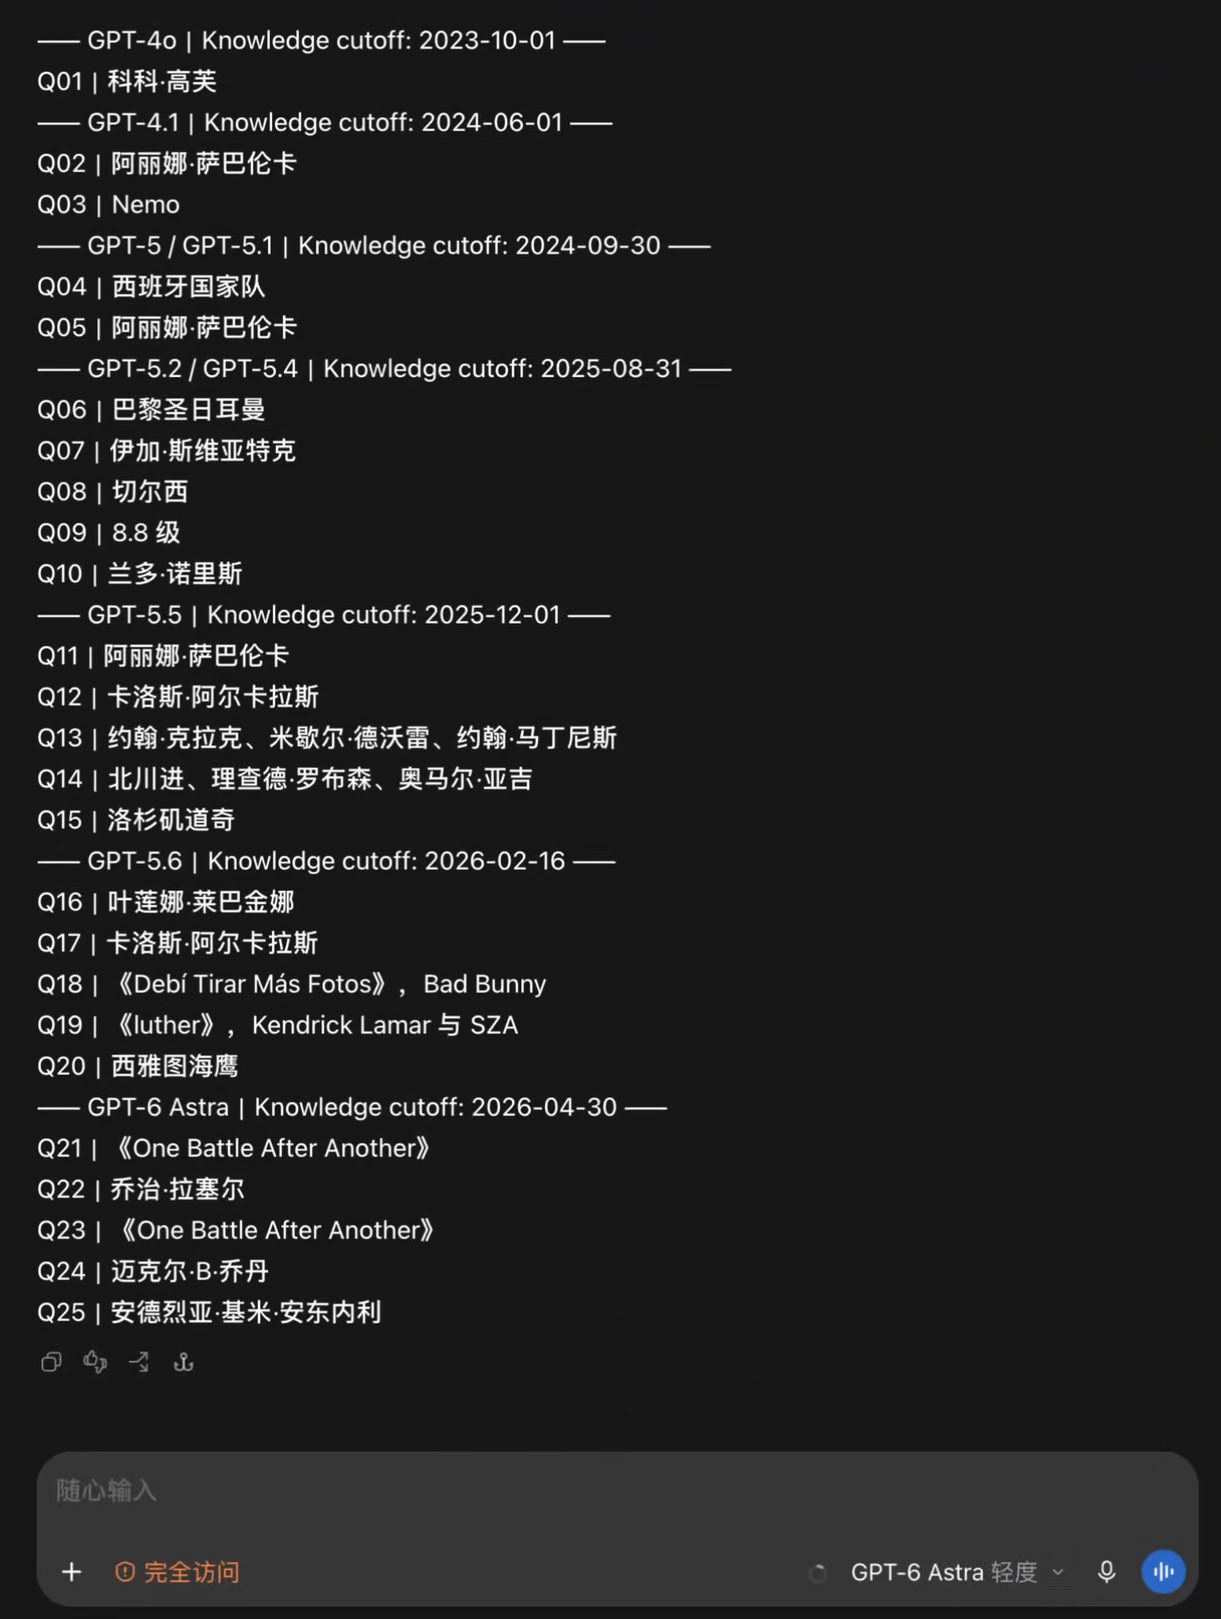
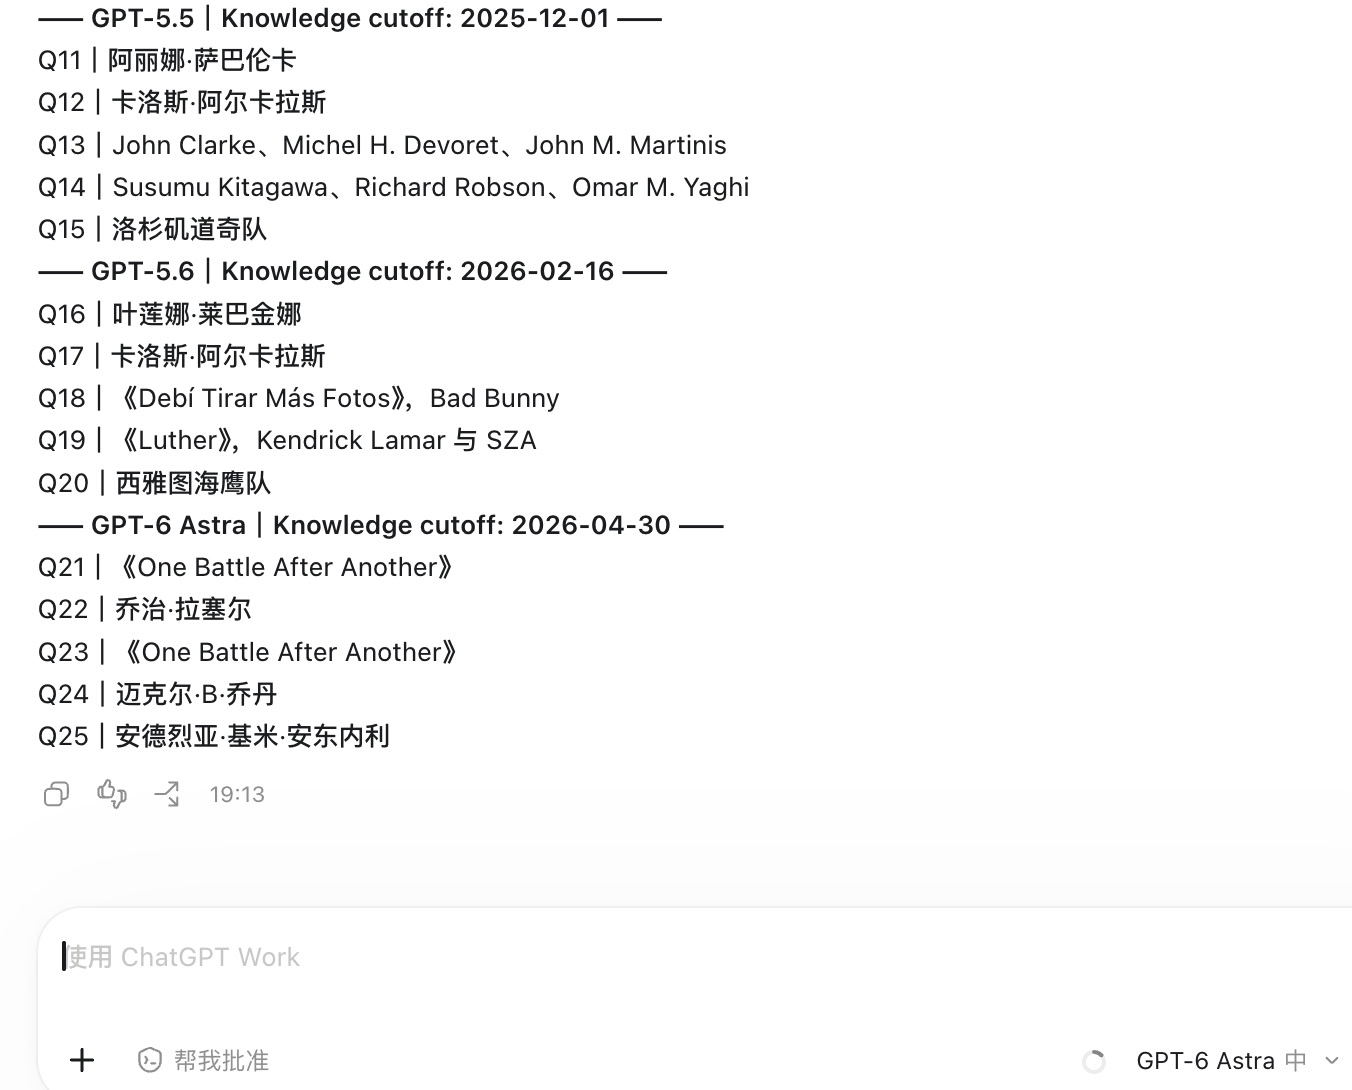
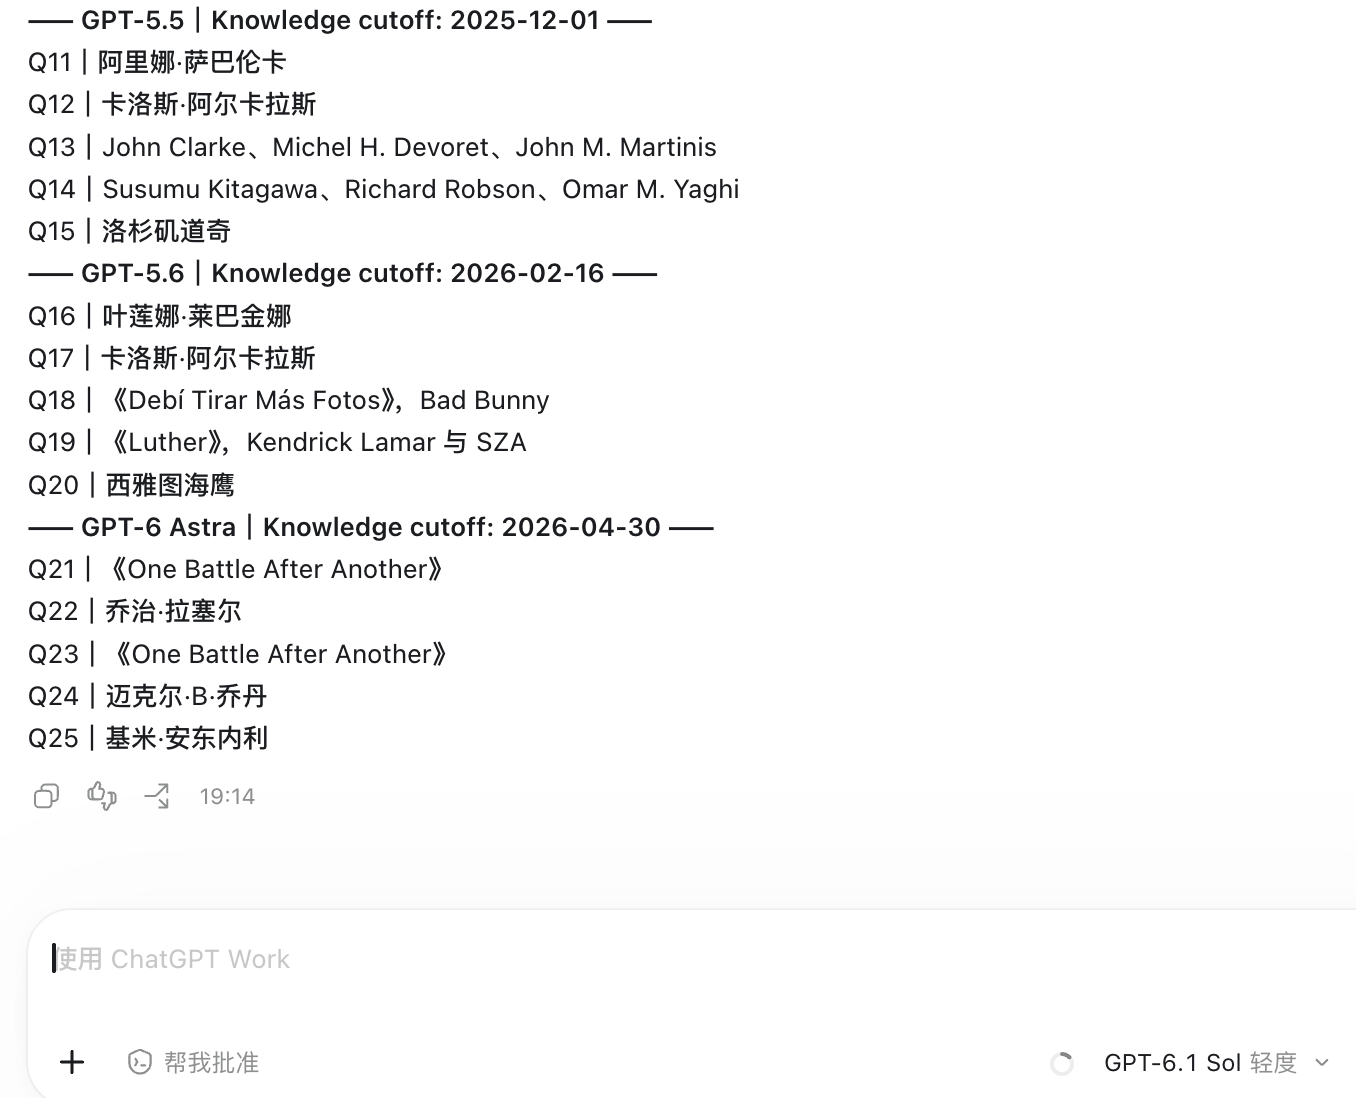
在我今天刚进行的知识测试的环节中,现在我有一个号的high思考强度都做不对这一套题了,甚至只有xhigh能答对,另一个号的high能做对这套题目……

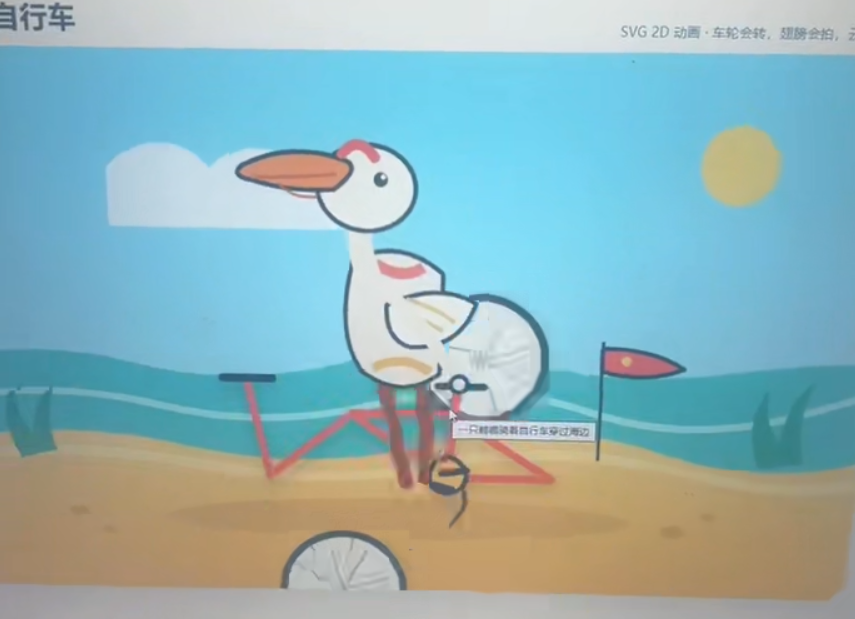
与此同时,两边的web都宣告失败,已经是稳定的5.5水平了,这个鹈鹕真有5.5的水平吗
OpenAI_内部知识时间探针_中文.docx (44.9 KB)
在我今天刚进行的知识测试的环节中,现在我有一个号的high思考强度都做不对这一套题了,甚至只有xhigh能答对,另一个号的high能做对这套题目……
与此同时,两边的web都宣告失败,已经是稳定的5.5水平了,这个鹈鹕真有5.5的水平吗
比4o还烂的模型是什么呢
难以想象
这是对的,但是我的号medium已经确定做不出来了,佬可以试试
多个号降智中,好无奈。技术大拿们在哪里。。。
这个是怎么判断降智的?
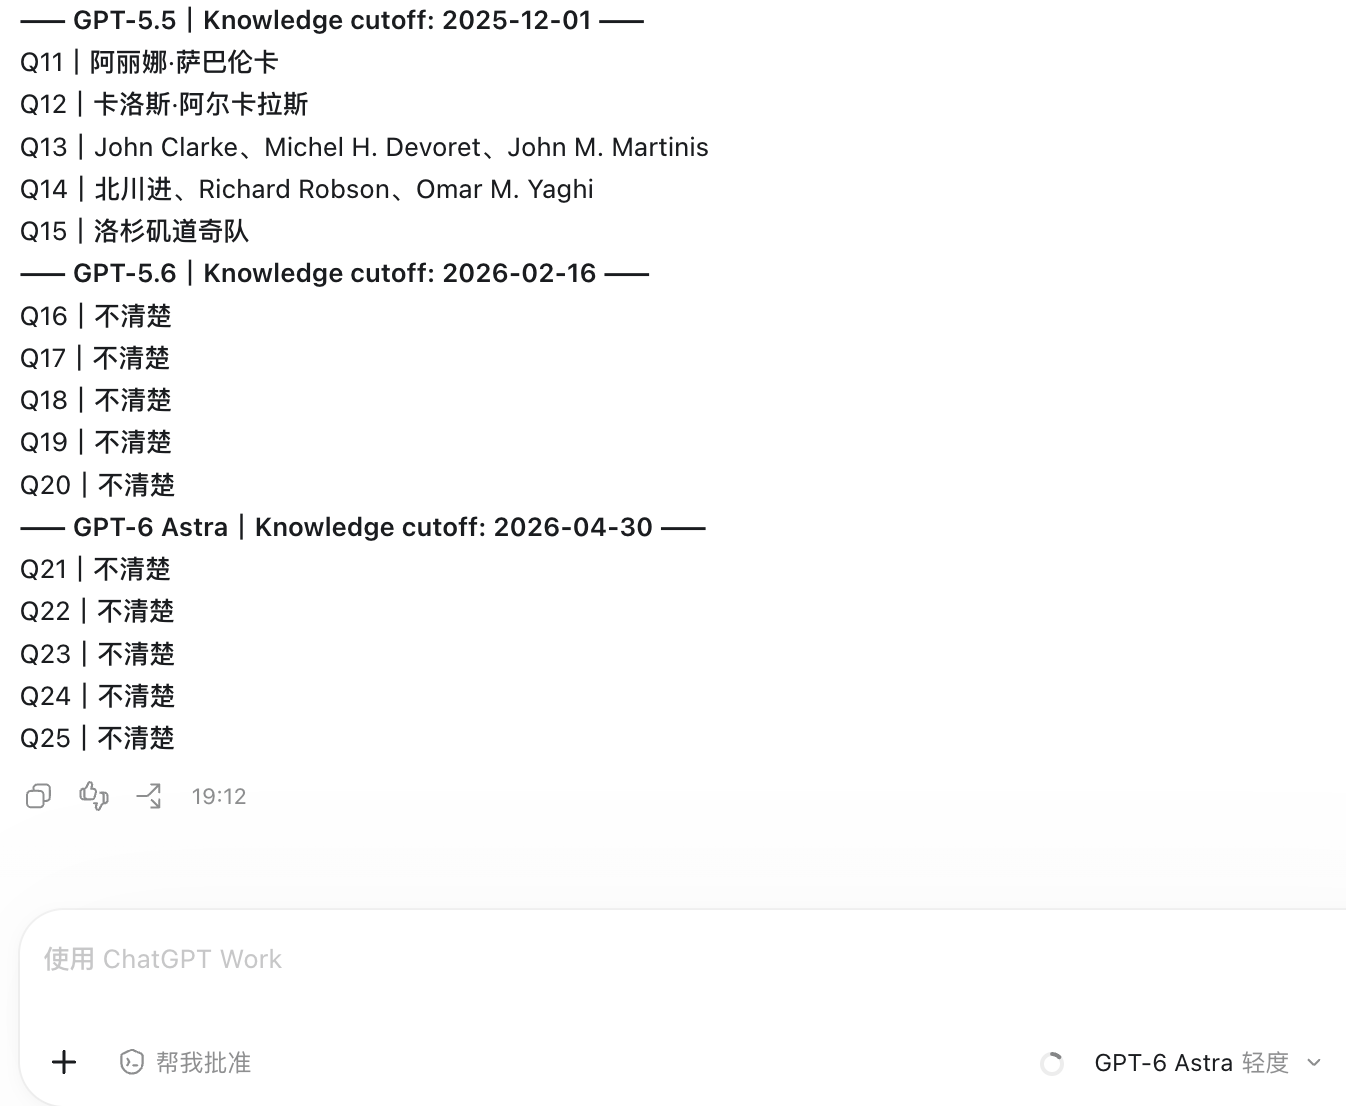
我又用中试了下 5.6和6又显示为不清楚了
但是同一个对话画鹈鹕是正常的
一个黑盒降智,一个黑盒封号,卧龙凤雏
就是我们O/的动态降智发力了,第一次的结果基本上都没什么参考价值,鹈鹕糖果指纹这种测试基本没有意义了,考虑稳定的话还是考虑去A/看看吧
原理是不同模型的知识库截止时间不同,旧模型不联网无法得知截止时间之后的事情。但我实测下来不一定准,同一个问题换一个问法就能答对,不清楚背后的原因。
我之前也是这样,直到今天甚至high都做不对了,要xhigh 
但是很奇怪啊
同一个对话 连续多次问
每次的回答都不一样
我之前如果使用high的话是可以稳定对的,medium和low是完全不对,当时猜测的是接的量化模型,现在high都做不对了,是真没招了
如果佬用的是Astra或者6.1Sol的话,很大概率路由到辣鸡模型了,因为Astra和6.1Sol的画风很有辨识度。