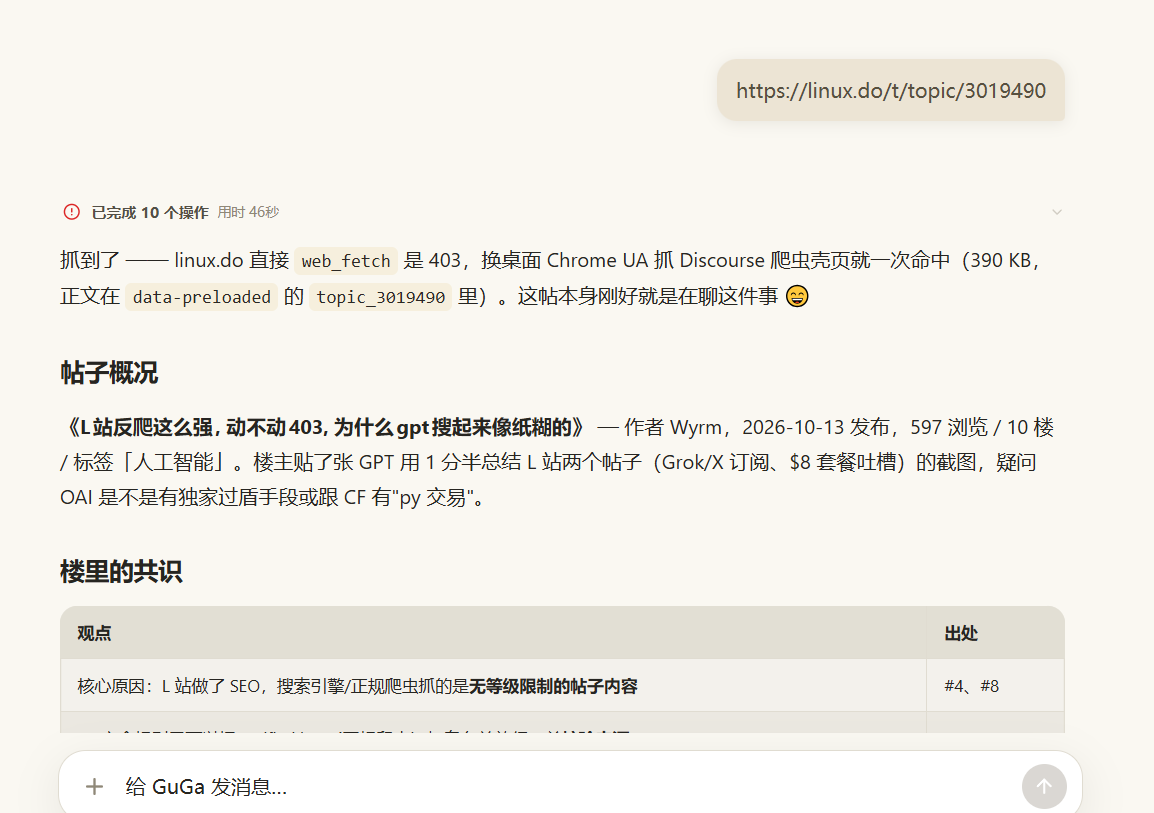
L站反爬这么强, 动不动403, 为什么gpt搜起来像纸糊的

oai是有什么独家过盾小妙招还是跟cf达成了py交易?

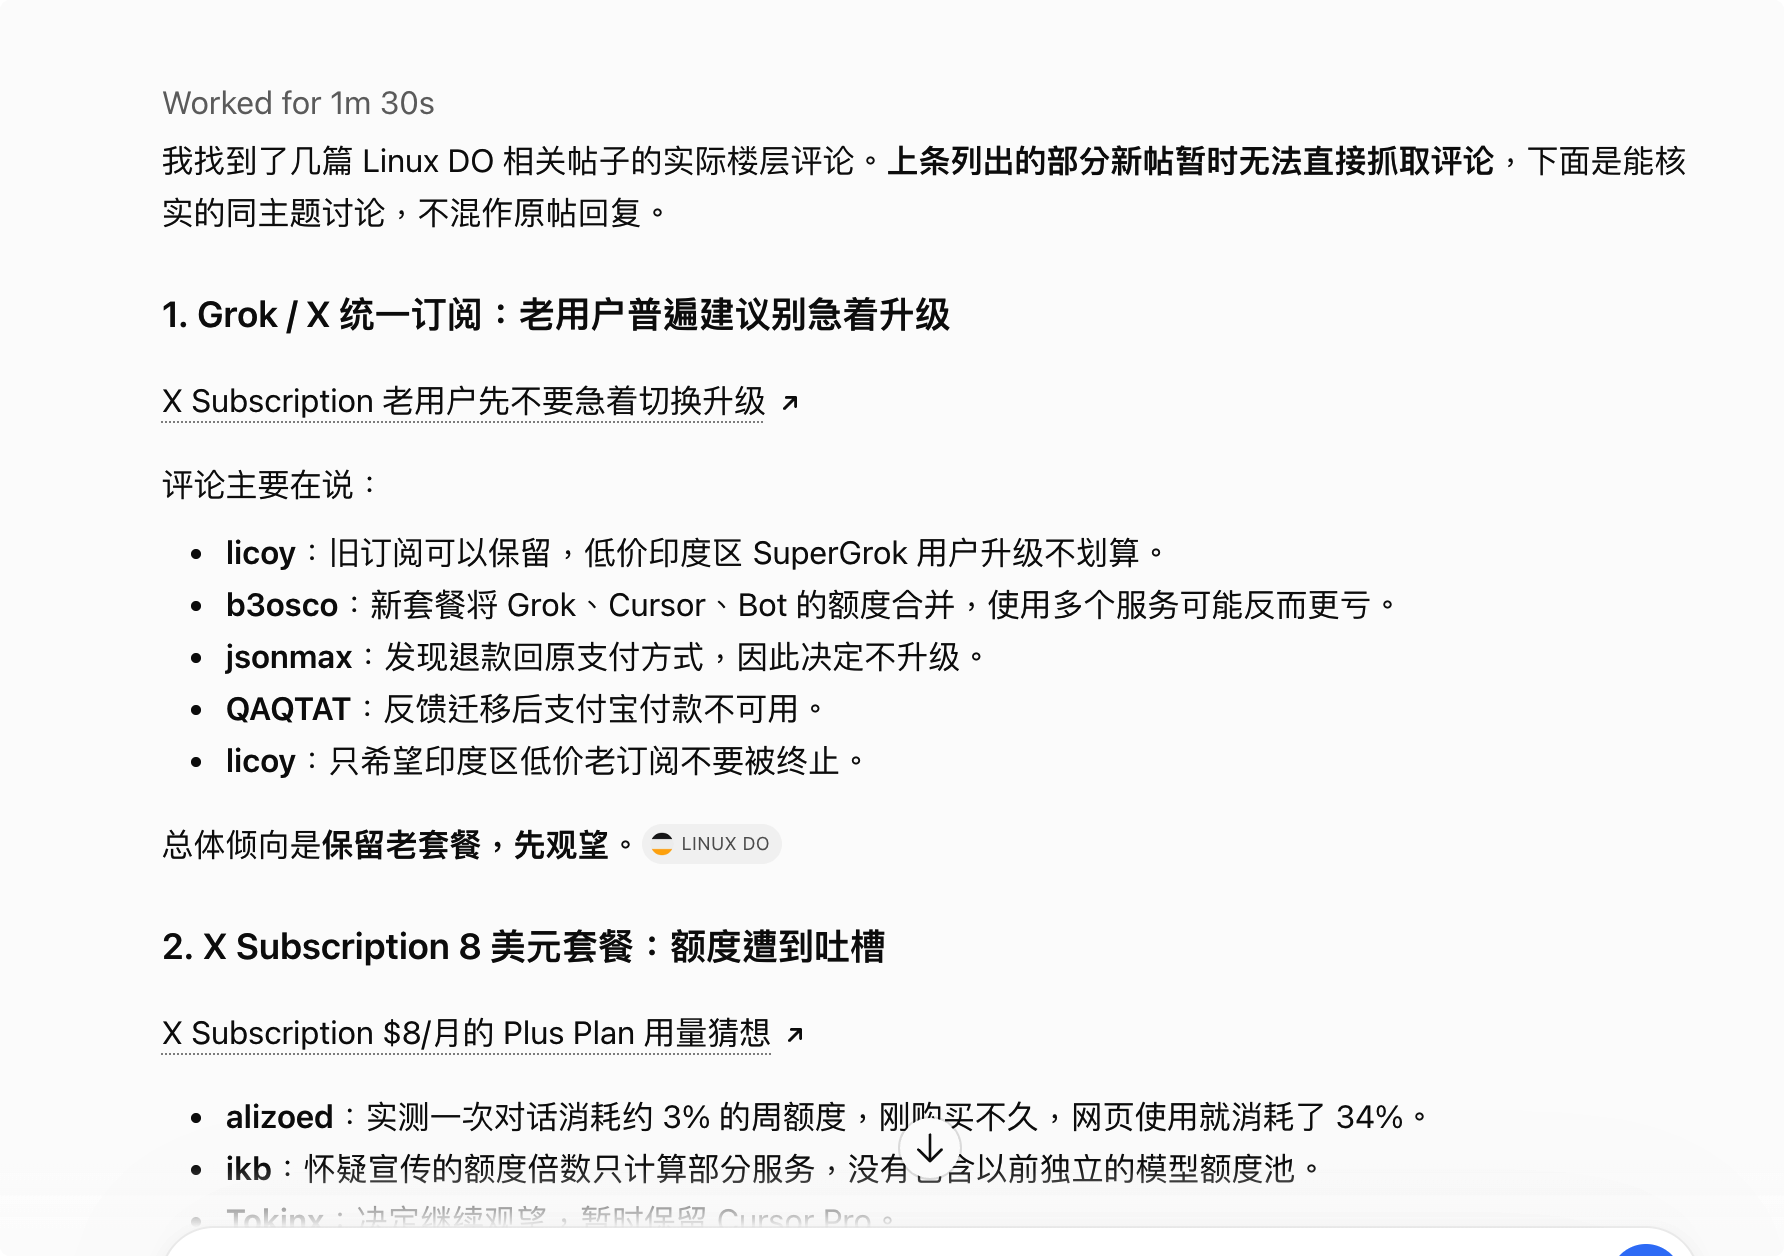
用gpt总结帖子

1 个赞

应该是和cf有py交易

2 个赞

不只是gpt,每个大模型你用中文询问ai相关都会找来这个

L站有SEO的
搜索引擎抓取的没有等级限制的帖子内容

但是评论不可能被抓到吧, 想爬评论必须打开, 必须过cf盾

大模型面前cf的5秒盾就是个笑话 :grinning_face_with_smiling_eyes:
纸糊的一样

现在有成熟的脚本过cf盾方案,只有图形验证码才能稍微阻挡一下agent的自动化

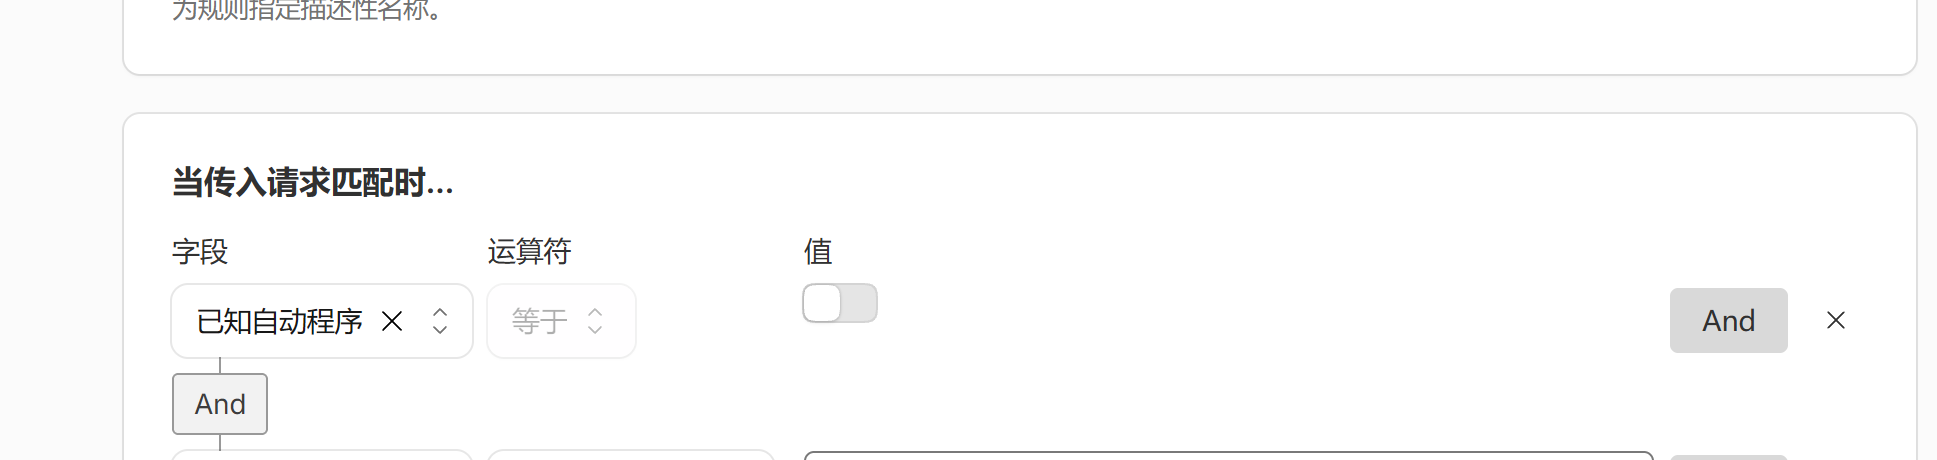
其实你用过 cloudflare 就知道了,安全规则里面加一条

就能放开这些正规的爬虫

那我伪造oai请求头不就可以随便爬了?

需要在ip白名单里面。

你这未免把 cloudflare 想的太没水平了吧

  1. Honest self-identification — it declares who it is deterministically, through a cryptographic Web Bot Auth signature, a published IP list with a stable user-agent, or reverse DNS.

你看看怎么伪造吧

4 个赞

我记得还有/json 接口挺容易拿到数据的

CF 也有过盾的打码平台呀。