2到2.5用了6个月,2.5到3就用一个月???
3 Likes
这个实际能力水平大概相当于啥模型啊,不懂?讨论的人好少,不过这个速度确实非常快了,鹈鹕看起来也还行 
翻译错了诶,缓存不是输入九折,是90% off 
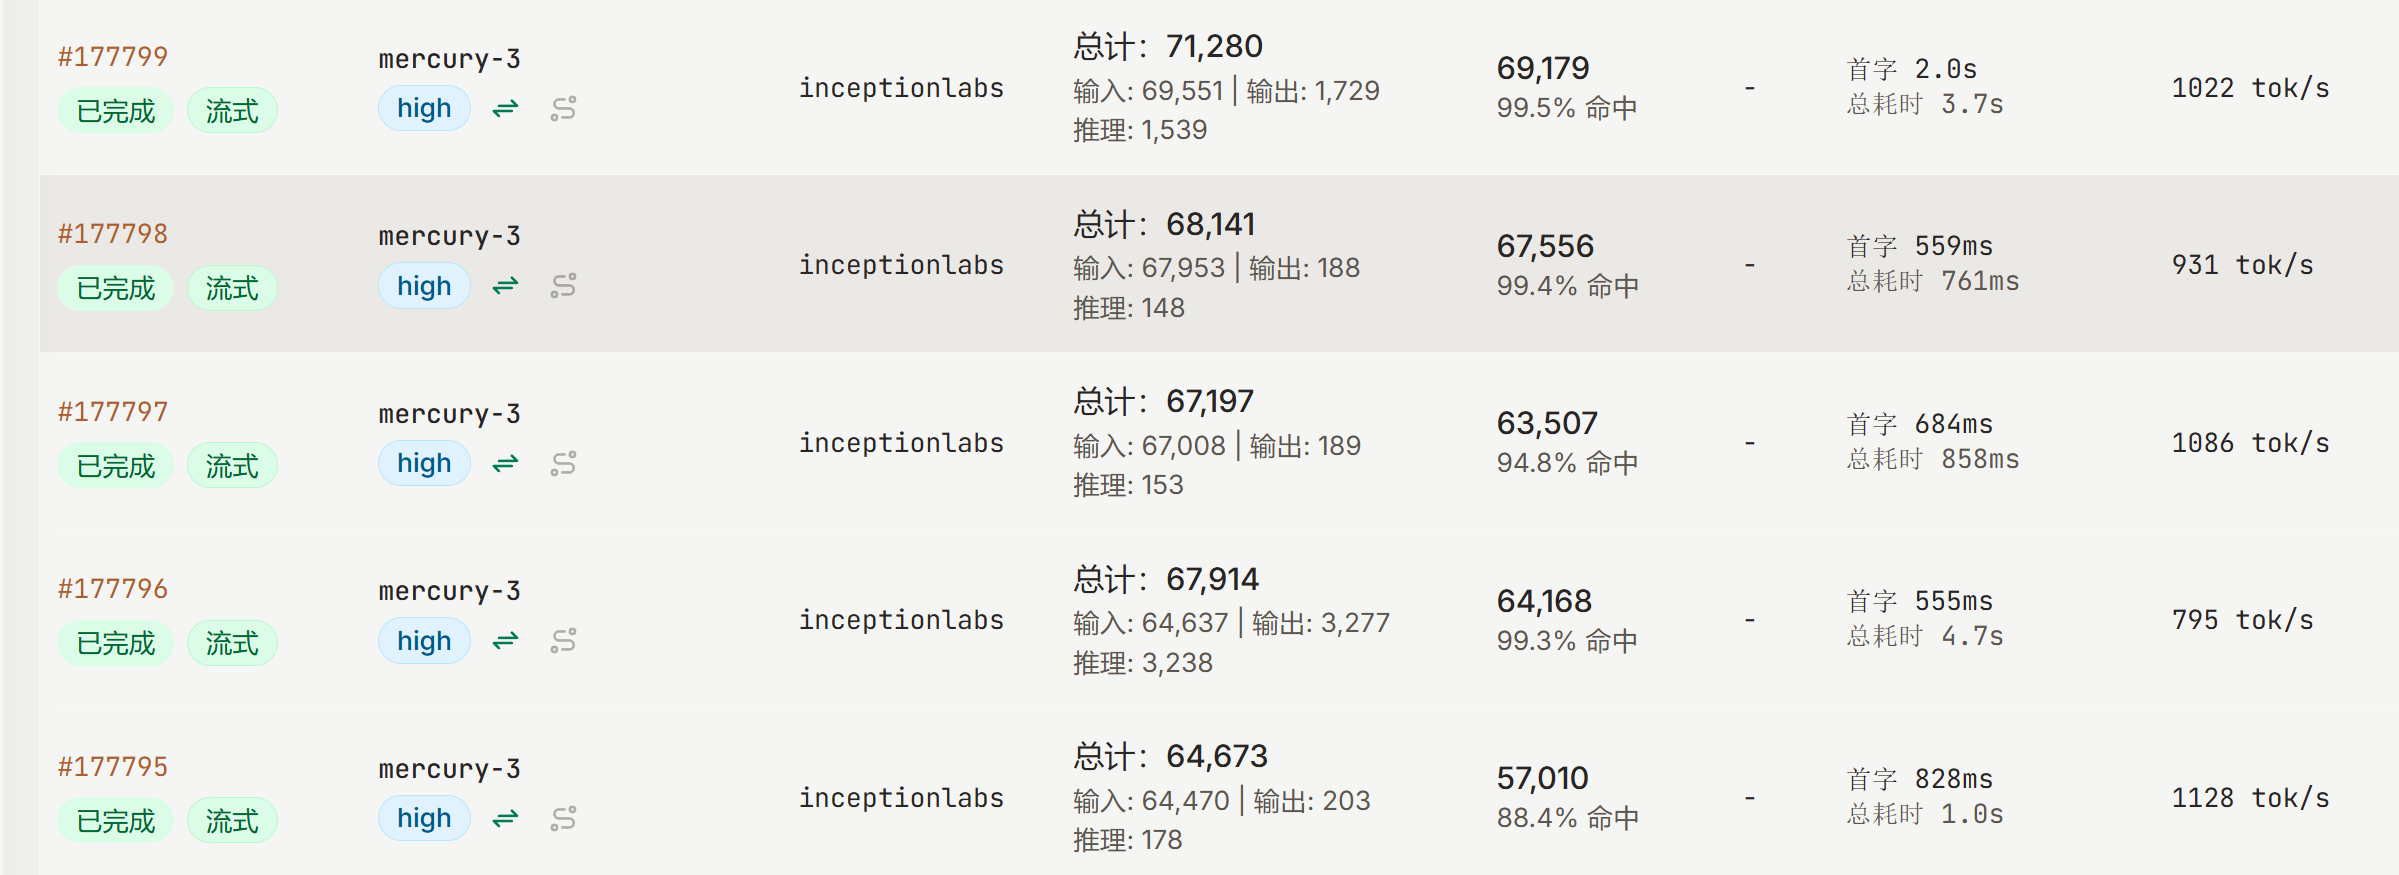
确实有点吊,感觉未来已来
这个估计也就是scaling的尽头了,现在dllm训着训着就会退化成mtp multi token predict,基本一点区别没有,你要想保持质量就减少token预测数目基本退化成自回归,要想保持速度就严重掉点,大家一点办法没有,除非有什么新突破了
8 Likes
我草,我现在只盼着模型大头也来做扩散模型

粗略测试了一下数学和逻辑能力 high感觉确实要比gpt6lunamax强啊。而且比luna开fast还快
1 Like
dllm还是比llm快 不过cache应该后面会比llm贵一些
上次2.5还是区,居然这么快就把scaling搞起来了吗?我还以为要再练一段时间呢
啊? 真的假的
我上次看那个 Preview 版本还很普通的说 
这个模型有啥渠道用一用吗?
感觉用来做沉浸式翻译挺不错,速度快,质量也还可以
官网呗. 喵,好像还是闭源的吧
官方现在注册就送1亿啊。
1 Like
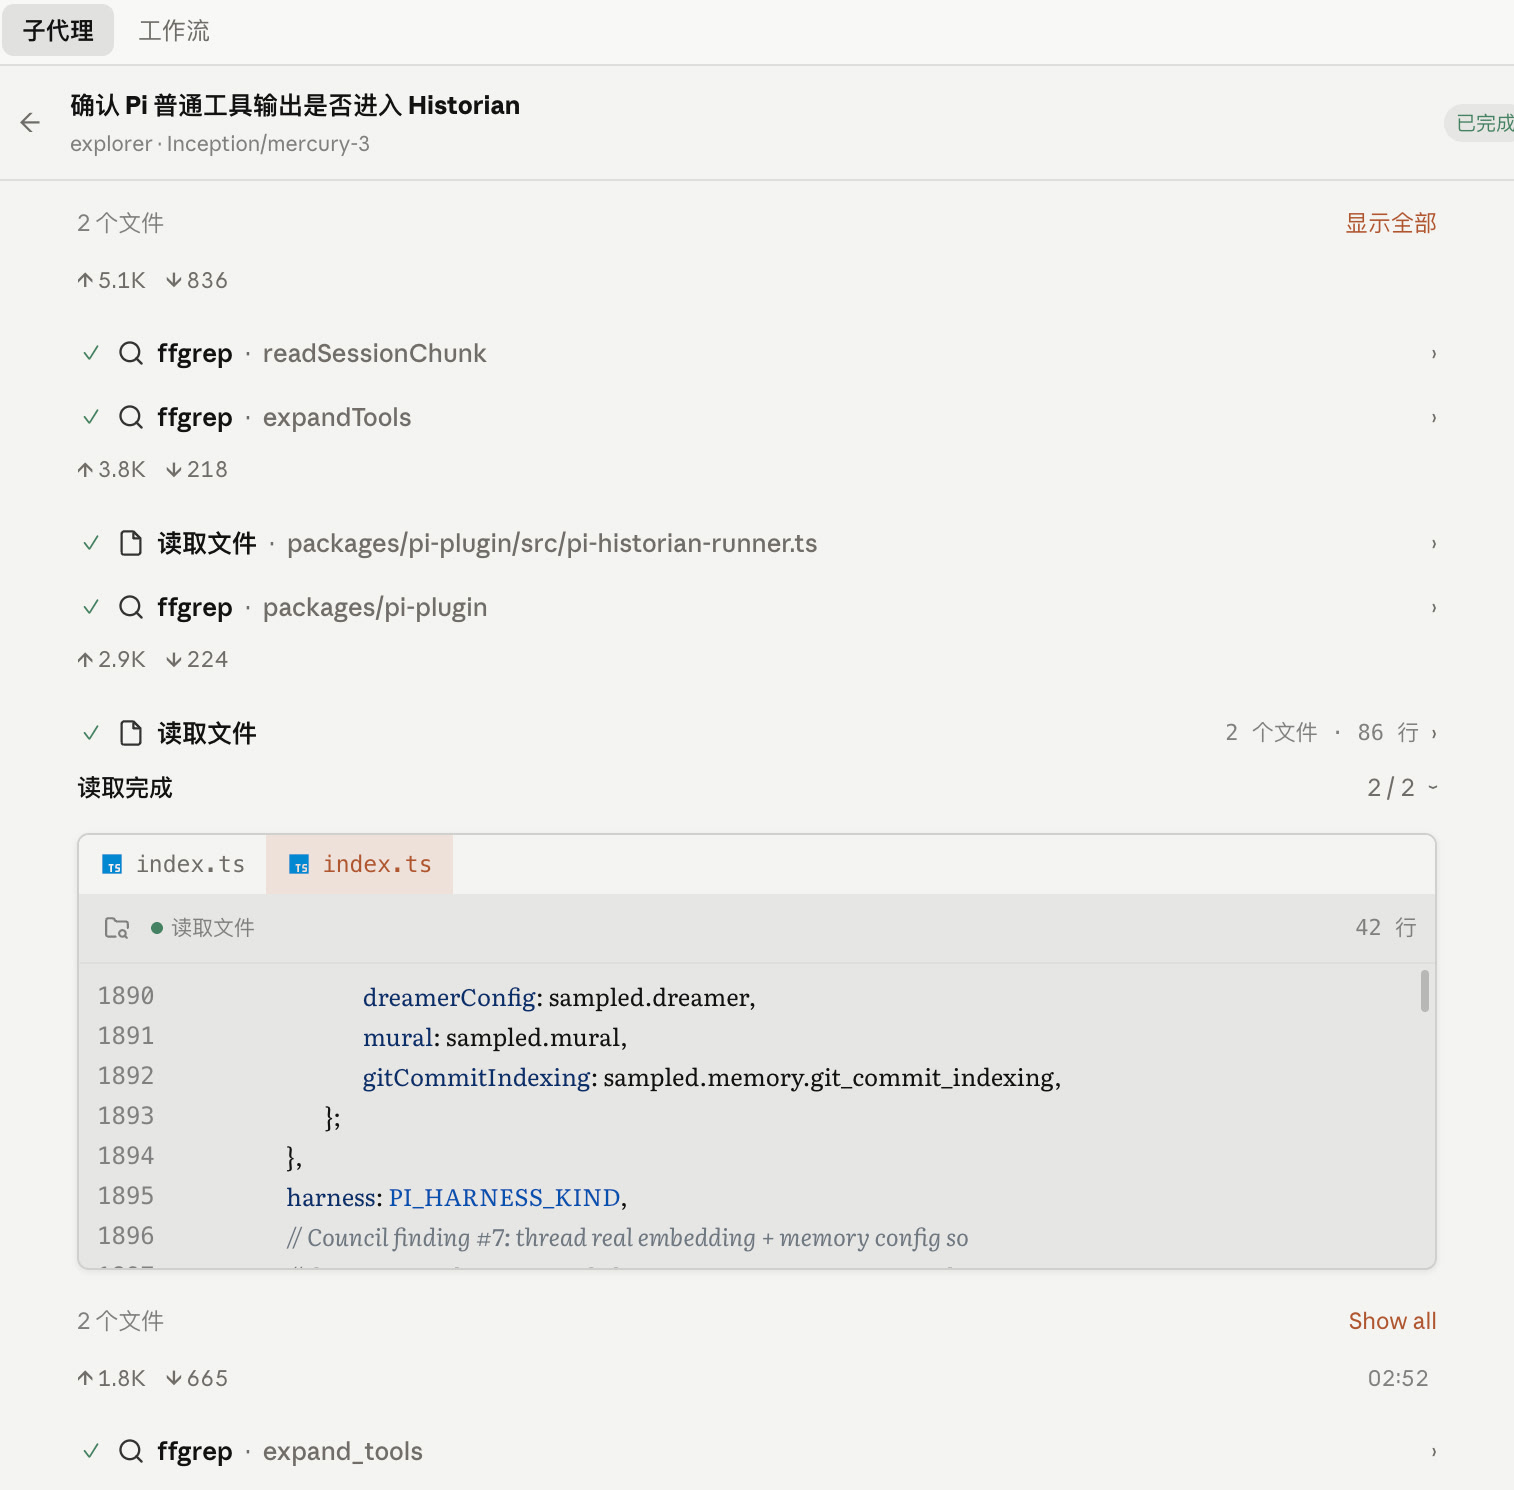
之前都是拿 2.5 当翻译用,难道现在可以用来写代码了
…但是我inceptionlabs号为什么被封了
不知道能不能赢过 swe-grep