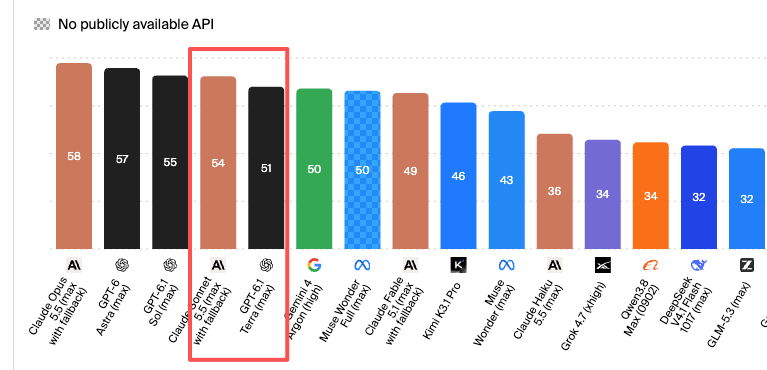
Artificial Analysis 最新 V5 版本排行榜。
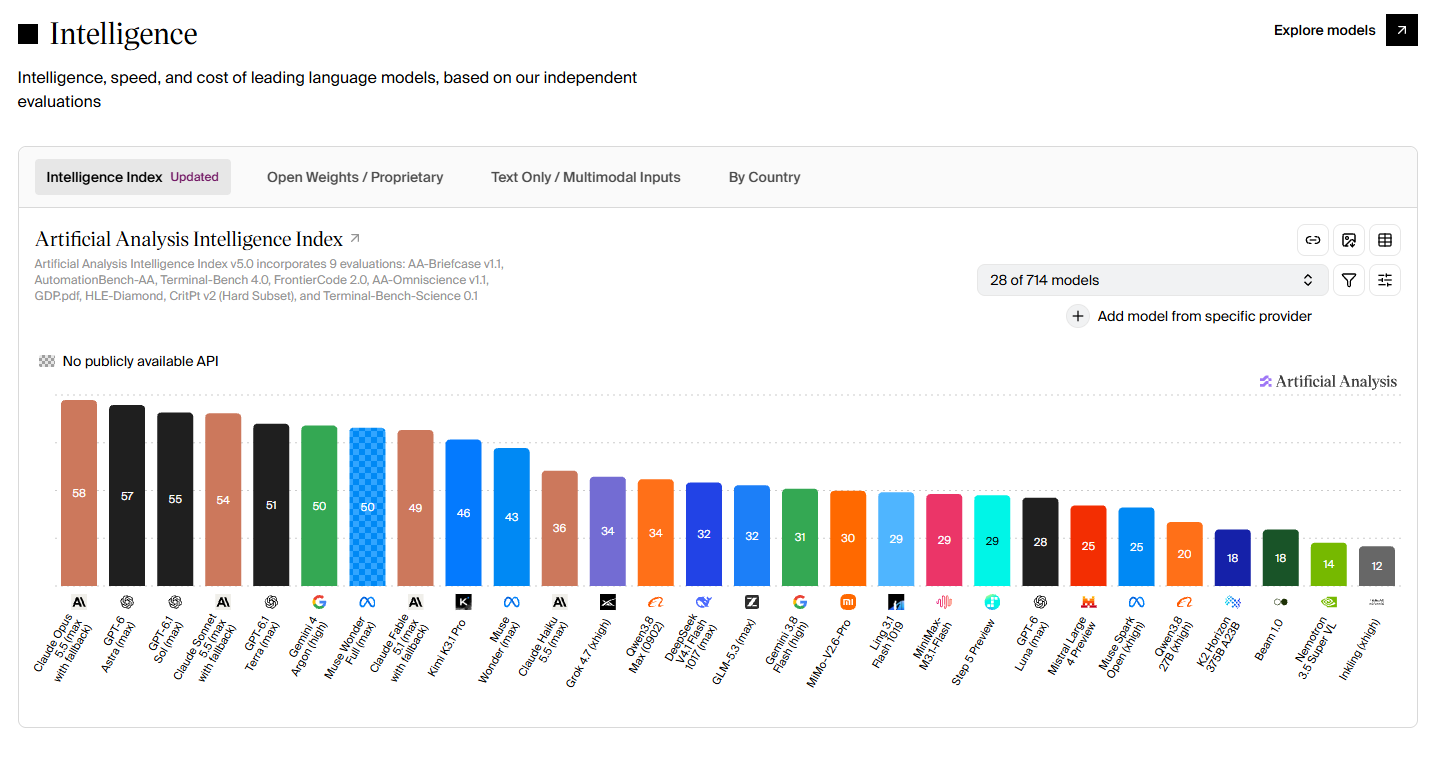
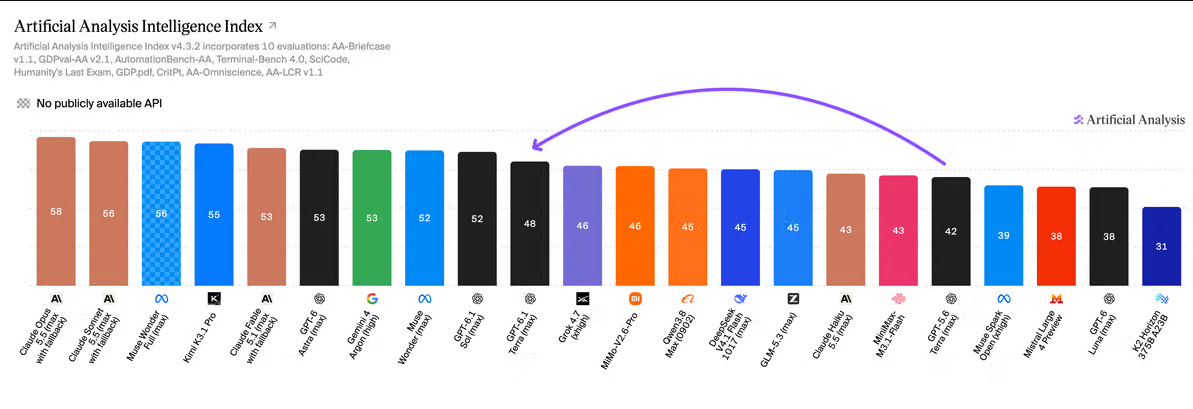
为方便大家对比,下图为上一个版本。
新版以私有测试集为主是好事
不过还是感觉 Haiku、Terra、Muse 的分数不太对()
haiku太假了,感觉拉透了和luna似的
k3.1 pro太离谱了,同样的任务gpt 6.1sol基本半个小时完成,k3.1能给我干2-3个小时,我看子agent一直在review自己写的代码 
这几个还都没用过  好像网上评价都不太好
我去,国模的分怎么降了这么多,这个版本是比以前更准确了,还是更野鸡了?
主要还是太贵了再加上算力不足,感觉大家一般都不会去用Kimi。
deepseek 怎么跑后面去了,这个也是针对性训练的?
DS这几天Qoder免费版用着还不错,感觉AA评分略低了,反正感觉比千问要强不少。
ds和之前排名差不多啊,只是分低了一点
terra那么高?估计题目或者得分的权重有问题
deepseek的coding能力没有下降, 但是新的测试题里加入了一些科学前沿探索的内容, 这方面ds flash不行.
我还是不能接受GLM5.3和V4.1F同分,反正我自己实际做项目体感差异很大,5.3几乎极少大规模返工,V4.1时不时就会来一次
也可能是因为我用的是zcode(? 但是感觉客户端导致的差距不会有这么大吧
这claude haiku的刷榜也太夸张了,另一个榜单都看到haiku和fable打平了
只活在营销号嘴里的“性价比最强模型”
只是分数掉了吧 怎么感觉排名不是太剧烈
之前k3.1 pro比fable5.1高2分 现在是低3分
不过这个sonnet 5.5的位置他对吗。。。。
还有6.1 terra 他对吗。。
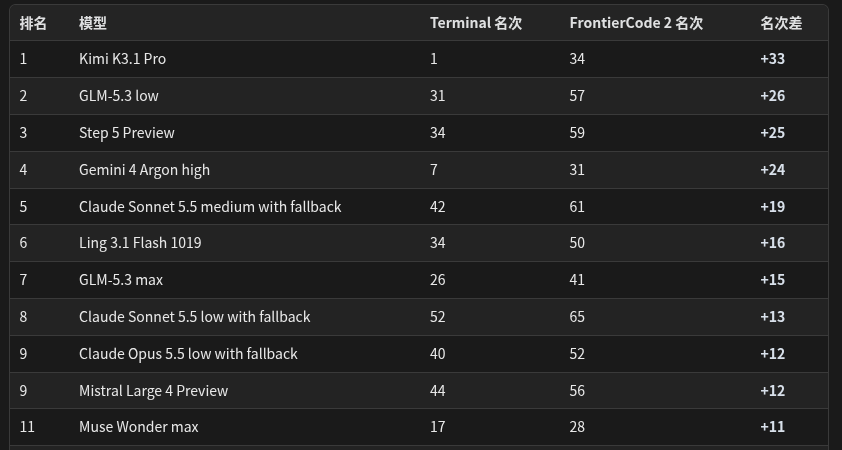
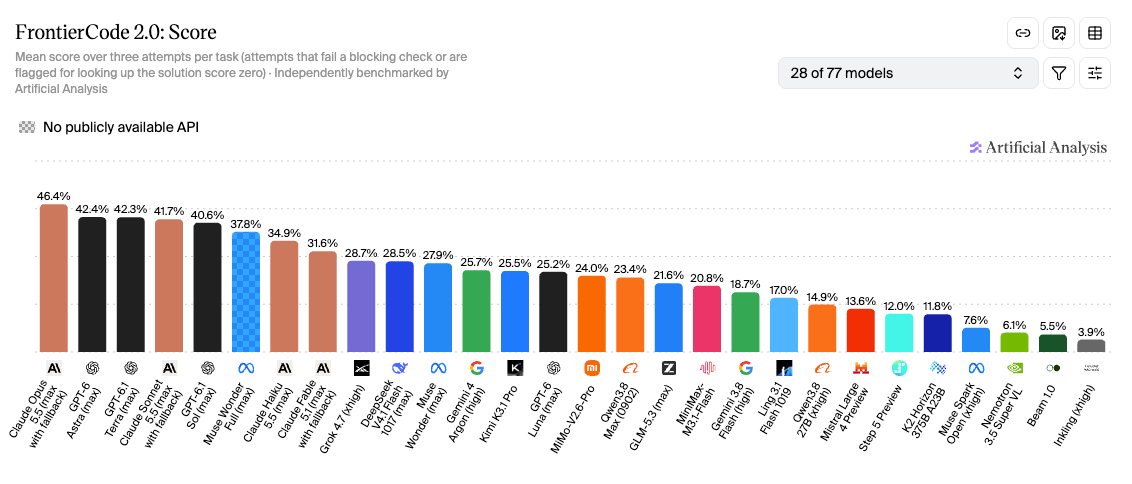
新引入的代码benchmark
不知道测试的智力在推理什么东西
这排名和实际用的体感差距很大
大概是顶尖模型已经超出了我的水平太多了
而我只能看出 agentic 行不行
Sonnet 5.5 的分数,我觉得有点不符合
难道没人提到muse吗?这东西真有人在用还是已经无人在意了?
估计好多人都没用过,之前opencode有免费的,现在都不知道哪里可以用。