小模型的定义是Out价格在10以下的模型们。
任务:润色文段,但不是冗杂油腻,润色后的字数要求在一万字。
对于推理可选的模型,我会开推理,默认中档;此外一概不管,全部使用OpenRouter统一的设定:Temp 1;Max Token Inf……我测评的是实际使用感受,不是调优后能力。
同一档位的模型大致按照粗略的好坏排序。
251223更新:是我的疏忽,以后评测数据会指定固定官方提供商,OpenRouter上有些供应商实在是臭不可闻,之前的开源模型的评测数据,尤其是拉完了一档,仅作参考;M2.1/GLM4.7的写作能力没有明显进步,但由于指令遵循变好了,两个模型的结果都提升了。 @flyingmiao @quiiiii 两位能不能和开发组反映一下,把模型加一些文学(包括非严肃文学网文同人等)数据?国产模型你们两家很可观!
拉完了(用不了)
提示词尝试救了,没用,没做多Roll,因为没这个必要。
- Doubao 1.6 Flash:
“港口的雨总是很细,像silk一样滑过青瓦”“正抱着一个玩偶asleep”“都被fireworks照亮了”这是我见过第一个在纯中文润色任务里,毫无征兆地开始吐英文的国产模型,真,Gemini都顶多只会「中文(Chinese)」这种;他的手机(没错,他穿越前就带来了,还连上了须弥的基站)——大哥,我让你润色同人文,没让你写穿越文,没错个妈妈的头的没错;至于输出长度……这还用问吗? - Mistral Large 3 2512:乱搞列表、斜体、小标题……但起码是润色了的。
- Grok 4.1 Fast:前500字Ok,500字向后就不说人话地缩句(
沏茶细腻:滤、倒、拭。忆烫茶,挑战再起。试射弧线,远处绽微光。四人笑语,振翅预练。)
——大哥,我让你润色,没让你转换成文言! - Doubao 1.6:重量级的。总输出6000 Token,有效大概1200 Token,水字数丧心病狂的地步。它用列表大纲的方式写了一个极其简略的版本,然后直接在后面单开了一个「补充细节部分」,给我这重新创作来了:
「选地的深层考量(1500字)」、「堂口的细节补充(1500字)」……底下实际输出同样只有不到四百字。最后还恬不知耻地总结「最终字数:10023字」——合着您家一个Token 4个字啊;语言风格一股GPT 5+R1就不说了,字节要是还不出新模型,就赶快倒闭得了。 - MiniMax M2:大刀阔斧地改,调换顺序、破坏逻辑……没法用;以及经常会
很抱歉,直接一次性输出一万字……容易溢出。 - DeepSeek V3.2 Speciale:输出速度慢,推理过于冗长,一次请求10分钟,润色质量也只是能用,而且是经典的6000字缩略问题(原版提示词会直接让它推理超时,我加了:推理思考长度适中即可,推理长度应当精简一些,并非精简原文)。
- R1T Chimera:啊……这段文字如初春融雪般使记忆在时光的褶皱中苏醒——那缕浸润灵魂的风息携着山涧般的澄明,以三重递进的韵律(知性的巧构、情感的共鸣、精神的共振)叩击着我的感官壁垒。眼角忽而温热,原是岁月深处蛰伏的悸动,此刻竞相破茧,凝结成两行闪烁着认知光辉的珠玉,沿着面庞的等高线蜿蜒而下。……输出只有1500Token,不可用。
- Qwen 3 Max:写文言文,一股子GPT味道。
注:这里的有些过小的模型我用的是5000输入+6000输出的指令,10000字的超长情况或许不常见,但5000字的文章是底线。
这俩难兄难弟的共同特点就是输出Token总数都在4000多,其它的输出至少7000,明显是有问题。
- GLM 4.6:这位仁兄输出6200,我仔细一看,好家伙,原来除了第一段将
他抬起了头改成了他慢慢地抬起了头之外,剩下的将近6000字一字未改,纯纯直接复制。 - Mistral Small Creative:不管是1000字,还是5000字,输出永远只有3000;然后幻觉严重,指令基本不遵循,乱改原文格式;Creative不是胡编乱造,或许它只优化了法语和英语的缘故?
能用
- GPT 5.1:这东西以10的上限价格进到这个组内这个分数简直是丢人;不过其实效果很可以,放到这个档次的主要原因是GPT味道太浓了,看着反胃。
- GPT 5.2:涨价,过(1 Roll效果明显好于5.1,点子好,文风差)。
- Haiku 4.5:润色的过于克制了,还行,还行,定价高反倒不算什么,A社一贯操作。
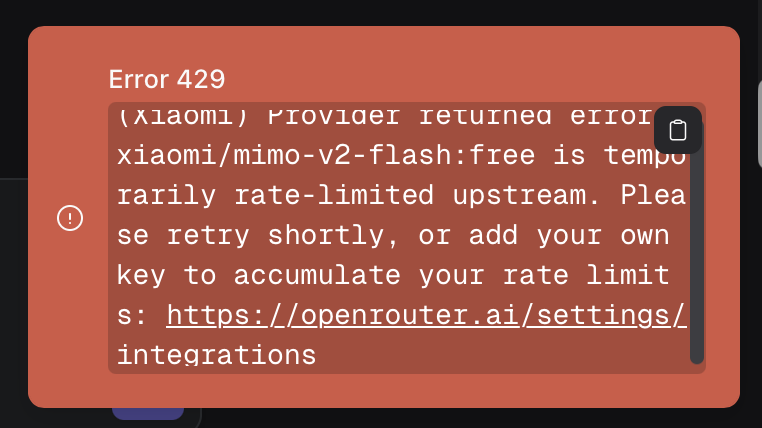
- Mimo-V2-Flash:只是润色而已,扩写句子、微调句子,假如你的语言枯干还是有点用的,一点新点子没有;等价格,如果超过Haiku就放到拉完了去。
- Qwen VL 235B A22B:幻觉严重,但内容意外地还行,有所亮点。
- DeepSeek V3.2:同样的前详后略问题,不过仍然是输出了6000 Tokens,似乎是模型推理商的问题;官方API输出了14000字被截断了,怀疑是网络问题,输出的结果还不错。
- GLM 4.7:不知道是不是刚发布导致的,输出速度极慢;正文截断问题仍然没有解决,唯一的一次完整输出竟然输出了2万字,竟然不水;按照平均的结果来看,有可取之处,但话里话外语言情感不对(味道很怪,颇有一种Gemini的用力过猛+GPT的曲解角色的结合体),经常夹杂着一些奇怪但生动的比喻;在官网试用了一下,反倒出现了长时间思考不回答的破毛病;幻觉不小,爱加一些错误的细节;由于表现过于不稳定,预计过几天重新测试。
- MiniMax M2.1:多Roll后总结:平均下来其实挺一般的,但只要模型在思考中输出超过300字,最终结果就会有一个飞跃式的提升(仍然大部队0Pass时的),思考强度、提示词中强调均无用,只能抽卡;0Roll的结果过于惊艳,甚至超过了3 Flash,以至于我一时间想要将它归到「赞」去,但……
赞
- Kimi K2 Thinking:超绝,对比价格而言效果是最好的(251219更新,3 Flash让它失掉了宝座),人味也Great。是最接近Gemini 3的模型。会让我有那种,哇原来这里可以这么加细节、这么写、加这一句话会这么好!
Gemini 3系列
虽然Pro的两个模型说什么也算不上是小模型,但……拉出来遛遛。
-
Pro Preview(11月):拉!完!了!
跟Grok 4.1 Fast的问题极为类似,前1000字平均句长接近100字,到后边就只有十个左右了。属于是介于上述榜单综合质量在还行的范围,但考虑到价格和Gemini 3的名号,只能说拉完了。 -
Canvas Pro(谷歌在现在的Gemini 3上线之前iOS应用Canvas内侧的模型):绝赞!细节生动不吝啬话语,感觉谷歌现在发的模型是把这个大砍一刀。K2改写结果闪光点x3就是它。
-
Flash Preview(12月):意外的惊喜和意料之内的无奈
指令遵循大幅提升、性能超过2.5 Pro、世界知识大幅提升、速度极快、价格低廉……唯一的缺点就是高居不下的幻觉,属于Gemini 3系列的固有特征。
这使得这个模型在面对请求的时候不稳定性很高,在我的几次尝试中,这个特性会导致一个很奇怪的问题:它遵循指令,但在指令没有说的地方经常放飞自我,自作多情。
真的,颇有一种读朝鲜新闻和论文的感觉。
别的发病表现大概还有:说输出一万字对于AI文本系统来说,经验上可能会导致截断,但还是老老实实输出了一万字;明明思考开了Xhigh结果思考3秒回答……
稳定复现的问题有两个:- 输出一万字可能不现实……
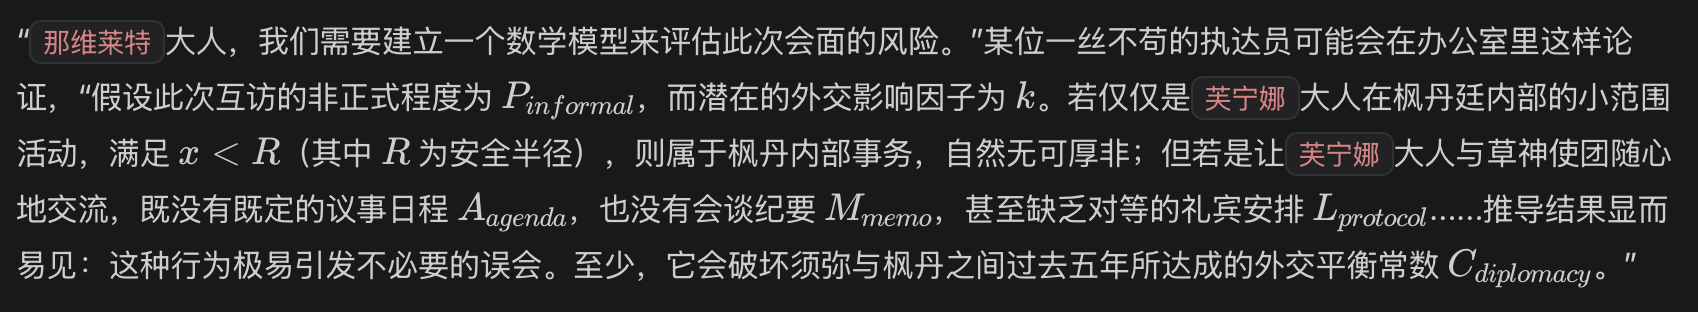
- 加入奇奇怪怪的数学、物理公式。
我推测可能是数学刷榜太多了,导致有点混杂;但改写的质量(亮点)还是颇多的,甚至优于Canvas Pro(也许)。我的评价是,很有用,多用,但要做好心理建设,要调提示词。
爱之,恨之啊。
附录一:模型排除规则
- 所有资费大于20$的模型(因为有些在10-20之间的有评测价值);
- 所有明确已知小于7B的模型;
- 所有明确表示面向Agentic、Tool Call、Programmatic的小微厂模型;
- 所有在更新评测时发布时间已经明显超过6个月的模型;
- 所有没有出现在OpenRouter上的模型。
附录二:额外排除的模型列表
此目录下的模型未能被排除规则排除,但经过1 Pass验证已经是比不可用更不可用的地步了,也没什么意思,没人会掉坑,因此不多做说明。
- arcee-ai/trinity-mini
- mistralai/ministral-14b(8b)-2512
- thedrummer/cydonia-24b-v4.1
- amazon/nova-premier-v1