pymupdf将pdf拆分为图片时出现图像质量差的问题怎么处理?

佬们,目前在项目中有一个前置步骤,将工程图纸拆分为图像。但是问题就出现在pymupdf依赖,这个依赖会将较细的线条进行抗锯齿处理,导致整个画面一片“灰白”。以下是原pdf:


pymupdf不做任何处理提取的图像:

然后我对其方法降低了抗锯齿等级:
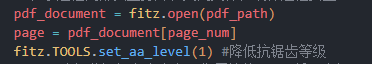
image
目前图像质量是清晰了许多,但是随之而来的是:文字部分因为抗锯齿等级的降低,导致边缘无法平滑过渡,文字会出现断线的情况,拆分后的原图如下:

使用版面识别模型提取出来的表格如下:

想请问各位佬友们,有什么替代的方式来进行pdf拆分为图像吗?或者对于pymupdf的依赖还有什么隐藏的参数可用设置吗?

2 个赞

pdf方便发出来嘛

220S-25204S-T0102-04.pdf (722.0 KB)

这个库怕是不得行了,得另找法子

试试GitHub - oomol-lab/pdf-craft: PDF craft can convert PDF files into various other formats. This project will focus on processing PDF files of scanned books. 呢?

截图出来的都模糊