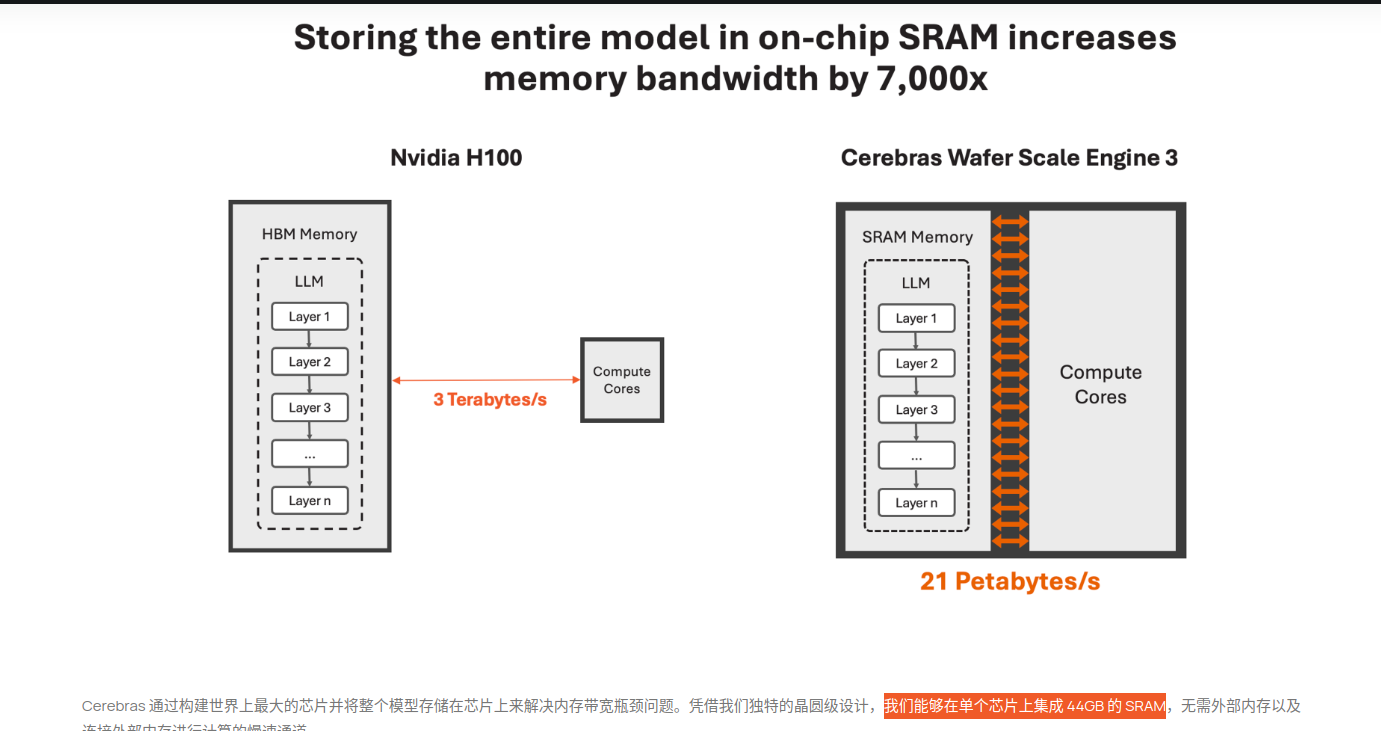
曾造出世界最大芯片公司Cerebras,刚刚发布了全球最快的AI推理架构——Cerebras Inference。

运行Llama3.1 8B时,它能以1800 token/s的速率吐出文字。
另外,对于70B参数的Llama3.1,可达到450 token/s及时响应。

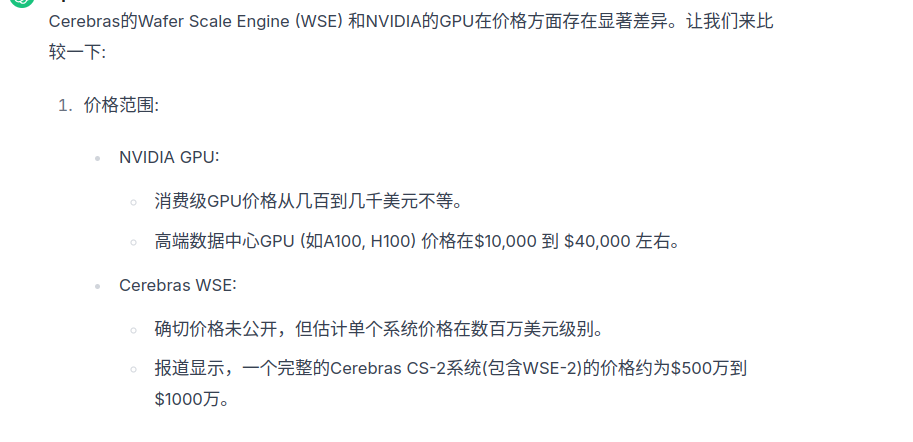
最关键的是,价格还实惠。

根据官方API定价,Llama 3.1 8B每百万token仅需10美分,Llama 3 70B每百万token仅需60美分。

Cerebras 推理 API 提供了性能、速度、准确性和成本的最佳组合。它以每秒 450 个令牌的速度运行 Llama3.1-70B,是唯一以瞬时速度运行 Llama3.1-70B 的解决方案。我们使用 Meta 的原始 16 位模型权重,确保最高的准确性。在发布时,我们每天为开发人员提供 100 万个免费令牌。对于大规模部署,我们的定价只是流行 GPU 云的一小部分。
以上信息来摘抄自官网 https://cerebras.ai/blog/introducing-cerebras-inference-ai-at-instant-speed