首先是价格:与 Opus 4.6 价格相同。每百万输入 token 5 美元,输出 token 25 美元。
全平台可用:claude.ai、API、Bedrock、Vertex AI、Microsoft Foundry。
有四项重要改进:
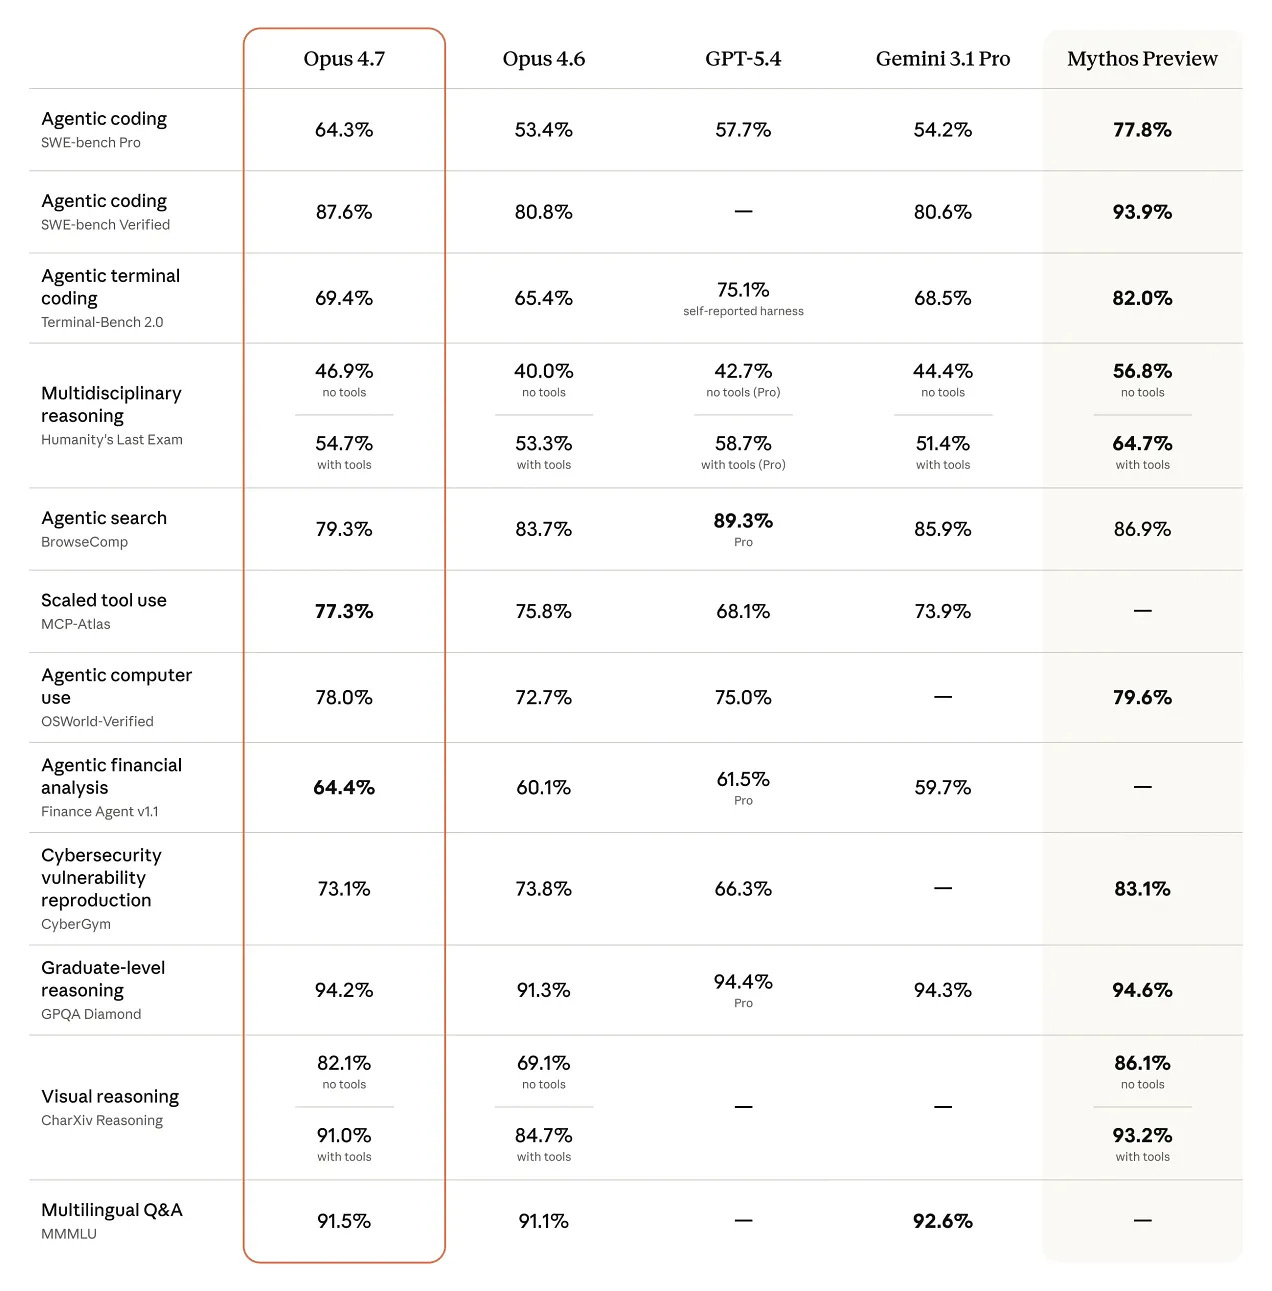
基准对比表格展示了 Claude Opus 4.7 在 14 个类别中与 Opus 4.6、GPT-5.4、Gemini 3.1 Pro 和 Mythos Preview 的对比结果。Opus 4.7 列以橙色高亮显示。智能体编码 SWE-bench Pro:Opus 4.7 为 64.3%,Opus 4.6 为 53.4%,GPT-5.4 为 57.7%,Gemini 3.1 Pro 为 54.2%,Mythos 为 77.8%。SWE-bench Verified:87.6% 对比 80.8% 对比 80.6% 对比 93.9%。Terminal-Bench 2.0:69.4% 对比 65.4% 对比 75.1% 对比 68.5% 对比 82.0%。BrowseComp:79.3% 对比 83.7% 对比 89.3% 对比 85.9% 对比 86.9%。Finance Agent:64.4% 对比 60.1% 对比 61.5% 对比 59.7%。GPQA Diamond:94.2% 对比 91.3% 对比 94.4% 对比 94.3% 对比 94.6%。CharXiv 无工具:82.1% 对比 69.1% 对比 86.1%。MMMLU:91.5% 对比 91.1% 对比 92.6%。 Opus 4.7 横跨 14 项基准测试。在编码、视觉和金融分析方面领先。在 Terminal-Bench 和 BrowseComp 上落后。Mythos Preview 仍在各方面保持领先。
*数据来源:Anthropic,2026 年 4 月。*
先来看数据: SWE-bench Verified:87.6% 对比 Opus 4.6 的 80.8%
SWE-bench Pro:64.3% 对比 53.4%
计算机使用(OSWorld):78.0% 对比 72.7%
视觉推理(CharXiv):82.1% 对比 69.1%
金融分析:64.4% 对比 60.1%
GPQA Diamond:94.2% 对比 91.3%
总体而言,特别是在智能体和编码工作负载方面(Claude 历来领先的领域),Opus 4.7 扩大了优势,而非让步。
一个坦诚的提醒:Terminal-Bench 2.0 是退步。GPT-5.4 在该项得分 75.1%,而 Opus 4.7 为 69.4%。BrowseComp 相比 Opus 4.6 也有所下滑。如果这些工作流对你很重要,值得留意。
值得关注的 4 项变化:
- 3 倍分辨率视觉
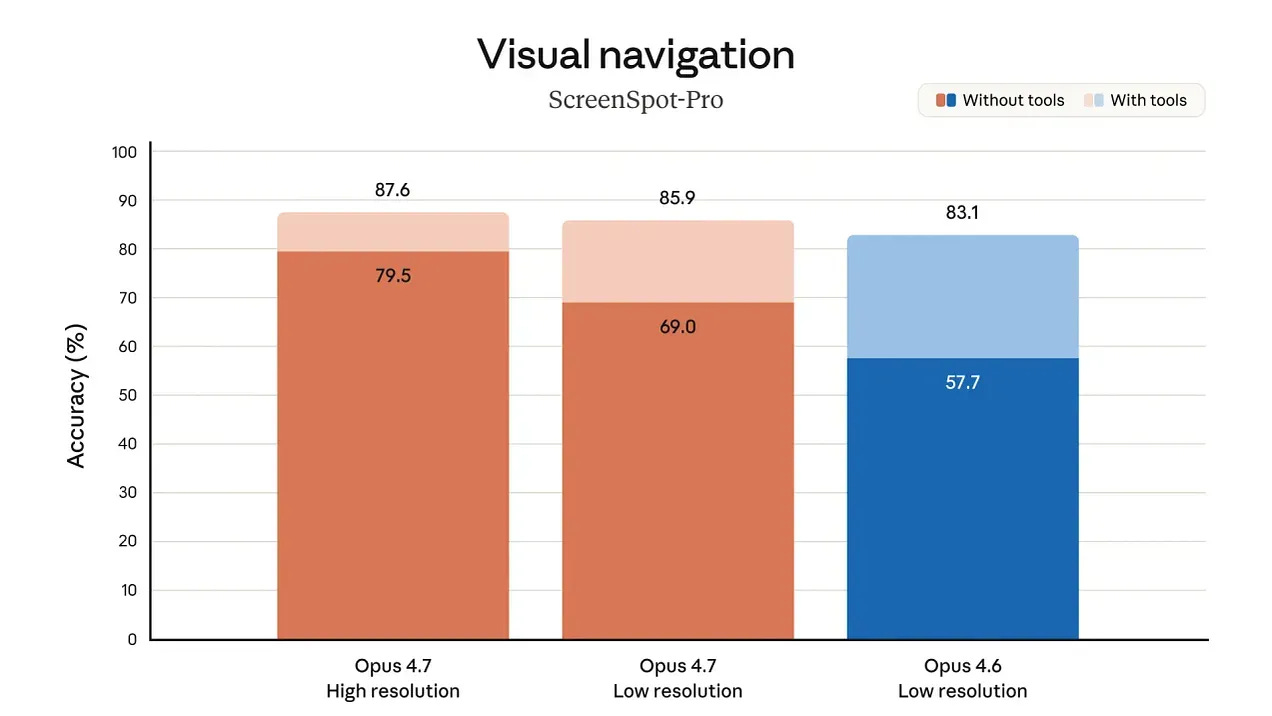
高分辨率视觉是截然不同的体验。Opus 4.7 在完整分辨率下,无工具视觉导航得分 79.5%,而 Opus 4.6 为 57.7%。来源:Anthropic,2026 年 4 月。 Opus 4.7 接受最长边达 2,576 像素的图像,约 375 万像素。Opus 4.6 最高仅 115 万像素。截图、密集图表、设计原型、文档:现在都能以真实保真度呈现。
- 指令遵循更字面化
Opus 4.6 对指令解释较宽松,有时会跳过步骤,而 Opus 4.7 执行得更精确。这几乎总是好事。实际影响:为旧模型编写的提示词偶尔会产生意外结果。切换生产流量前请重新调优。
- 新的 xhigh 努力级别
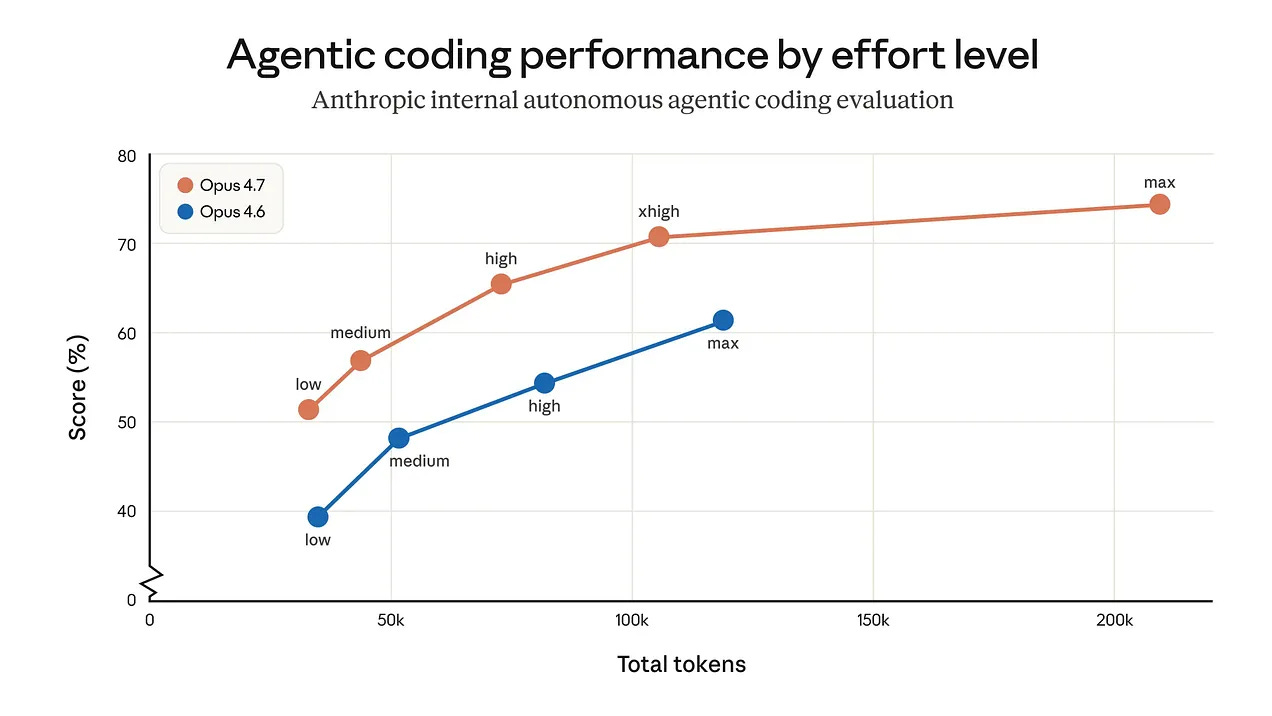
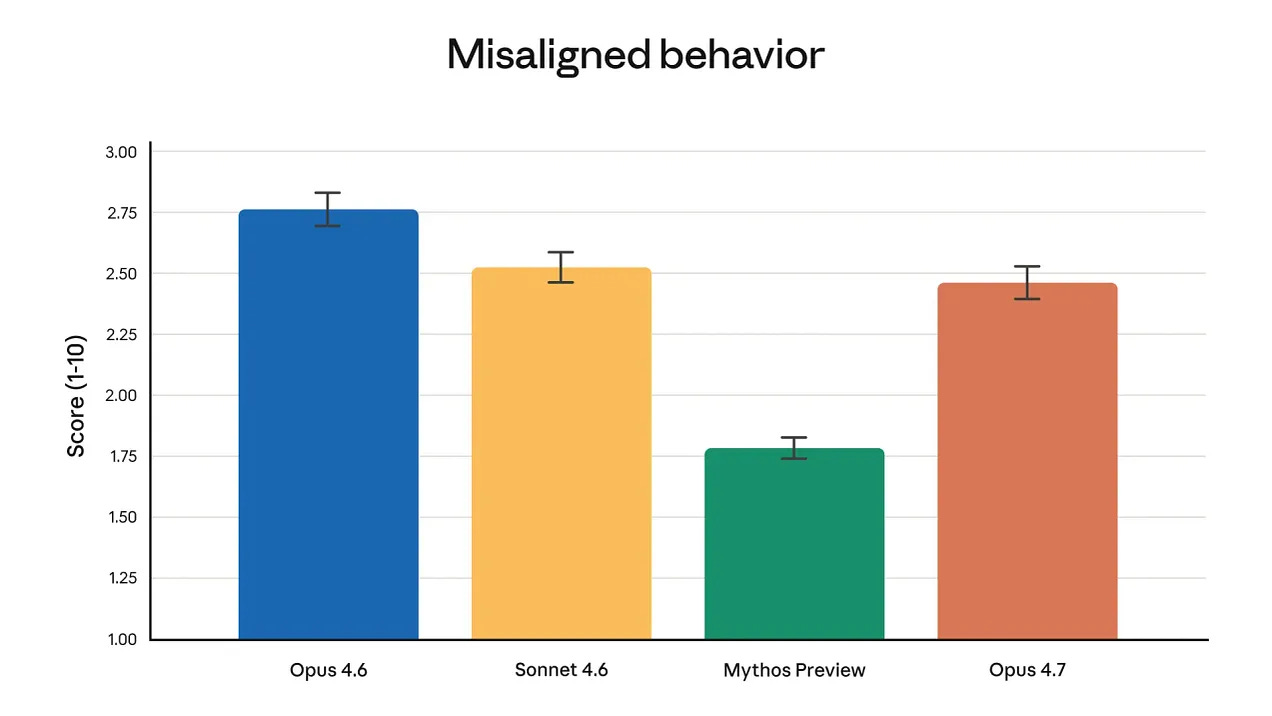
Opus 4.7 在对齐行为方面相比 Opus 4.6 有适度改进。Mythos Preview 仍是 Anthropic 训练过的对齐性最好的模型,优势明显。 在高和 max 之间新增了一个设置,可更精细地控制推理与延迟的权衡。Anthropic 建议在编码和智能体用例中从 high 或 xhigh 开始。Claude Code 现在默认对所有套餐使用 xhigh。
- 更好的基于文件的记忆
在长时间会话中读写草稿本或笔记文件的智能体,行为明显更可靠。之前会丢失上下文的多会话工作,现在能保持一致。
网络安全保障背景: Opus 4.7 是首款搭载自动化检测和拦截违规网络安全用途功能的 Claude 模型。这直接继承自上周的 Mythos Preview 和 Project Glasswing。
“我们曾表示会将 Claude Mythos Preview 的发布保持受限,并先在能力较弱的模型上测试新的网络防护措施。Opus 4.7 就是首个这样的模型。”
*数据来源:Anthropic,2026 年 4 月。*
从事合法工作的安全专业人士可申请加入 Anthropic 新的网络验证计划。
折线图标题为"Anthropic 内部自主智能体编码评估中不同努力级别的智能体编码表现"。X 轴显示总 token 数从 0 到 20 万。Y 轴显示得分百分比从 0 到 80。Opus 4.7 的橙色线从低努力的 51% 开始,经过中努力 57%、高努力 65%、xhigh 在 10 万 token 处达 71%,在 20 万 token 处达 max 的 74%。Opus 4.6 的蓝色线从低努力的 39% 开始,经过中努力 48%、高努力 54%,在约 12 万 token 处达 max 约 61%。Opus 4.7 在高和 max 之间新增了一个 xhigh 数据点,这是 Opus 4.6 没有的。 在每个努力级别,Opus 4.7 都优于 Opus 4.6 的同级表现。新的 xhigh 在 10 万 token 处得分 71%,已超过 Opus 4.6 在 20 万 token 处的 max 表现。
总体来说提升不大,小版本更新!