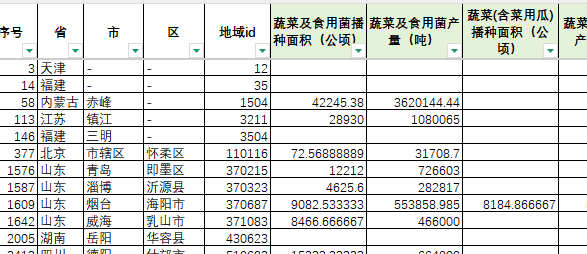
最近的工作是想办法自动化批量从下载的各地的统计年鉴pdf Excel中读取想要的板块数据,然后按照要求的字段提取出来 ,尝试用codex写python脚本实现但是效果都不好,主要每个地区年鉴格式不一样,表头、单位、年份、地区行都不统一,然后字段口径容易混,基本都是AI coding 出来的 不知道怎么推进了 因为让codex改来改去都有新的bug 
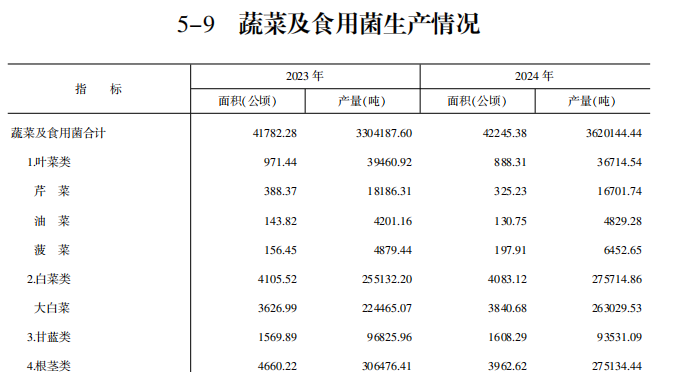
需要提取的内容如这样 落表应该像这样
这种把需求描述清楚和 ai 多拉扯几轮基本就可以了 多给 AI 一些有价值的参考信息
没有固定模板那属实难搞 要么兼容N个模板  别让AI给你写程序了 直接文件丢AI
让AI给你数据结果吧
直接让 AI 识别文字发给你- - 用 ai 的多模态来做得了,
我也是说想这样 不过要做全国的不想付费上班 可恶!
豆包或者gpt不能读出来吗,可能多的话它会有点小问题
我做的小程序自动识别截图里面持仓信息就是用 GLM-4.6V,便宜,比传统 OCR 还是准确一点的
你看看这个是否合适,minimax的开源skill套装,包含了office全家桶和pdf的skill
需要截图先让ai自梳理描述清楚准确开发要求,再让ai去开发。推荐gpt5.5梭哈。推荐一个skill:grill-me 。把需求文档至少让他问你50个问题,对接好需求。再开发
excel有点经验,pdf没怎么玩过,不管是python还是php理论上都可以读的,你可以这样给ai说,就是有个基础的表头业务做归档,没有的新增 有的话和你自己的需要的表头吧这条数据拿出来丢新的csv或者直接生成你需要的就好了 简单来说读取 然后匹配再保存即可
pdf github上一个叫 Marker 的项目,挺好用的,似乎可以先批量pdf转md,再给ai处理后续内容。
这个skills基本不能用,很烂,需要下载各种包。不推荐使用。
看看一些OCR的服务,我之前弄过电子发票的识别,感觉效果还可以。
省市县三级就让AI穷举所有表头了,然后明年就轻松了 
很难,之前兼职接单就是从类似数据的pdf里面提取数据落表的,每个源也是格式不一样,都是ai加python加人工介入解决的。