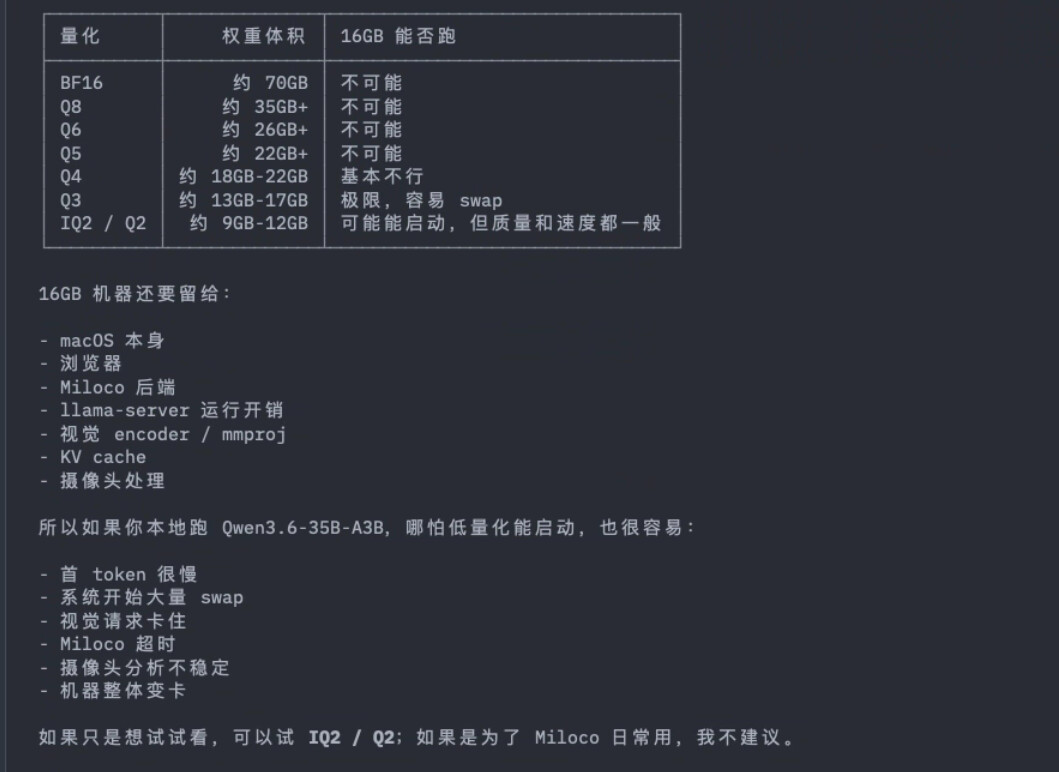
之前看到miloco一直被8G显存和30系列显卡劝退,也一直担心云端的隐私安全问题,但是现在有了macmini后这些问题就迎刃而解啦:
如题,介绍一下大致流程:
目标:
- Miloco 后端和 Web 页面运行在本机
https://127.0.0.1:8000 - 本地视觉模型使用 Xiaomi MiMo-VL-Miloco-7B GGUF,通过
llama-server提供 OpenAI 兼容接口 - 规划/对话语言模型走云端 OpenAI 兼容接口
- 米家摄像头、本地视觉理解、米家通知、米家设备控制可联动
以丐版为例(主要我的就是丐版  )
建议配置:
- macOS,Apple Silicon
- Python 3.12
- Homebrew
- 16 GB 以上可用磁盘空间
- 和米家摄像头处于同一个局域网
1. 安装基础依赖
brew install python@3.12 git git-lfs expat llama.cpp jq sqlite
如果没有安装 Homebrew,先安装:
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"
确认版本:
python3 --version
llama-server --version
2. 获取 Miloco 源码
cd ~/Documents
git clone https://github.com/XiaoMi/xiaomi-miloco.git
cd xiaomi-miloco
进入项目目录:
cd ~/Documents/xiaomi-miloco
3. 创建 Python 虚拟环境并安装后端
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install -U pip setuptools wheel
pip install -e miot_kit
pip install -e miloco_server
macOS 上如果遇到 expat 动态库加载问题,启动后端时需要设置:
export DYLD_LIBRARY_PATH="/opt/homebrew/opt/expat/lib:${DYLD_LIBRARY_PATH:-}"
4. 下载本地 7B 视觉模型
安装 Hugging Face CLI:
source .venv/bin/activate
pip install -U huggingface_hub
下载 Xiaomi MiMo-VL-Miloco-7B GGUF:
huggingface-cli download xiaomi-open-source/Xiaomi-MiMo-VL-Miloco-7B-GGUF \
  MiMo-VL-Miloco-7B_Q4_0.gguf \
  mmproj-MiMo-VL-Miloco-7B_BF16.gguf
5. 创建启动脚本
项目根目录创建后端启动脚本 start-miloco.sh:
#!/usr/bin/env bash
set -euo pipefail
cd "$(dirname "$0")"
export DYLD_LIBRARY_PATH="/opt/homebrew/opt/expat/lib:${DYLD_LIBRARY_PATH:-}"
export MILOCO_SERVER_STORAGE_DIR="${MILOCO_SERVER_STORAGE_DIR:-$PWD/.temp}"
exec .venv/bin/python scripts/start_server.py
创建视觉模型启动脚本 start-miloco-vision.sh:
#!/usr/bin/env bash
set -euo pipefail

MODEL_FILE="${MILOCO_VISION_MODEL_FILE:-MiMo-VL-Miloco-7B_Q4_0.gguf}"
MMPROJ_FILE="${MILOCO_VISION_MMPROJ_FILE:-mmproj-MiMo-VL-Miloco-7B_BF16.gguf}"
HF_CACHE_ROOT="${HF_HOME:-$HOME/.cache/huggingface}/hub/models--xiaomi-open-source--Xiaomi-MiMo-VL-Miloco-7B-GGUF/snapshots"

if [[ -n "${MILOCO_VISION_MODEL_DIR:-}" ]]; then
  MODEL_DIR="$MILOCO_VISION_MODEL_DIR"
else
  MODEL_PATH="$(find "$HF_CACHE_ROOT" -maxdepth 2 -name "$MODEL_FILE" -print -quit 2>/dev/null || true)"
  if [[ -z "$MODEL_PATH" ]]; then
    echo "Cannot find $MODEL_FILE under $HF_CACHE_ROOT"
    echo "Set MILOCO_VISION_MODEL_DIR to the directory containing the GGUF files."
    exit 1
  fi
  MODEL_DIR="$(dirname "$MODEL_PATH")"
fi

if [[ ! -f "$MODEL_DIR/$MODEL_FILE" || ! -f "$MODEL_DIR/$MMPROJ_FILE" ]]; then
  echo "Missing model files in $MODEL_DIR"
  echo "Expected: $MODEL_FILE and $MMPROJ_FILE"
  exit 1
fi

exec llama-server \
  -m "${MODEL_DIR}/${MODEL_FILE}" \
  --mmproj "${MODEL_DIR}/${MMPROJ_FILE}" \
  --host 127.0.0.1 \
  --port 8081 \
  -c 8192 \
  -ngl 99 \
  -np 1 \
  --alias miloco-7b \
  --no-ui \
  --media-path /private/tmp \
  --cache-ram 0 \
  --reasoning off \
  --reasoning-budget 0 \
  --reasoning-format none
赋予执行权限:
chmod +x start-miloco.sh start-miloco-vision.sh
关键参数说明:
-c 8192:上下文长度。低于这个值容易出现exceeds the available context size。--alias miloco-7b:Miloco 里配置的模型名。--reasoning off:减少模型输出<think>的概率。-ngl 99:尽量使用 Apple GPU / Metal 加速。
6. 启动本地视觉模型
新开一个终端:
cd ~/Documents/xiaomi-miloco
./start-miloco-vision.sh
验证模型服务:
curl http://127.0.0.1:8081/v1/models
能看到模型列表即可。
7. 启动 Miloco 后端
再开一个终端:
cd ~/Documents/xiaomi-miloco
./start-miloco.sh
访问:
https://127.0.0.1:8000
浏览器会提示本地 HTTPS 证书不受信任,继续访问即可。
8. 配置模型
进入 Miloco 页面后,先登录并授权米家账号,然后进入模型配置。
视觉理解模型
新增或编辑视觉模型:
用途:随便填
Base URL:http://127.0.0.1:8081/v1
Model:miloco-7b
API Key:可以填任意非空值,例如 local
保存后设为当前视觉模型。
规划/对话语言模型
新增或编辑云端语言模型:
用途:规划/对话
Base URL:你的 OpenAI 兼容接口地址,例如 https://example.com/v1
Model:你的云端模型名
API Key:你的服务商密钥
保存后设为当前规划模型。
如果云端服务返回 Your request was blocked,一般不是本地视觉模型问题,而是云端代理拦截了请求。需要换可用的 OpenAI 兼容服务,或调整代理侧策略。
至此配置完成,愿诸君都能和我一样愉快玩耍
纯手打,为什么被识别ai啊