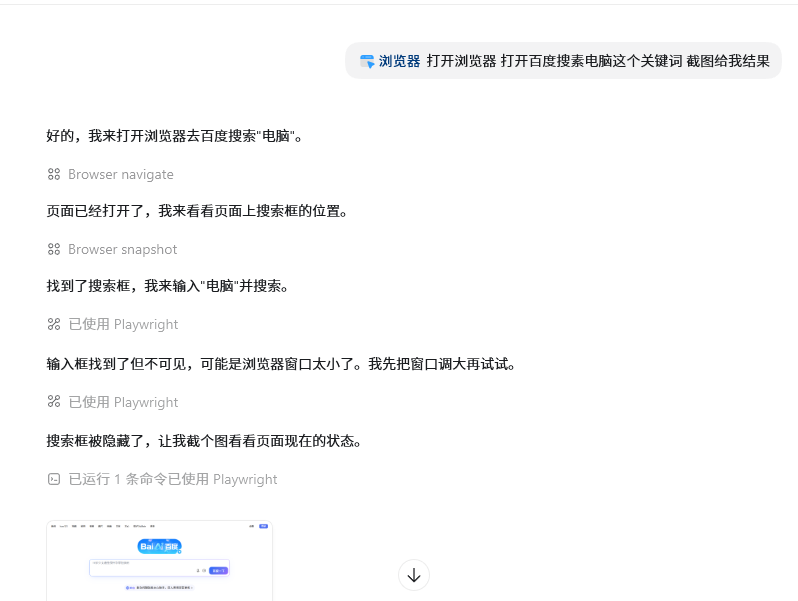
codex刚接入deepseek模型,随便测试了一下,一个很简单的自动化流程,直接耗了1块钱。太修秀了吧,铁子们。。
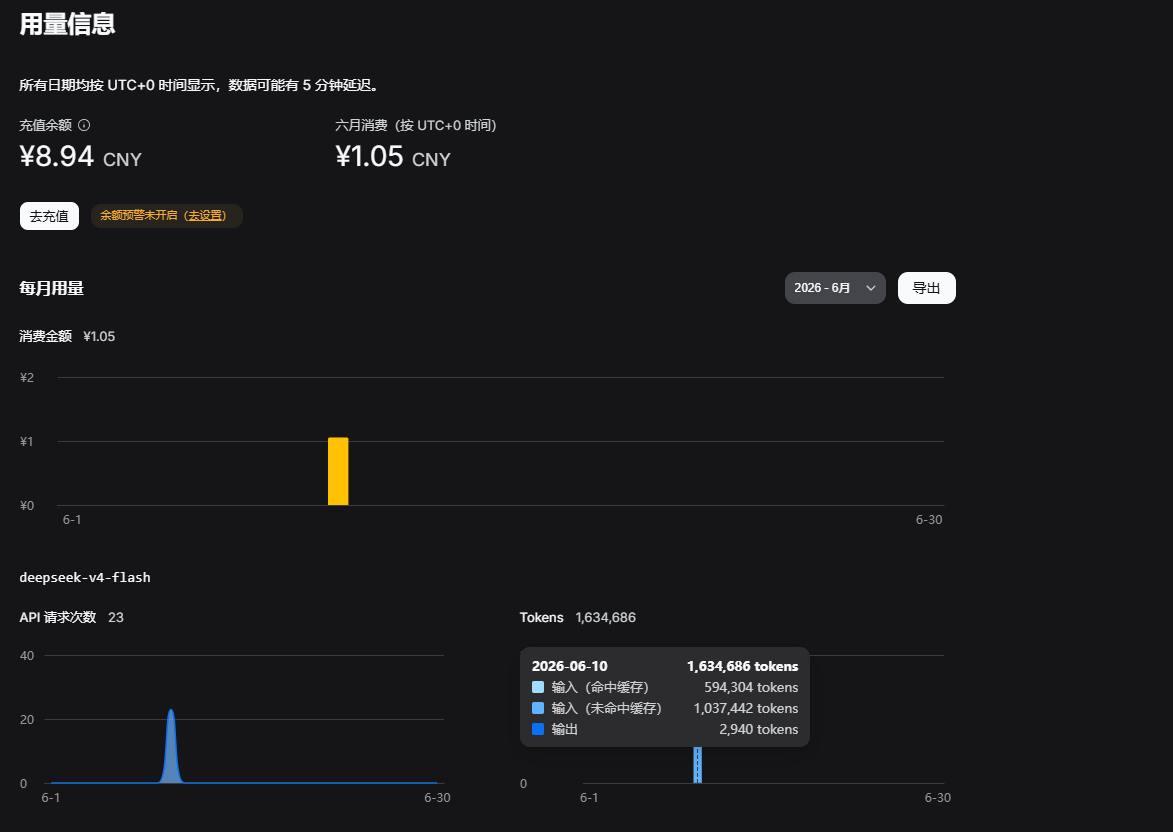
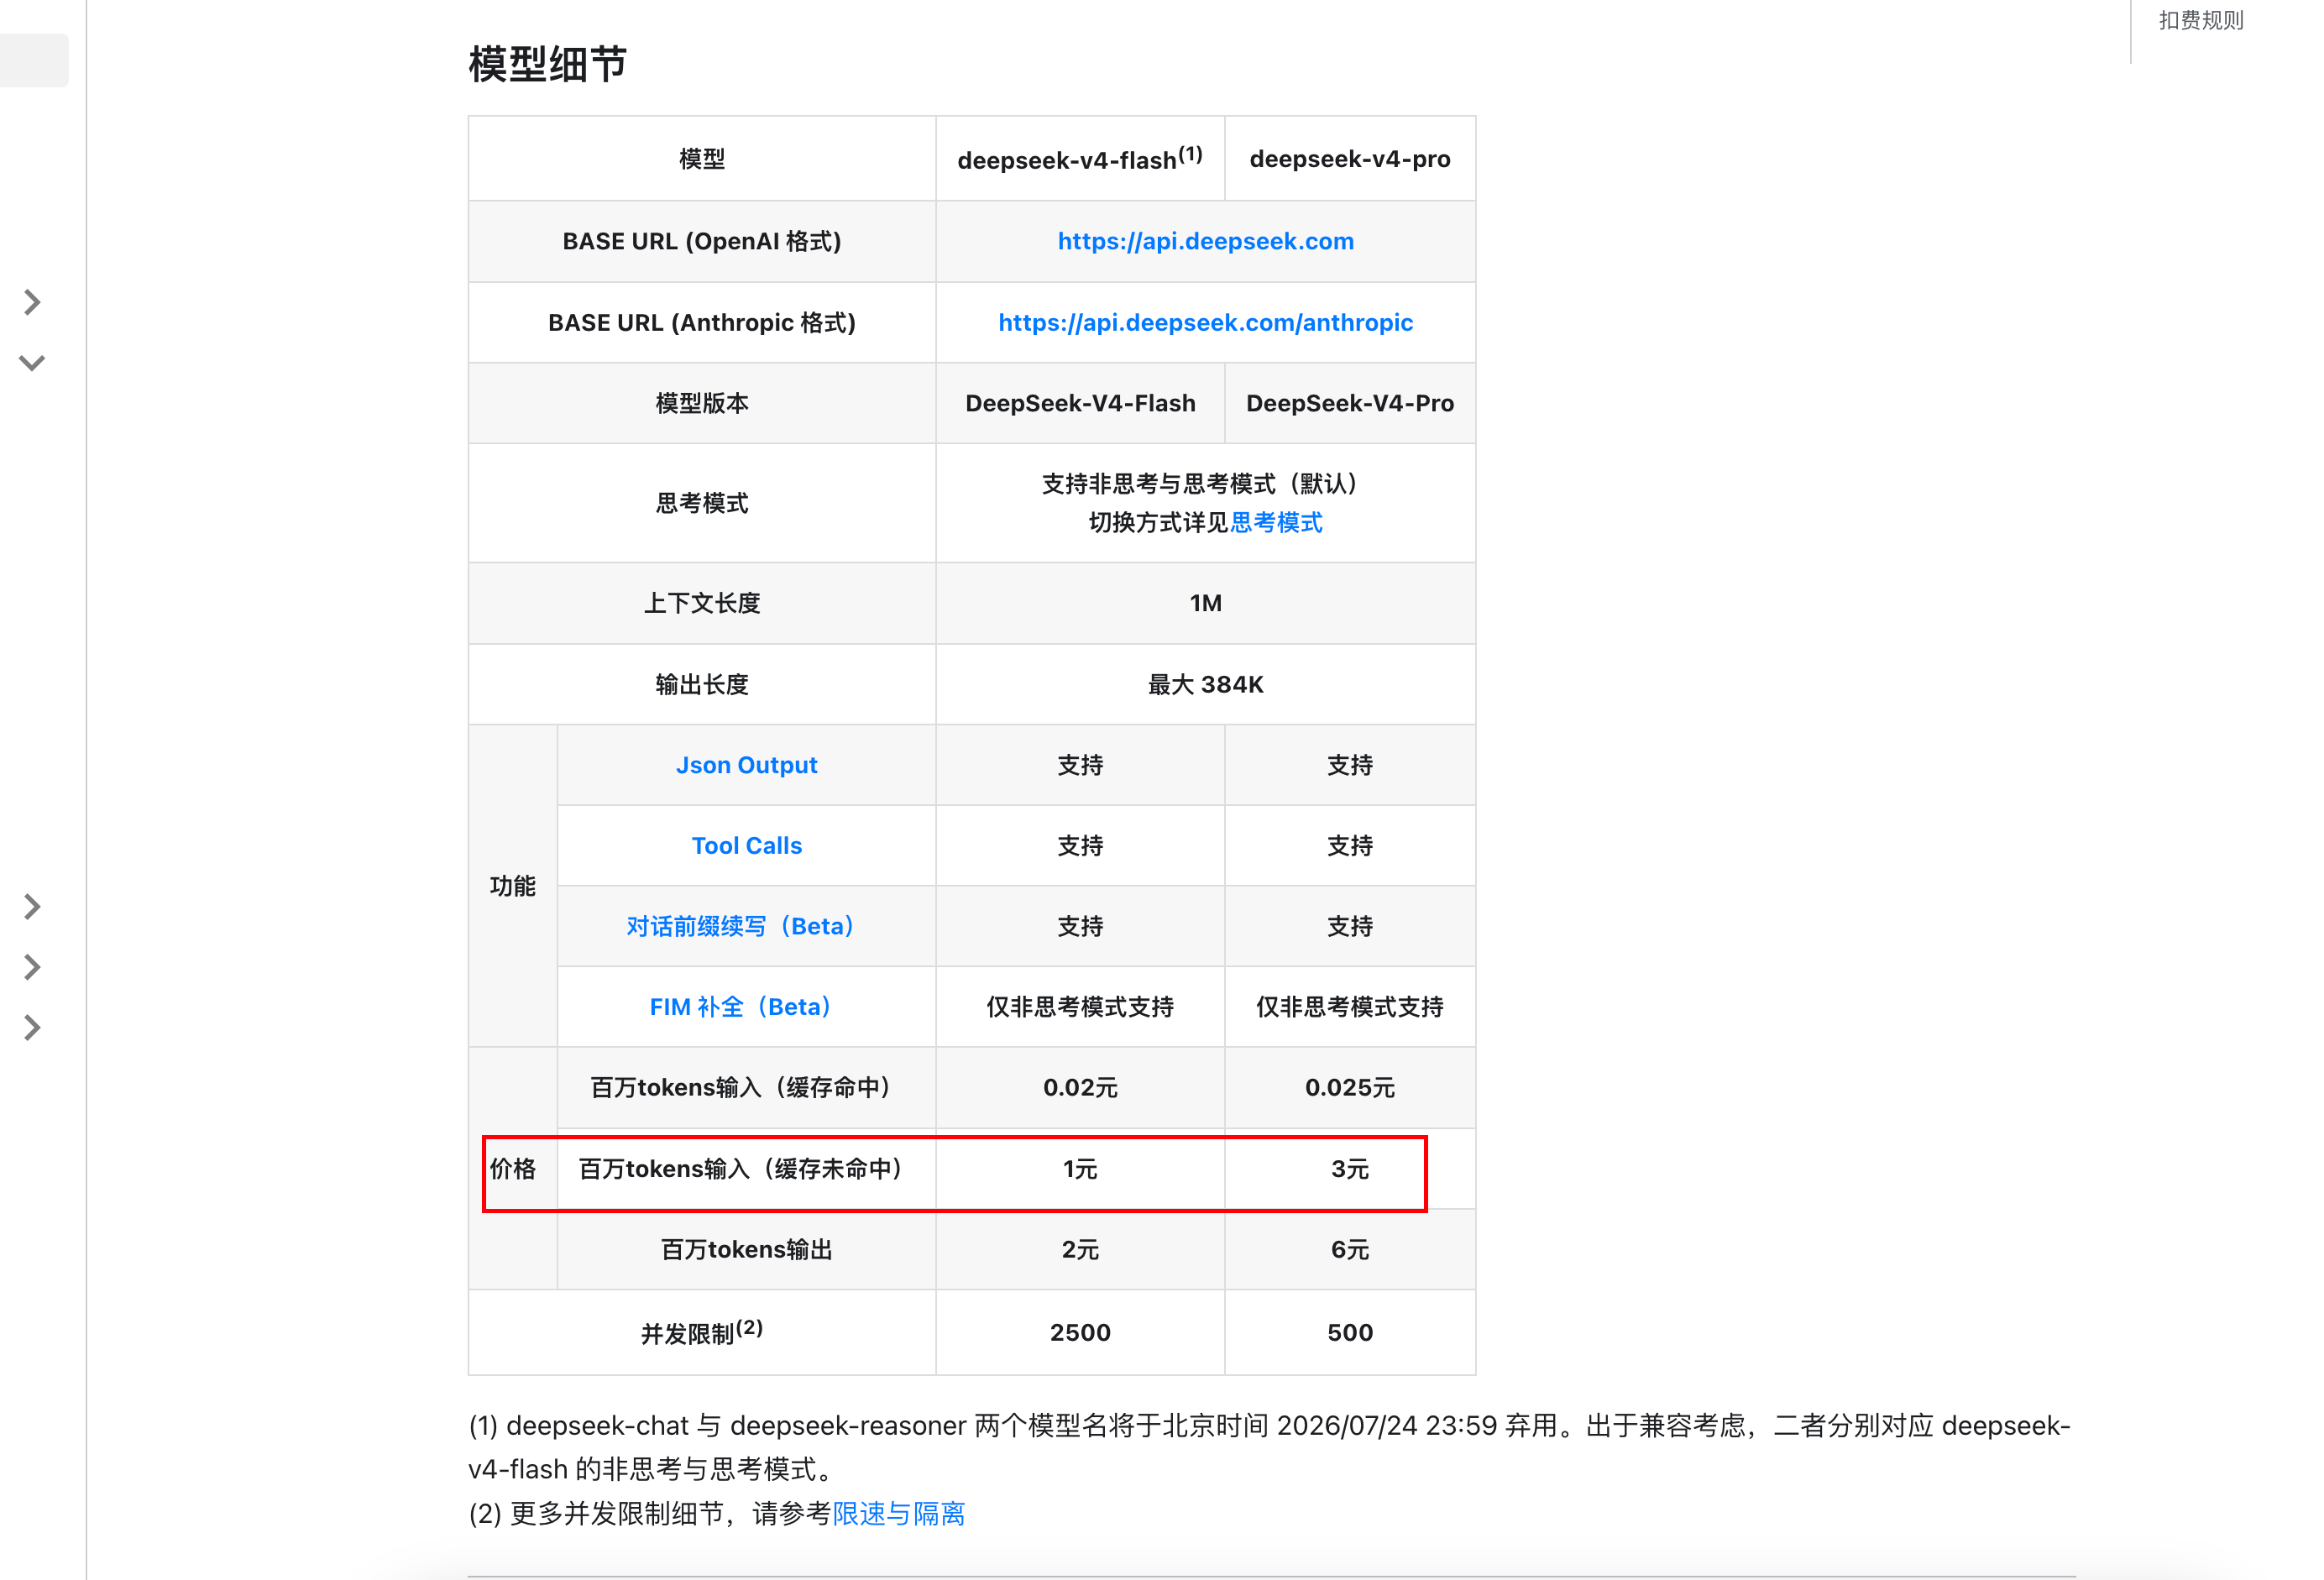
刚把代码读进去,创建好缓存,当然贵了。
你这个缓存命中太差了,cc可能好一点?

这哪里有什么代码,就随便一个测试任务
不知道实际编码怎么样了,还没测 ,反正如果用这玩意搞自动化测试之类的,token得亏得一批
你不是说 codex?cc 是 Claude Code
computer use 就是会非常耗费 token,尽可能用最便宜的模型,我一般都不让 codex 控制电脑
那么怎么才能让缓存命中率高一点呢
不管是不是代码,都要塞到上下文里。你的缓存都没创建好,当然贵了。便宜的是已有缓存的输入
好吧 确实,就是不知道让他分析项目,然后写代码的消耗咋样了
关于坑不坑,是相对而言的,同样的任务你可以交给gpt/claude/glm来做,看看消耗的token/额度,再比较是否坑。
换一个工具试试,缓存这么低不正常,你这使用浏览器工具也很耗费token
我用computer use特么刚烧了6块钱,感觉用插件非常烧token,平时传很多文档,对话用一千万token只要一毛多,缓存命中率也有八九十吧
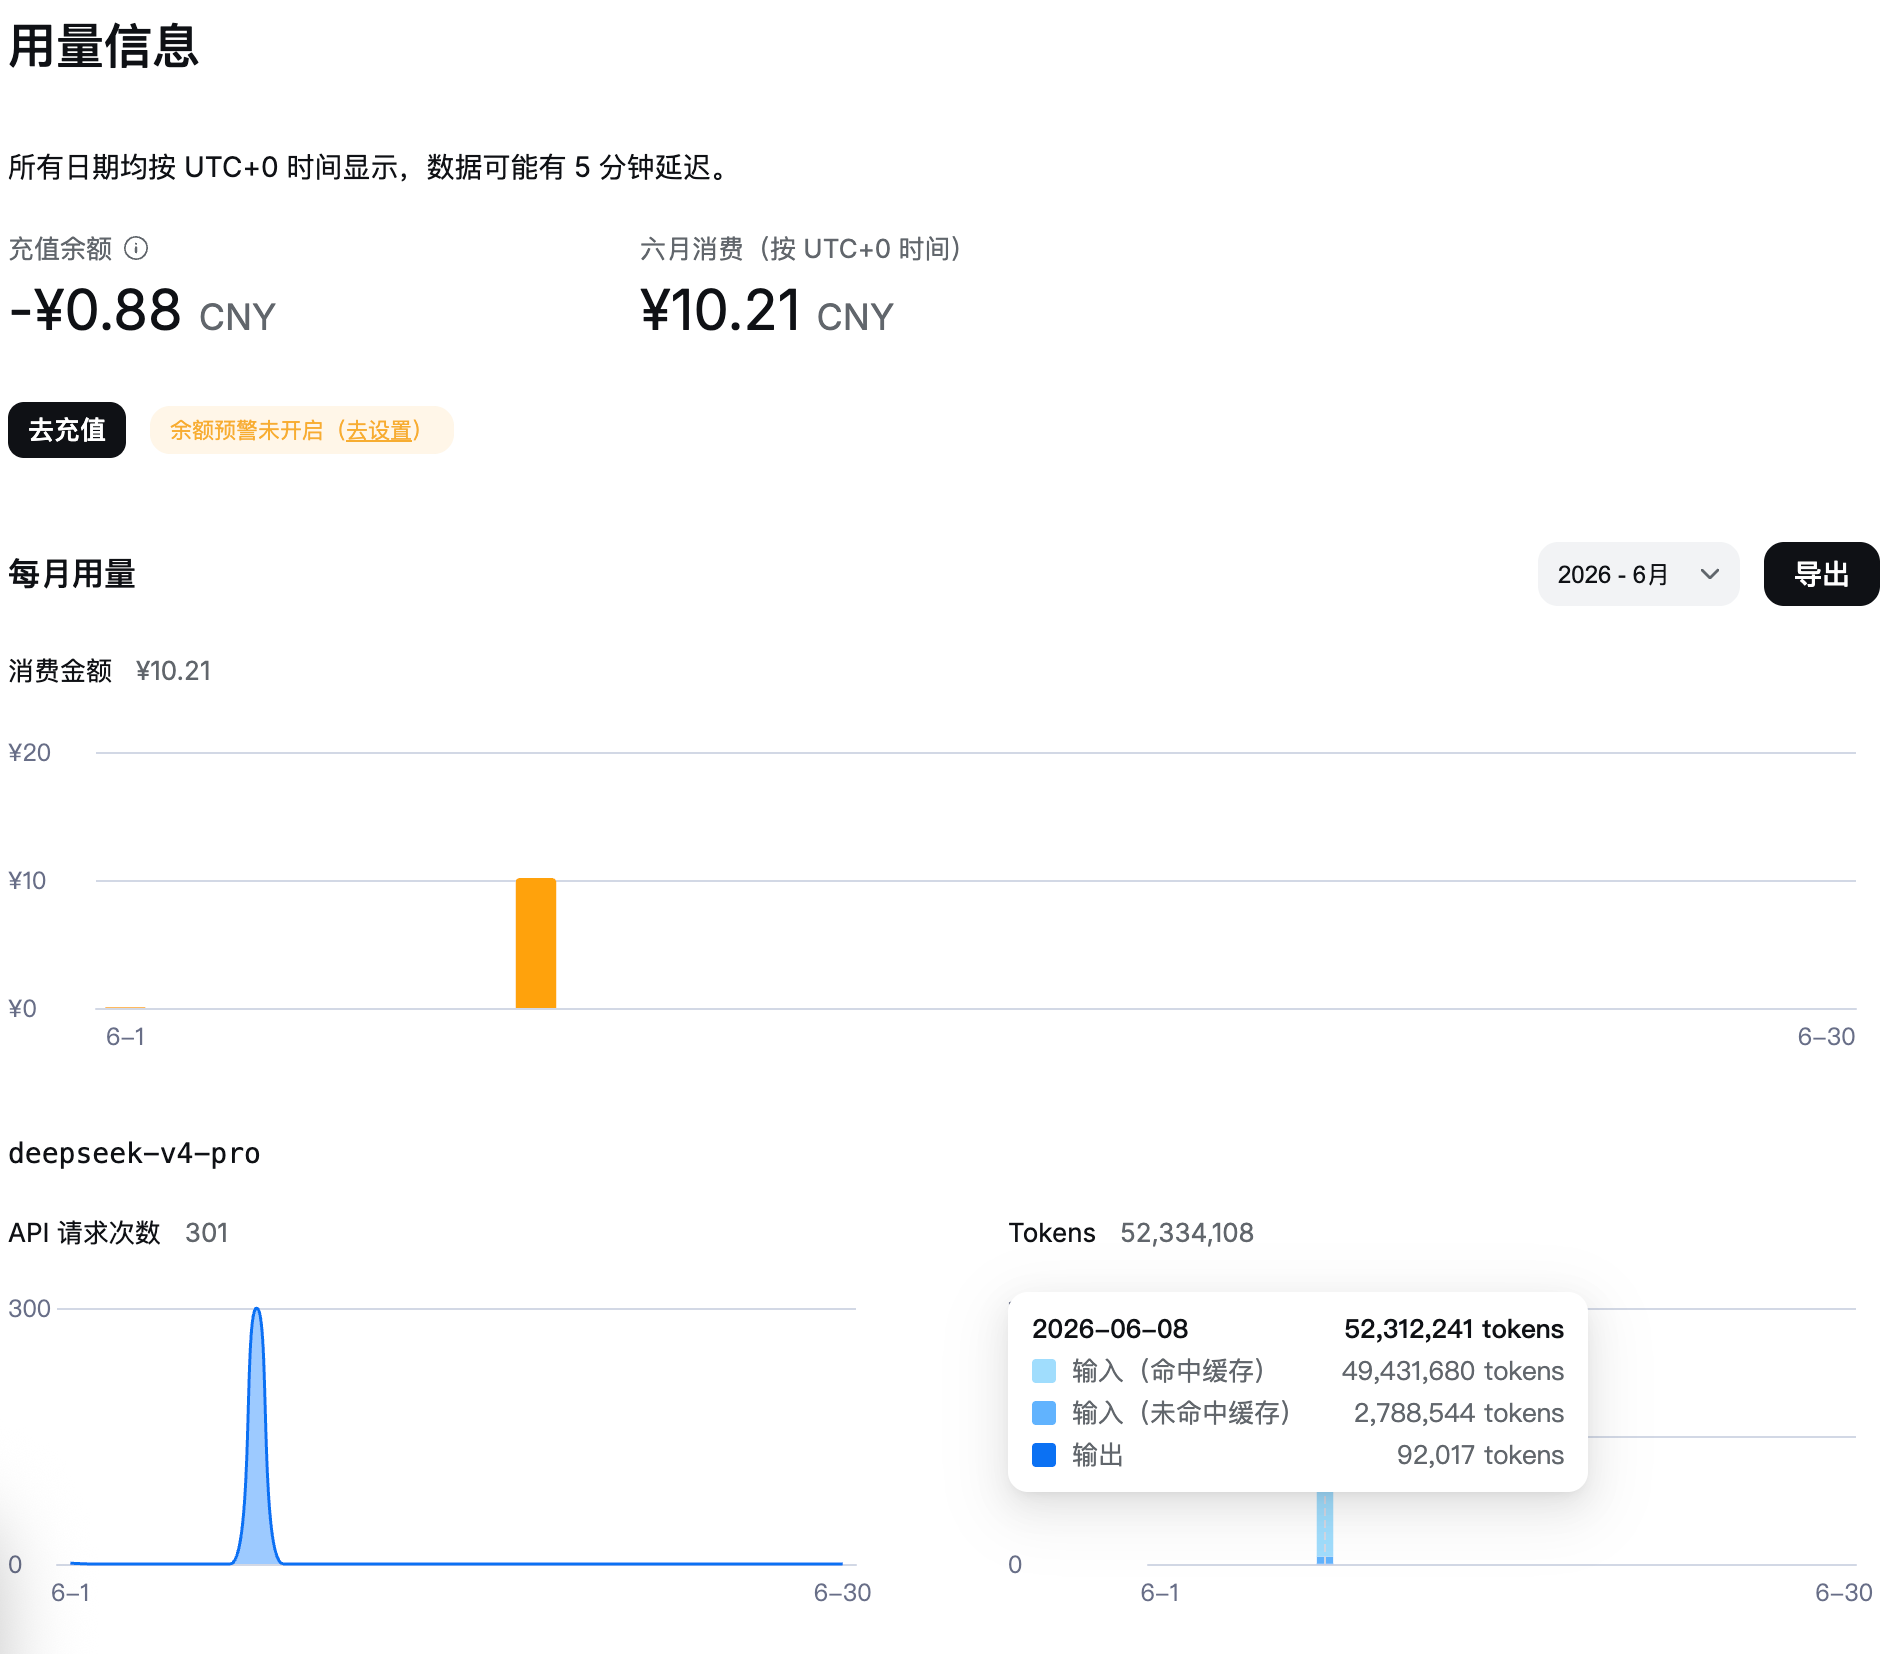
肯定是codex,emmm。标题不也写了吗hh,就是想测一测这模型咋样
你说的额gui是指哪个?我只是想用codex这个agent来做事
佬友说的cc一般是指claudecode 而不是codex
然后deepseek 要么用deepseekgui 要么接入claudecode 不适合codex
你这里又说是cc
一个自动化的视觉任务消耗100多万TOKEN吗,这算正常的吧
目前用agent工具很轻松就能达到几千万,甚至上亿的TOKEN
我用codex也是这样的,平均每天消耗4000万token的gpt5.5,只不过改点小项目给自己用,以及完成一点日常的Agent自动化操作,甚至还不是为了工作
agent工具需要多轮任务执行,每一轮的任务都是把前面的内容全部新发给模型的,所以输入token会非常的大