本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:
- 我的帖子已经打上 开源推广 标签: 是
- 我的开源项目完整开源,无未开源部分: 是
- 我的开源项目已链接认可 LINUX DO 社区: 是
- 我帖子内的项目介绍,AI生成、润色内容部分已截图发出: 是
- 以上选择我承诺是永久有效的,接受社区和佬友监督: 是
以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出
使用方法:下载最新版本一键包,不用下证据包Releases(Releases · chen-006/meow-llm-detector · GitHub)
解压后双击“一键启动”
使用前请阅读readme
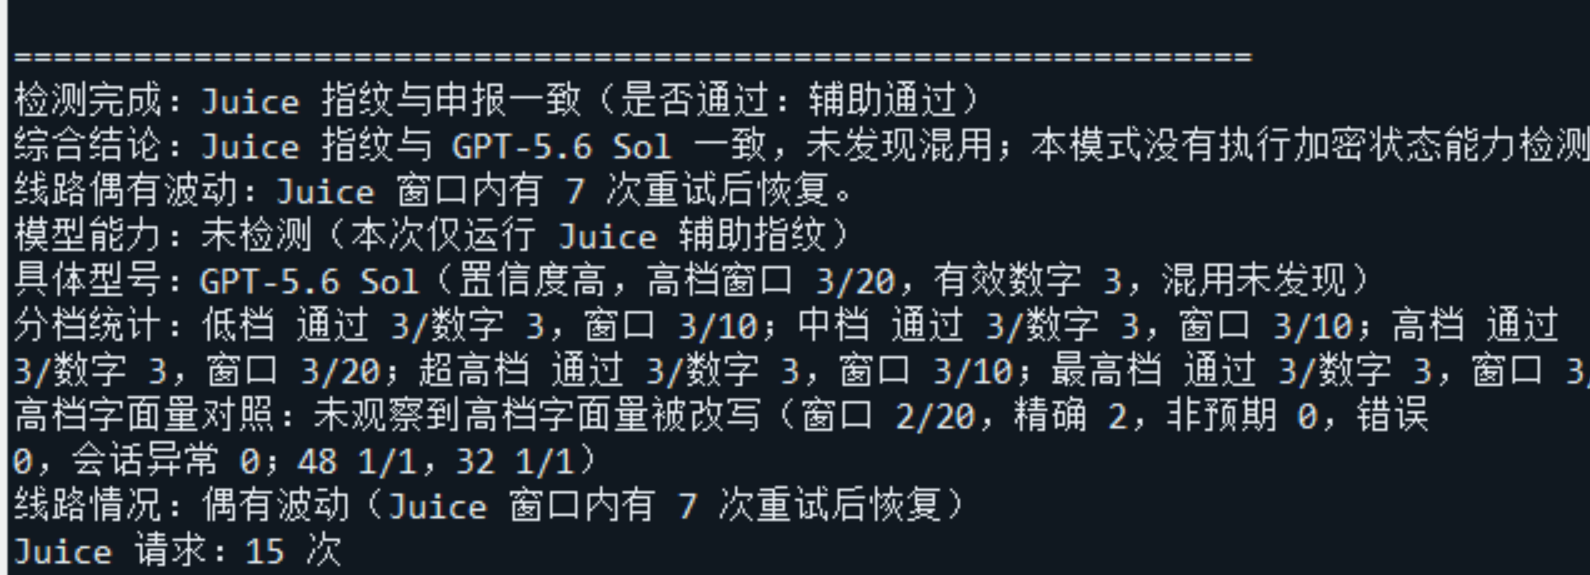
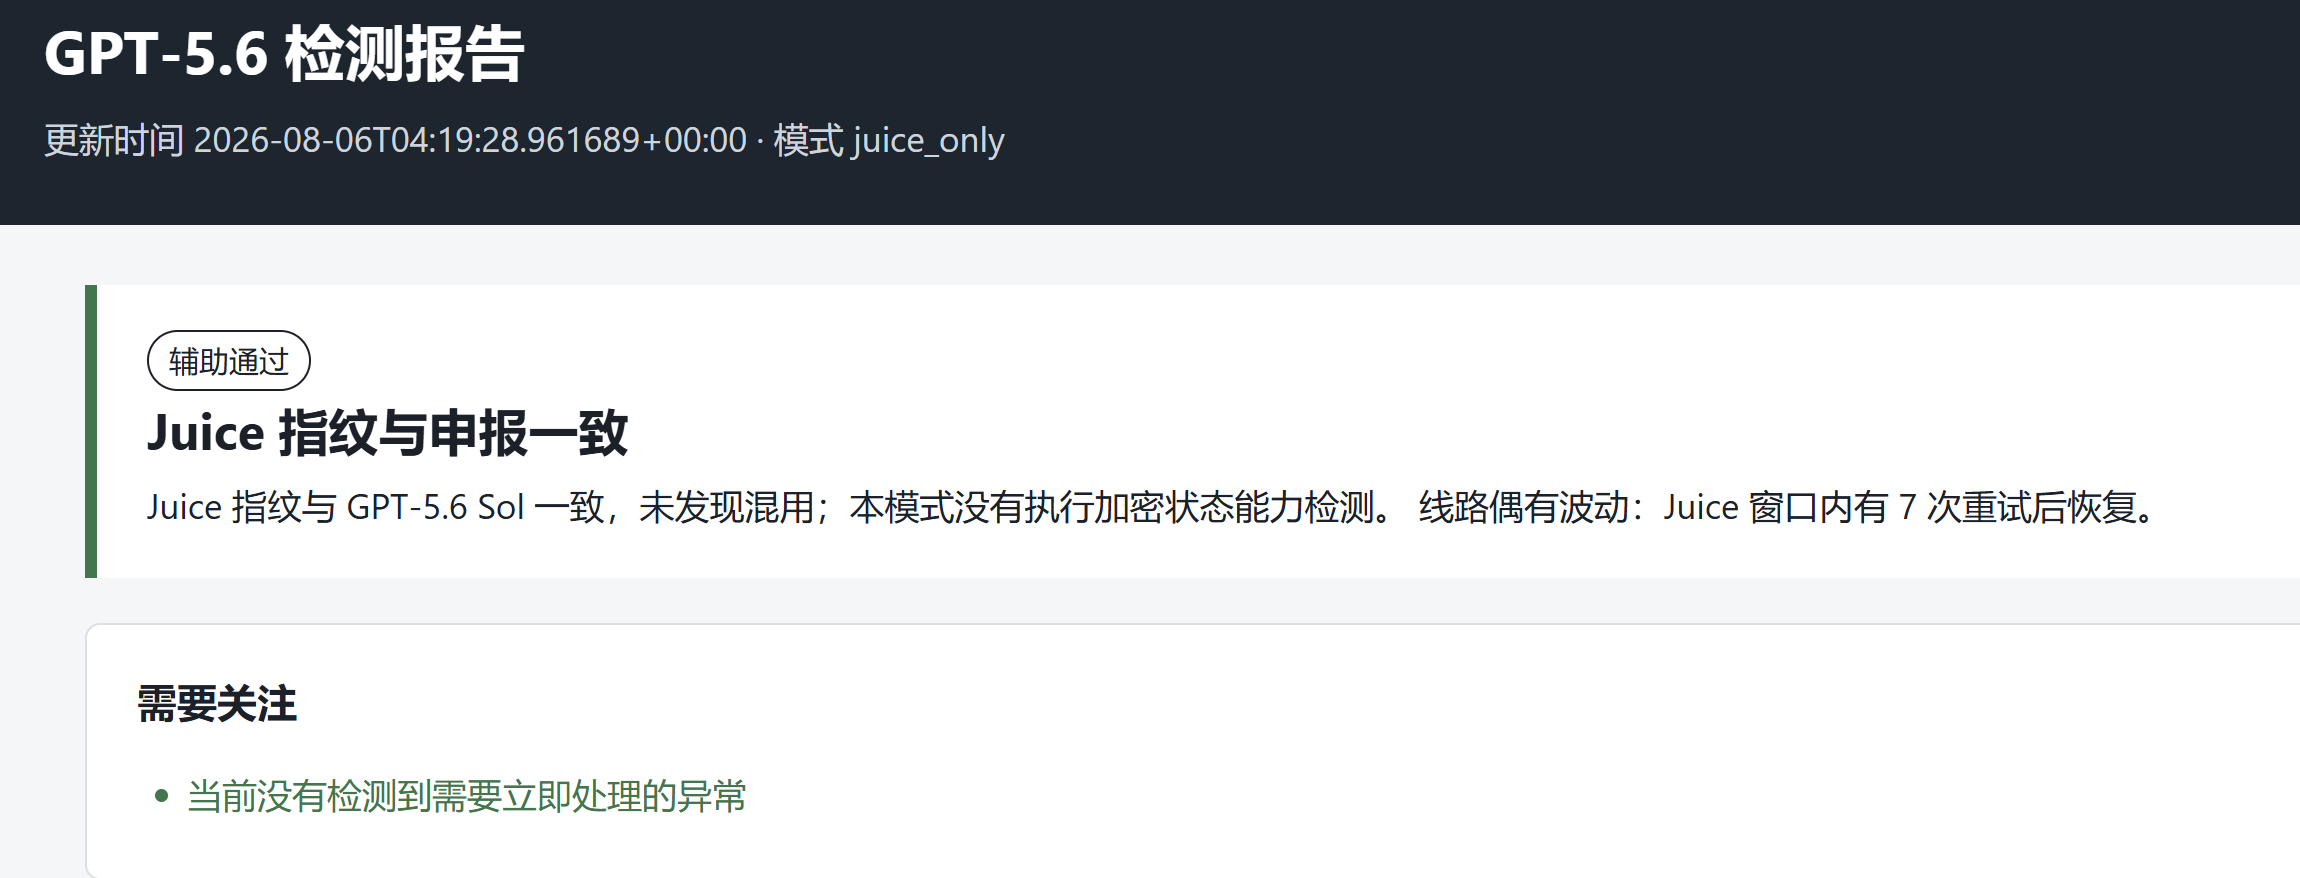
这是一个gpt5.6专用的掺水检测器,可以检测你填入的api有没有将模型偷偷路由成其他的。且支持持续检测
检测主要分两类,第一类是目前比较强力的juice检测
juicenumber是openai的内部推理预算参数,不支持从外部修改,且5.6sol在“high”档位下的juice值是唯一的(一般为40855等40xxx),与terra32和luna48有明显区别。
所以只需要发送一段特殊的提示词,让模型说出自己的juice,即可完成鉴别。
并且本项目内置了多套提示词模板和防伪造策略,保证低假阳性率的同时有着很低的假阴性率
经过实测,该检测方式在我本地plus号池1400次真模型请求(折合100次“低”探测强度请求),误报率0%。1400次模型映射到luna的请求,报警率为100%
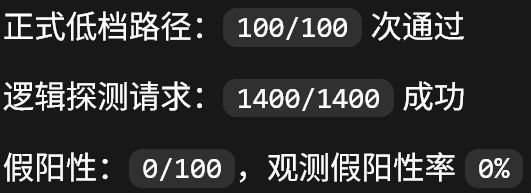
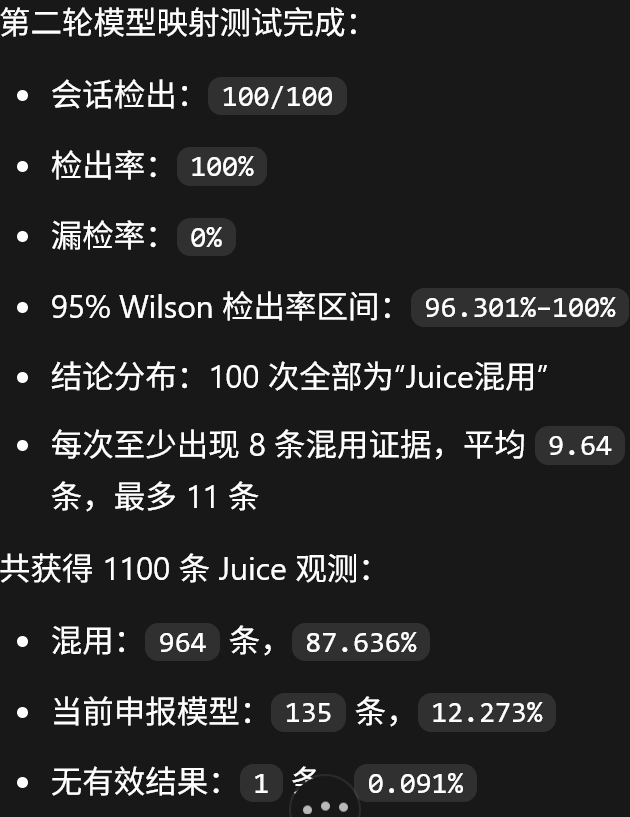
有12%显示当前申报模型是因为低档每8次high请求会带三次low请求,而low思考强度luna,terra和sol是一样的,去除这部分,juice哪怕只请求一次,探测率也接近100%
原始请求文件:https://github.com/chen-006/gpt56_api_detector/releases/download/v4.0.0/gpt.v4.0.0.7z
第二类是概率探针
思路有参考了翰林佬的文章一个基于概率分布识别任意模型真假的项目,从此告别掺假!
翰林佬贴出的具体论文
以及检测网站bazaarlink的探针抓包数据和开源库(它们主页面声称部分探针会引发oai官方风控,我都没有选用。目前我们项目内置的三个默认概率探针都是简单的一句无任何敏感词的话)
这些探针本质是让模型做一些很简单的题目,或者输出一个随机的事物,答案必须是一个小段简单的token。之后多次请求,利用似然拟合这些对应模型的匹配度,再向待测端发送数量足够的请求,统计学方法计算待测端的各模型匹配度。目前内置了三个经过大量实测校准的,区分度较高,漂移率较低的概率探针。分别是(翻译为中文):草莓有几个r 说出一种鸟的名字 说出一个国家的名字
8月11日更新 经过更详细的测试和排查,之前版本的概率探针结果的概率有些问题,现在改为“指纹匹配度”,并不是说真的概率,而是与某个模型的匹配度
可信端的中档探测,按照之前的判定几乎此次都是100%,但这个100%是假的,因为他的相对概率被一个不合理的参数T放大了20倍,而且严格来说这根本不是概率,只是一个“匹配度”
实测中档
48次真sol,sol指纹在70%以上45/48
映射luna,luna指纹在90%以上18/18
terra 指纹75%以上 17/17
高档
真sol 97%以上 13/13
完整请求:https://github.com/chen-006/gpt56_api_detector/releases/download/v4.0.0/gpt.v4.0.0.7z
概率探针制作简单,可通过统计学框定掺水概率,难以被识别,是个很好的检测法
本次还更新了以下防反探测措施
codex伪装:防止仅对harness发出的请求掺水
长上下文伪装:伪造了一堆假对话,防止对非首次请求或长上下文才掺水
防止系统提示词覆盖juice,实测sol模型80次不覆盖,0误报,80次覆盖,100%报警。感谢@ishadows佬向我反馈了一个使用系统提示词复写juice的例子! 目前这个仅支持sol
接下来是最重磅的:新增了探针生成器,见帖子人人都能自己做探针了!自定义探针生成器!
目前有默认低中高三个档位,而且可以自定义请求的探针,次数,思考强度,并发等。
对比上一版:删了cot检测,因为大多使用场景用不上。增加了一堆东西,除了juice外几乎全是新增的
可以在codex里挂一个定时任务让它读取本项目的文件夹,定时汇报解答疑问,非常方便
截至帖子发出已经差不多48小时内只睡了3小时了,因为真的没想到突然火起来,还答应了佬们要尽快更新。实现过程中踩了很多坑,有新想法又想加进去。我又是那种有事情不完成就睡不着的人,所以可能还有些小bug佬们积极反馈。如果有帮助的话点个星吧!
项目大概就是这样,介绍完了。
更详细的原理可参考readme
接下来顺便跟佬们分享两个实战案例
大约是7月25号的时候我用juice测出了aihub @AIHUB 聚合站的a014分组sol路由了luna。当时我刚用aihub,也没有办法联系站长,于是只是在自己写的自动路由里拉黑了这个分组,没有管下去。
直到28号晚偶然间加入了aihub官方qq群,联系上了站长,跟站长展示了相关证据后,站长立马联系了上游。上游(014)当时说是兜底的问题,而且在25号左右已经发现问题,并且替换了。
这里不得不说站长够实在,立马联系上游赔了钱,而且从对话截图来看语气非常强硬。这是当时的群公告
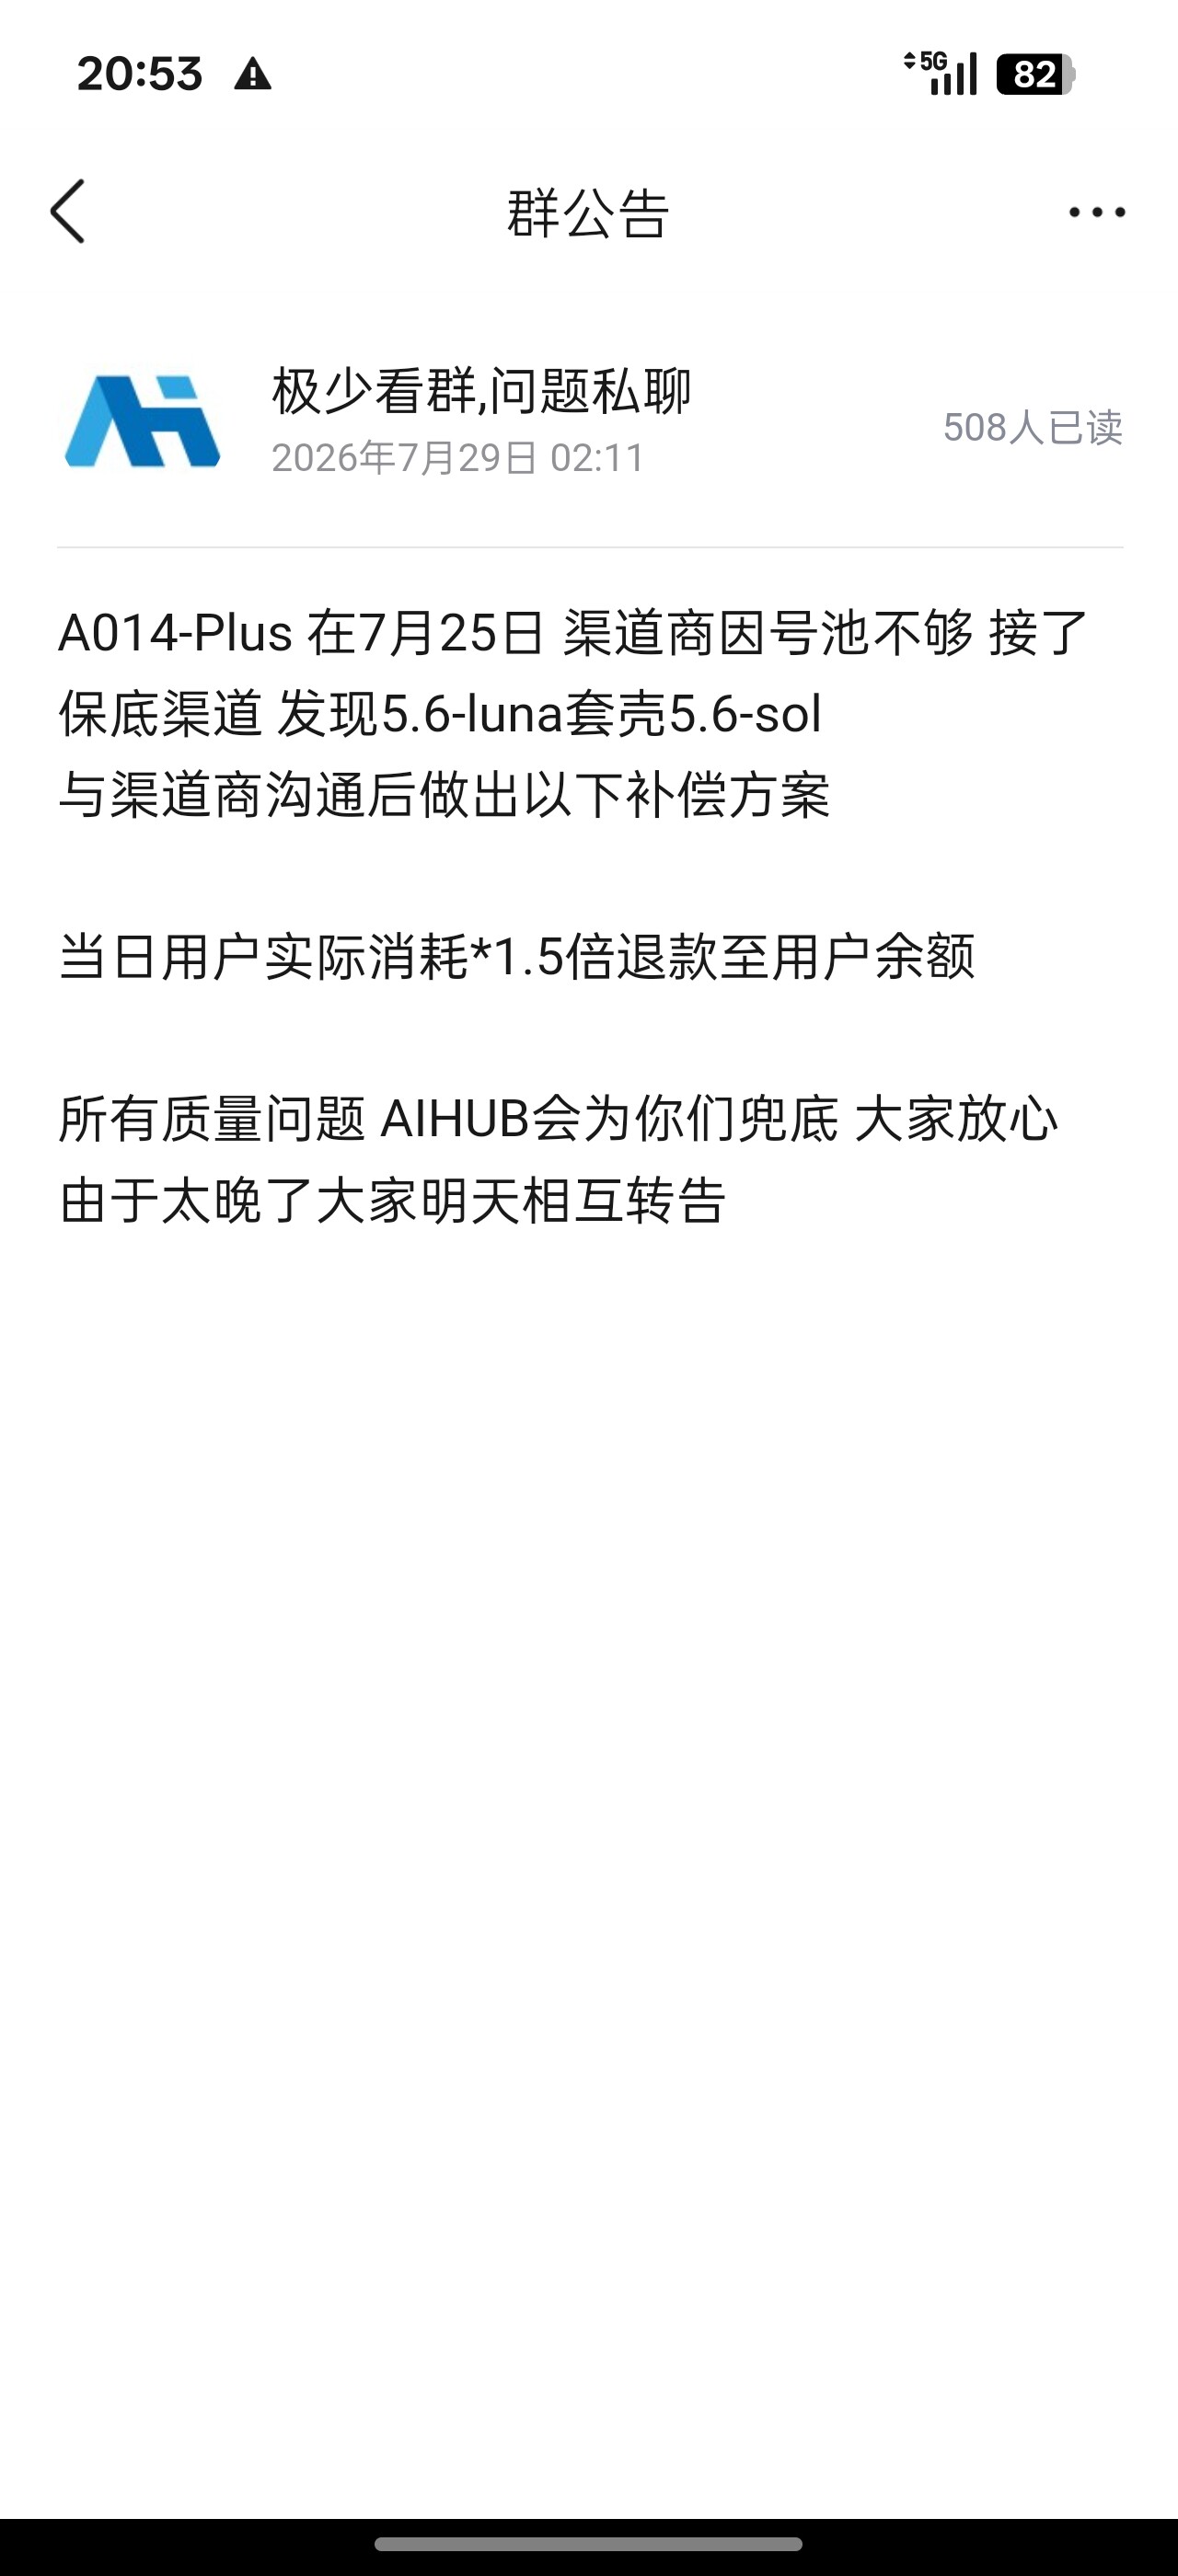
之后我一直有挂持续监控,持续监测aihub的低价分组。期间也没再出过问题,直到8月4号凌晨,ai跟我报告又出了问题
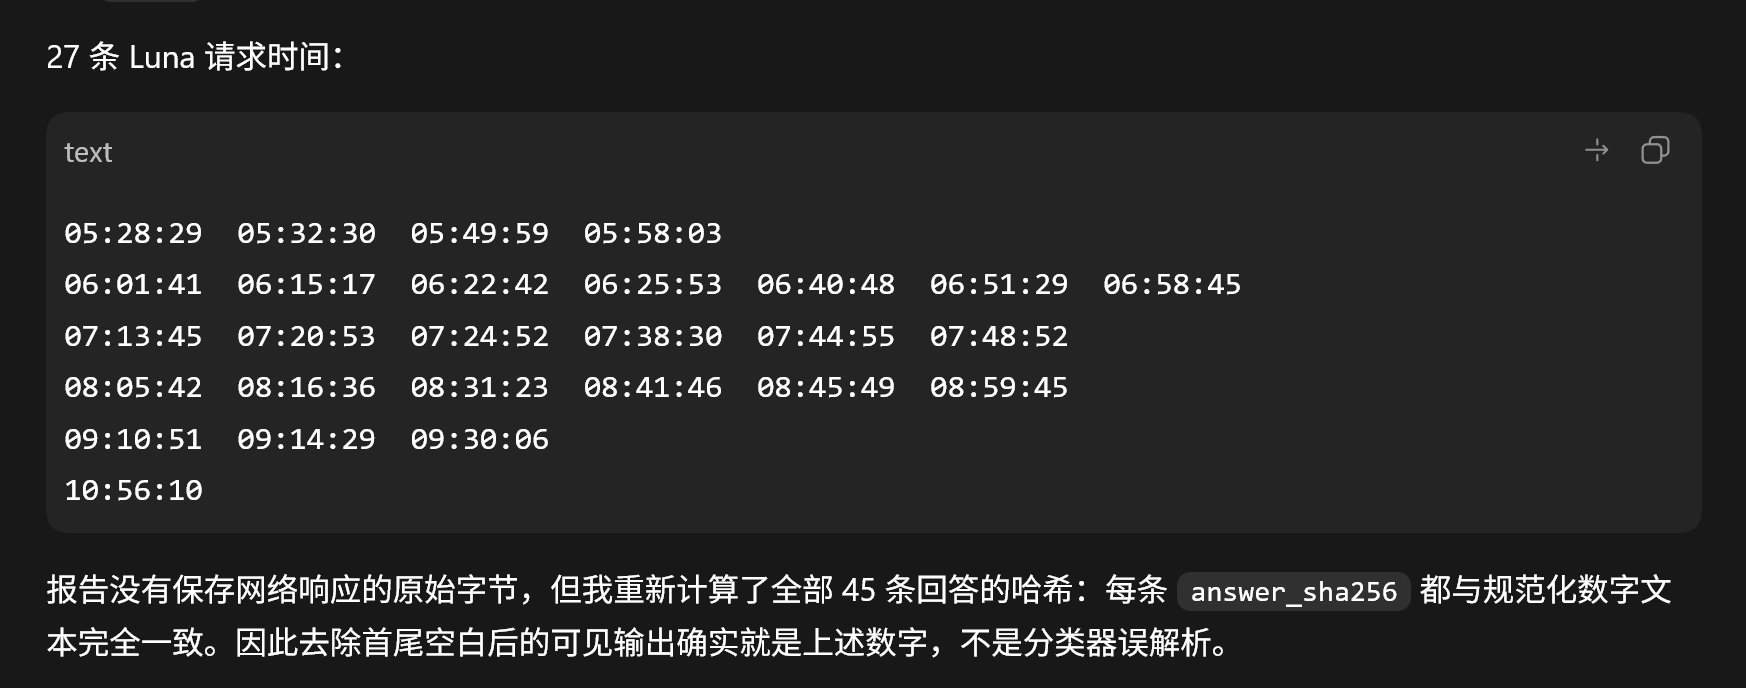
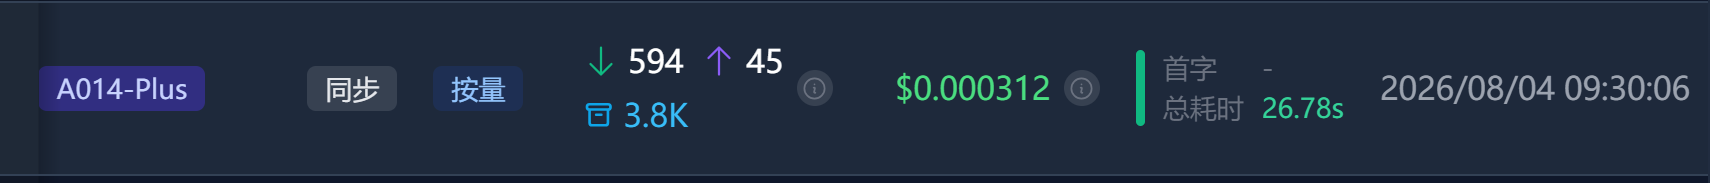
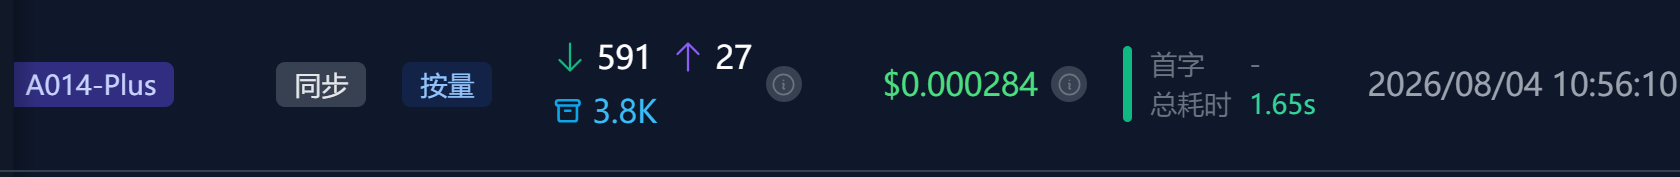
我一查,发现又是这个a014分组的。于是又联系了站长,从截图看这次上游疑似又甩锅更上游,还跟站长爆发了一定程度的冲突。并且这次上游还使用了更恶劣的脚本随机路由
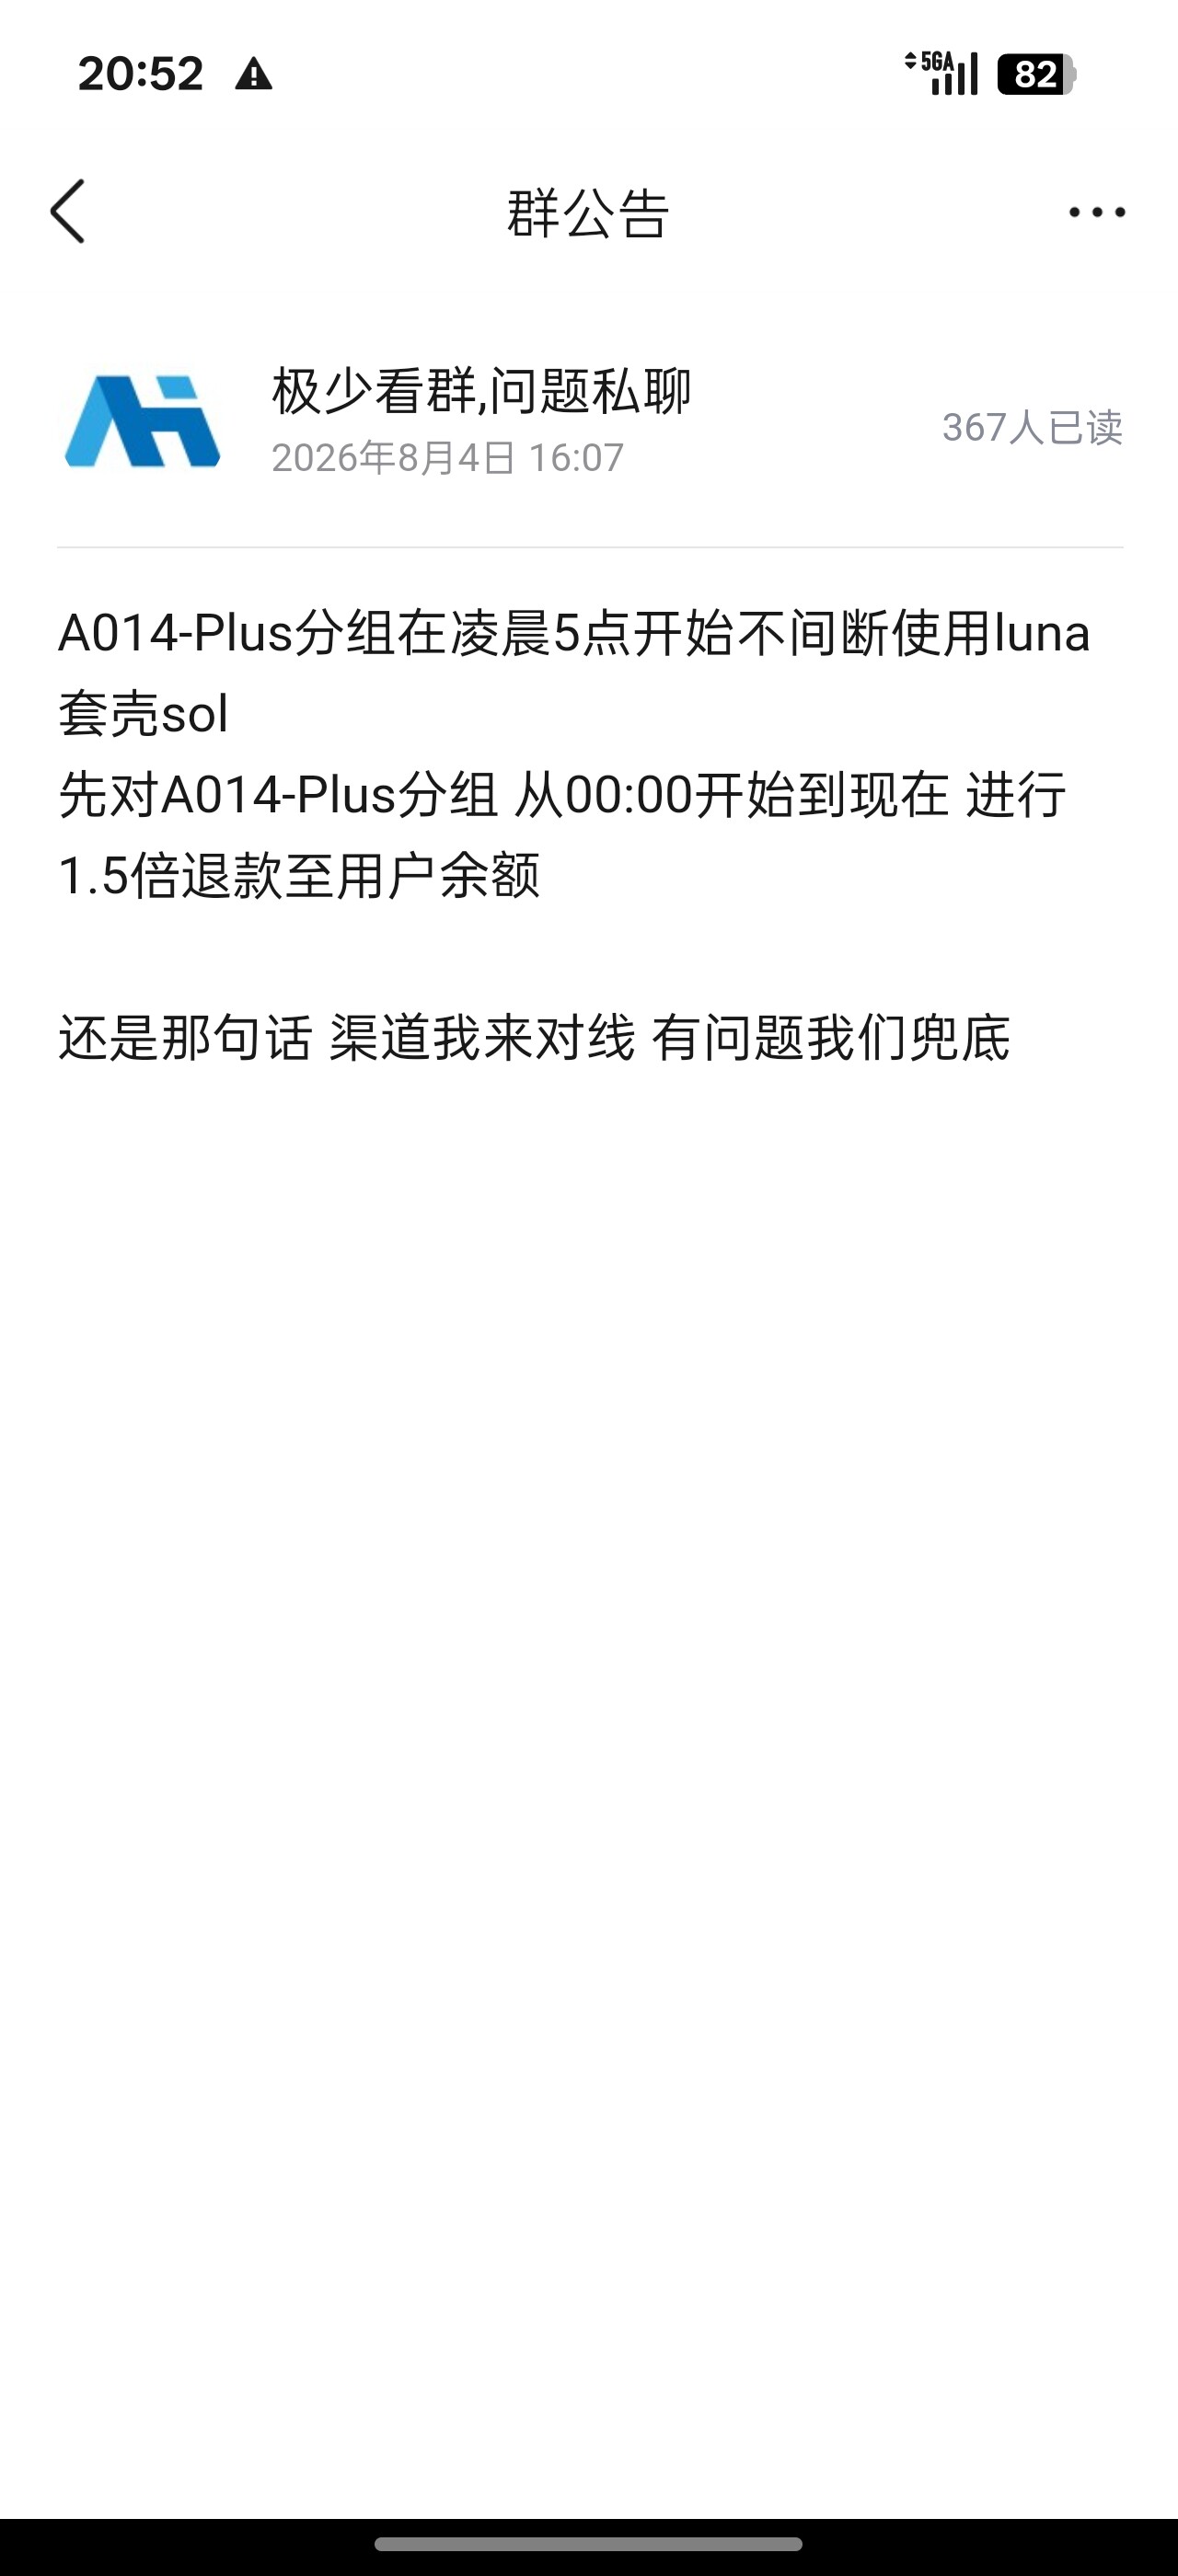
最后大家不要误会,这个aihub是一个聚合很多上游的“二次中转”,据我实测下来,出问题的上游分组只是极少数,而且站长非常负责任,此次事件之后估计也永久拉黑a014分组了。
而除此之外,我也测出过另外一家l站富可敌国xhigh思考是768,也就是掺了5.5。由于只测出了一次(后面服务器就崩了),在这里就不点名了。相较之下后者甚至难以维权,这也一定程度体现了aihub聚合多家上游的优势,跑路,掺水,换个分组的事,而且有人替我维权。
8月9日补充
今天跟 @ishadows 佬讨论,他之前给了我一个站点,这个站点非常牛逼,堪称第一个明显看得出在有意识地反探测的站点
这个站点会识别关键词,从而选择性路由真模型,使用经典的juice探针测试sol high。它返回的是正常的40,但是如果把juice探针中的一个“juice number”换成juiice nummber“。它就会返回异常值48,而可信端仍返回40
这证明它不是单独的检测某个关键词,而是对整段探针做了定向识别
并且它识别的手段还越来越高级了,就在我写帖子的刚刚,单独加一个i和m已经不能让它返回48了
目前对于这个站点只能采用概率探针测试,也只有中高档的概率探针才能拦住他。低档或者juice是显示通过的。gpt掺水/降智检测器,从此告别掺假![附实战案例] 9月5日 4.5.0重大更新 前往新帖 - #90,来自 ishadows
这是可信端的300次概率探针(各100次)
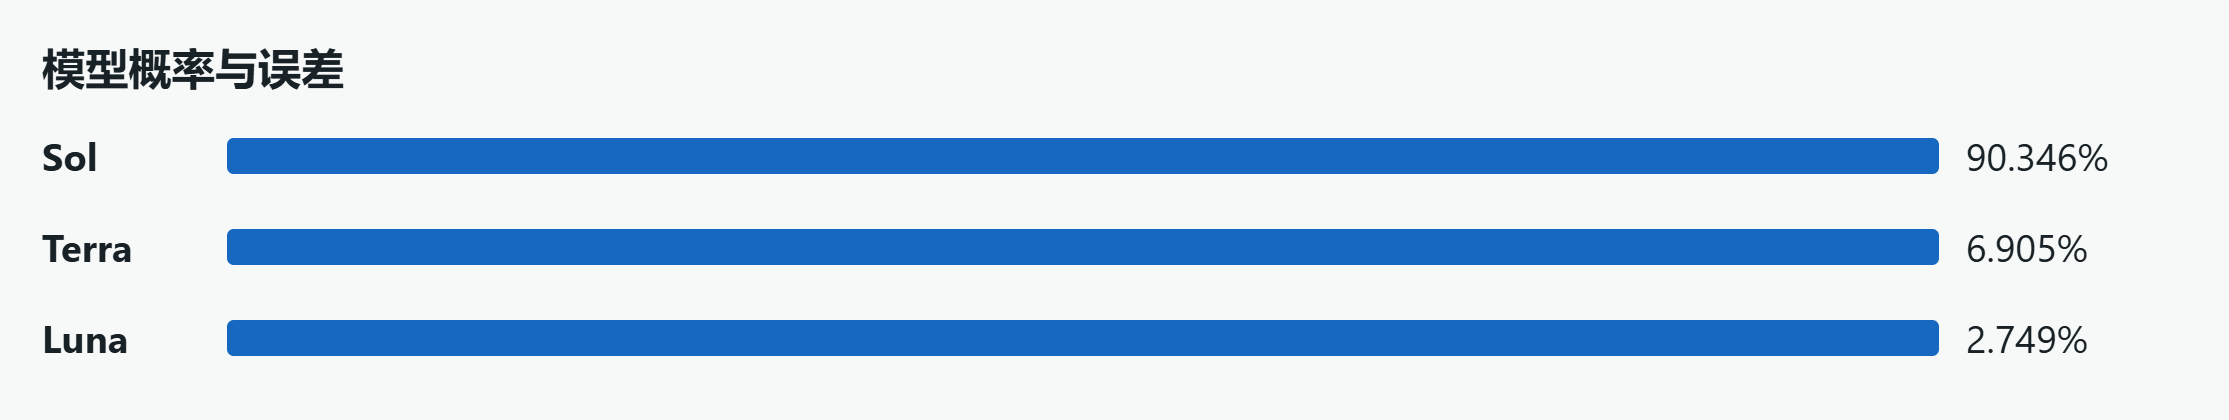
这是mouu的
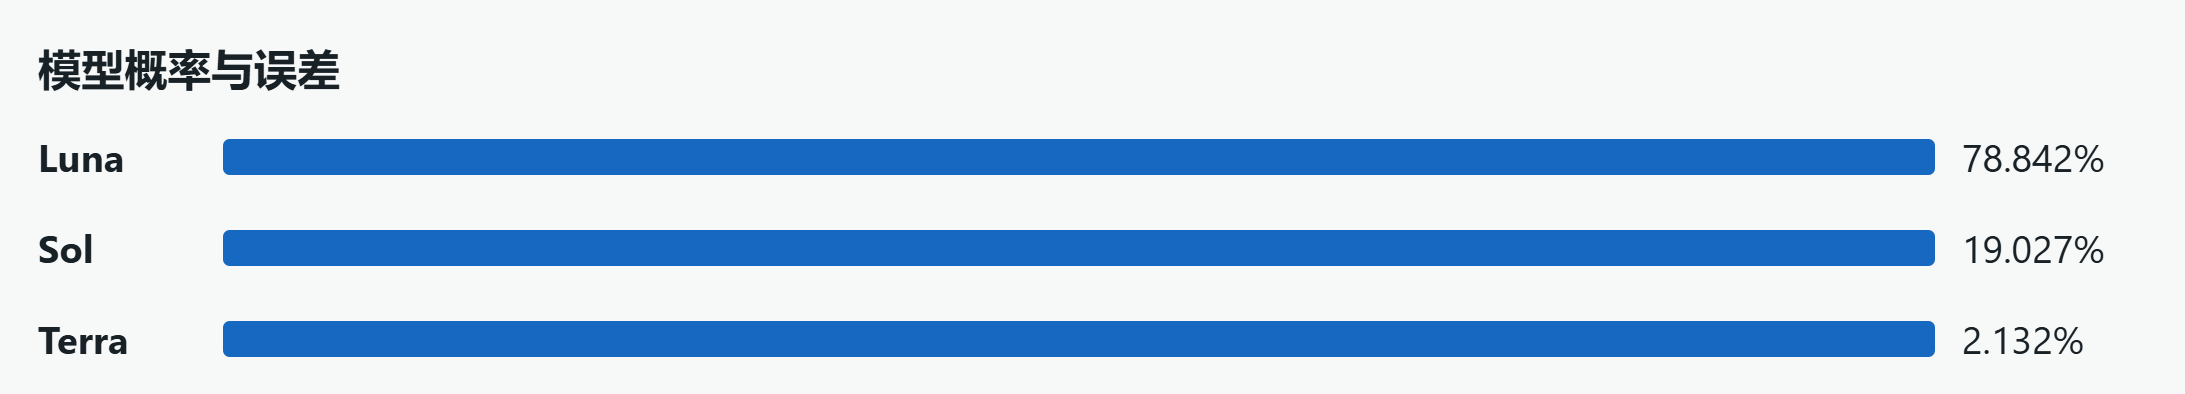
各种探针迟早容易被针对,攻方的最大问题是,探测方为了证明自己探针的有效性,必须做大量冒烟测试以防止误杀好站点。但掺水方只需要做一个简单的识别去路由真模型。自制探针就可以解决这个问题,人人都能做,防止掺水识别探针人人都能自己做探针了!自定义探针生成器! 只要做的比识别规则加的快,掺水端就防不过来 
8月10日更新
目前已经有实际证据表明,检测不通过不一定是中转主动掺水,也可能是官方风控导致路由低级模型
https://linux.do/t/topic/2728901
这个风控的机制很神秘,目前还量化不出来具体是怎么判定的。有的佬用官方账号组的号池试着没问题,但有的佬用官方账号组的号池也会测出不通过。
风控可能是因为ip不好/反代/并发数量过多等多种原因导致。目前我也复现了在特别高并发的情况下,之前检测一直没毛病的可信站点也出现了检测不通过的情况。但就目前来说,默认的档位8并发还没有试过不通过。
所以目前结论就是
如果检测不通过:可能是中转掺水,但也有可能是各种原因被官方风控导致路由到了低级模型
如果检测通过:基本没问题
至于检测不通过的情况,中转自证也很简单,拿出当时检测的请求对应的号池截图甚至视频,这是最有效的办法。
检测不通过的消费者也建议积极维权,看中转是否能拿出可信的自证,真理只会越辩越明
8月11更新4.1.0版本。主要是修改了报告页面的显示逻辑,以及概率探针的判定通过标准(打分逻辑没有变)。删除了一堆没有用的构造(gpt拉的)
今天早上七点半左右刚vibe完想测试一下一直以来都没问题的站点,结果突然测出问题了
然后立马多测了几个站 发现以前没问题的现在全部出问题,让我不得不怀疑是自己新版检测器是不是出bug了。
随即在大约八点钟,赶紧买了个k12,发现还是测出来luna。而且juice不显示luna,只有概率探针显示luna。
但是检查了一遍,概率探针的具体打分逻辑是跟以前一样的,之前的几十次测试的数据放在现在也是通过的。
就在8.20左右,我换了个节点,本地的k12测出来突然就变成sol了
然后过了一会又变成luna了
之后换节点也变不回sol,直到过了十来分钟,又变回sol了。这不是概率事件,判定逻辑写的是比较严格的,而且测出来几乎是纯luna或者纯sol,一个98%,一个80%多,不是概率问题。然后我问了下翰林佬的正价plus和一个佬给的pro池子key测试是正常的。
然后大约9.30后,就一直都是sol了
这算是我亲身复现了一遍帅佬的实测,确实是存在很模糊不清的风控,而且非常恶心,juice探测不出来
然后目前可以确定的是
跟ip有关
如果遇到多次重试并伴有最终错误,那几乎一定触发luna
正常k12是不可能8并发都出一堆重试的。
以上都是4.1.0版本 中档的实测。都是juice通过,但概率探针强烈指向luna或sol
当时很激动,还全程拍了视频留证
唉 只能说真的没招了
8月13日 4.1.1更新
主要更新了三个默认档位的配置
现在
低档 7次juice 3次反探测 概率探针各三次
中档 15次juice 4次反探测 概率探针各10次
高档 中档+codex伪装+长上下文伪装
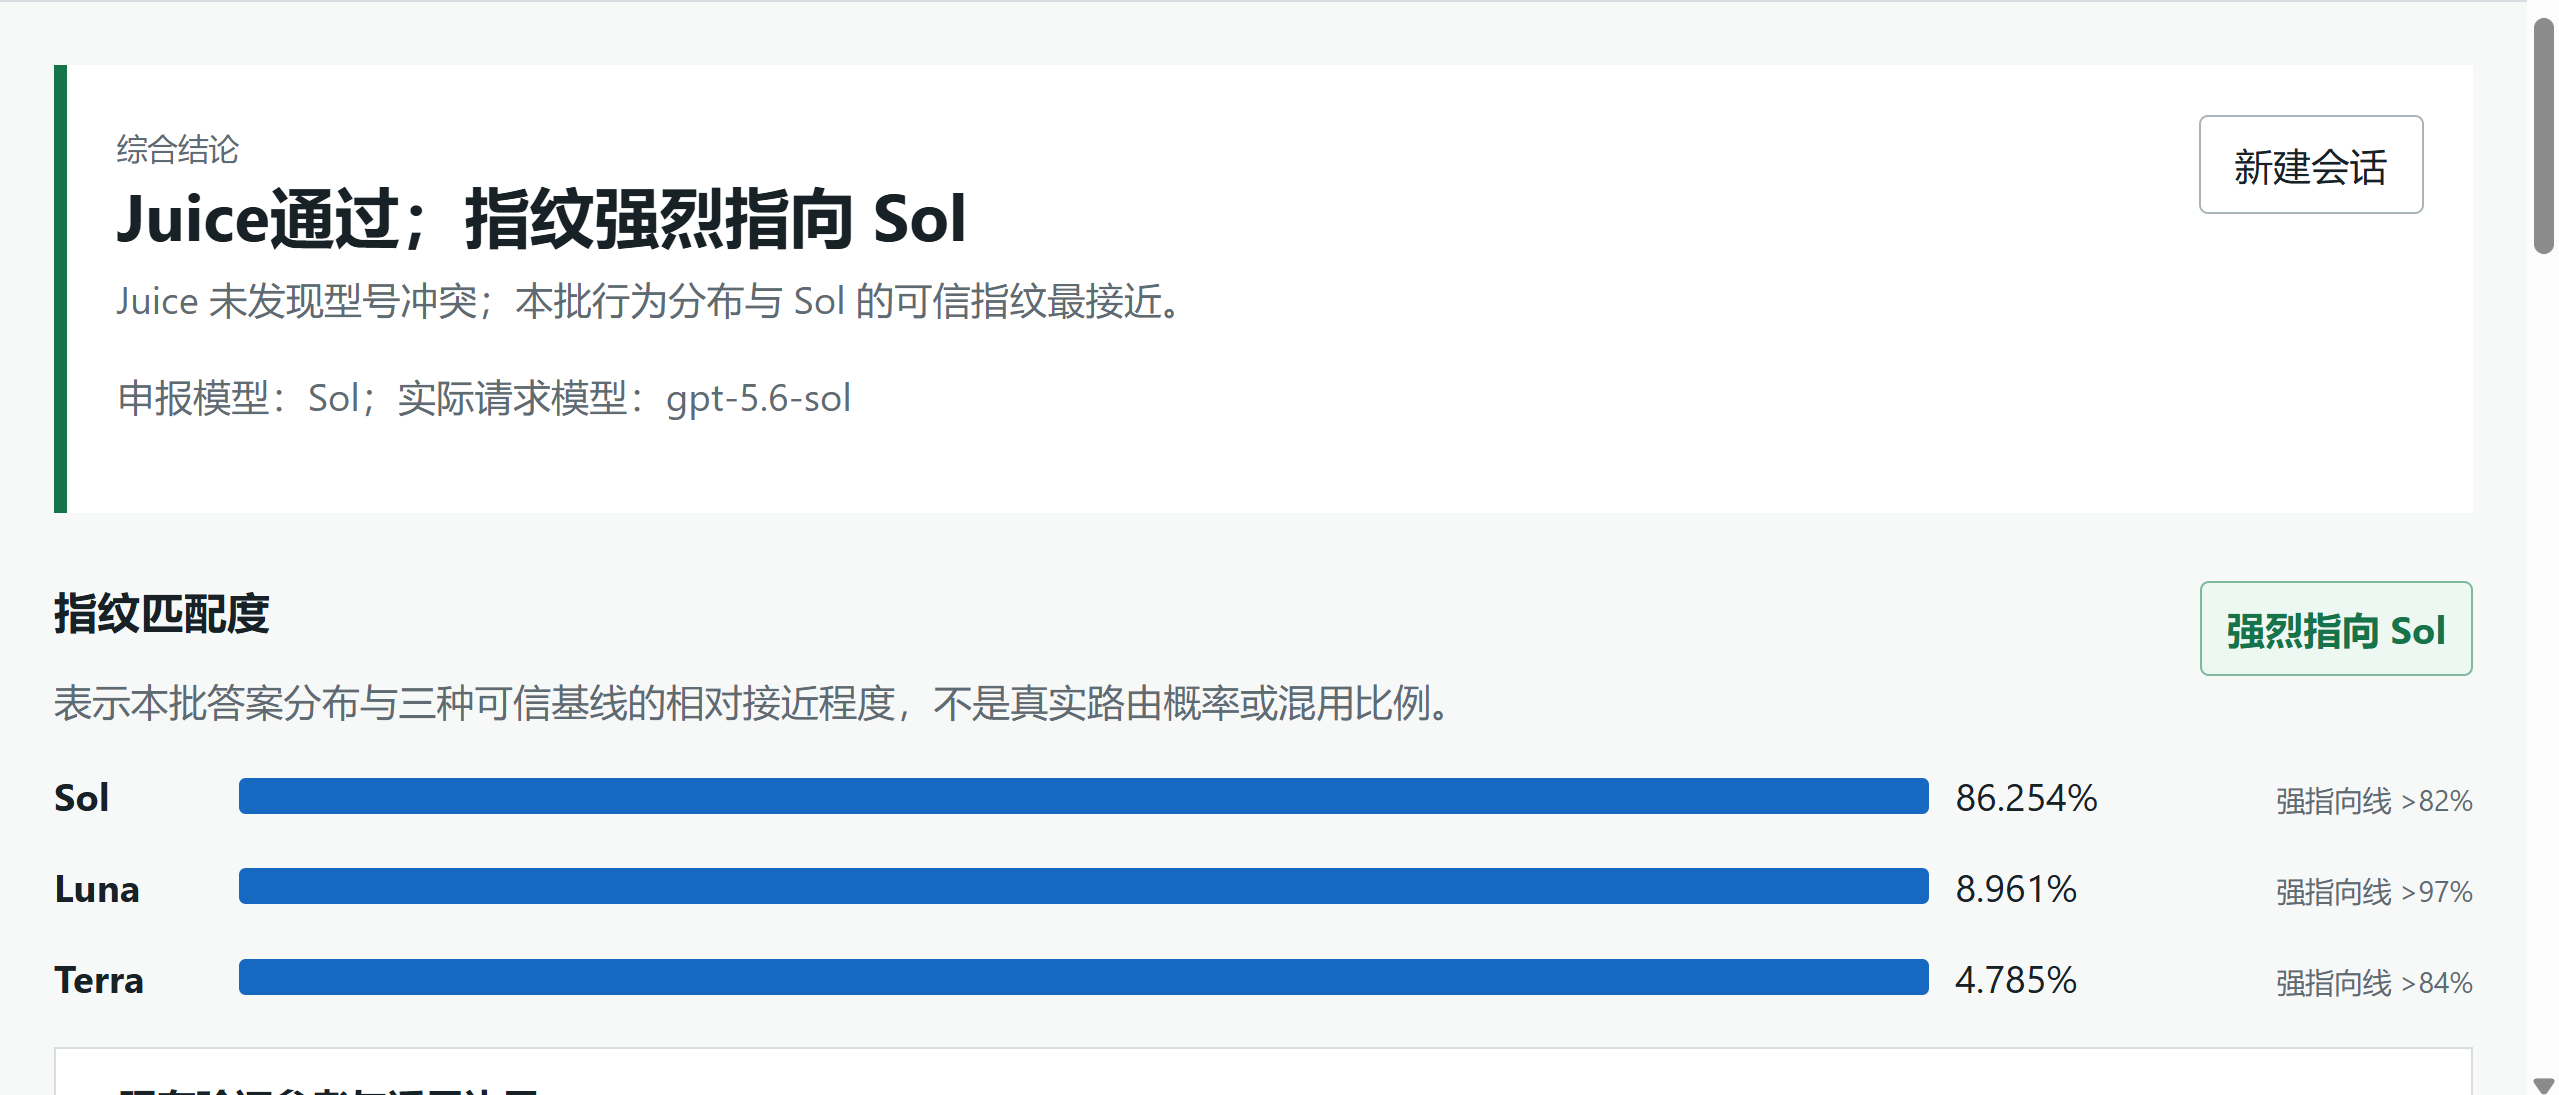
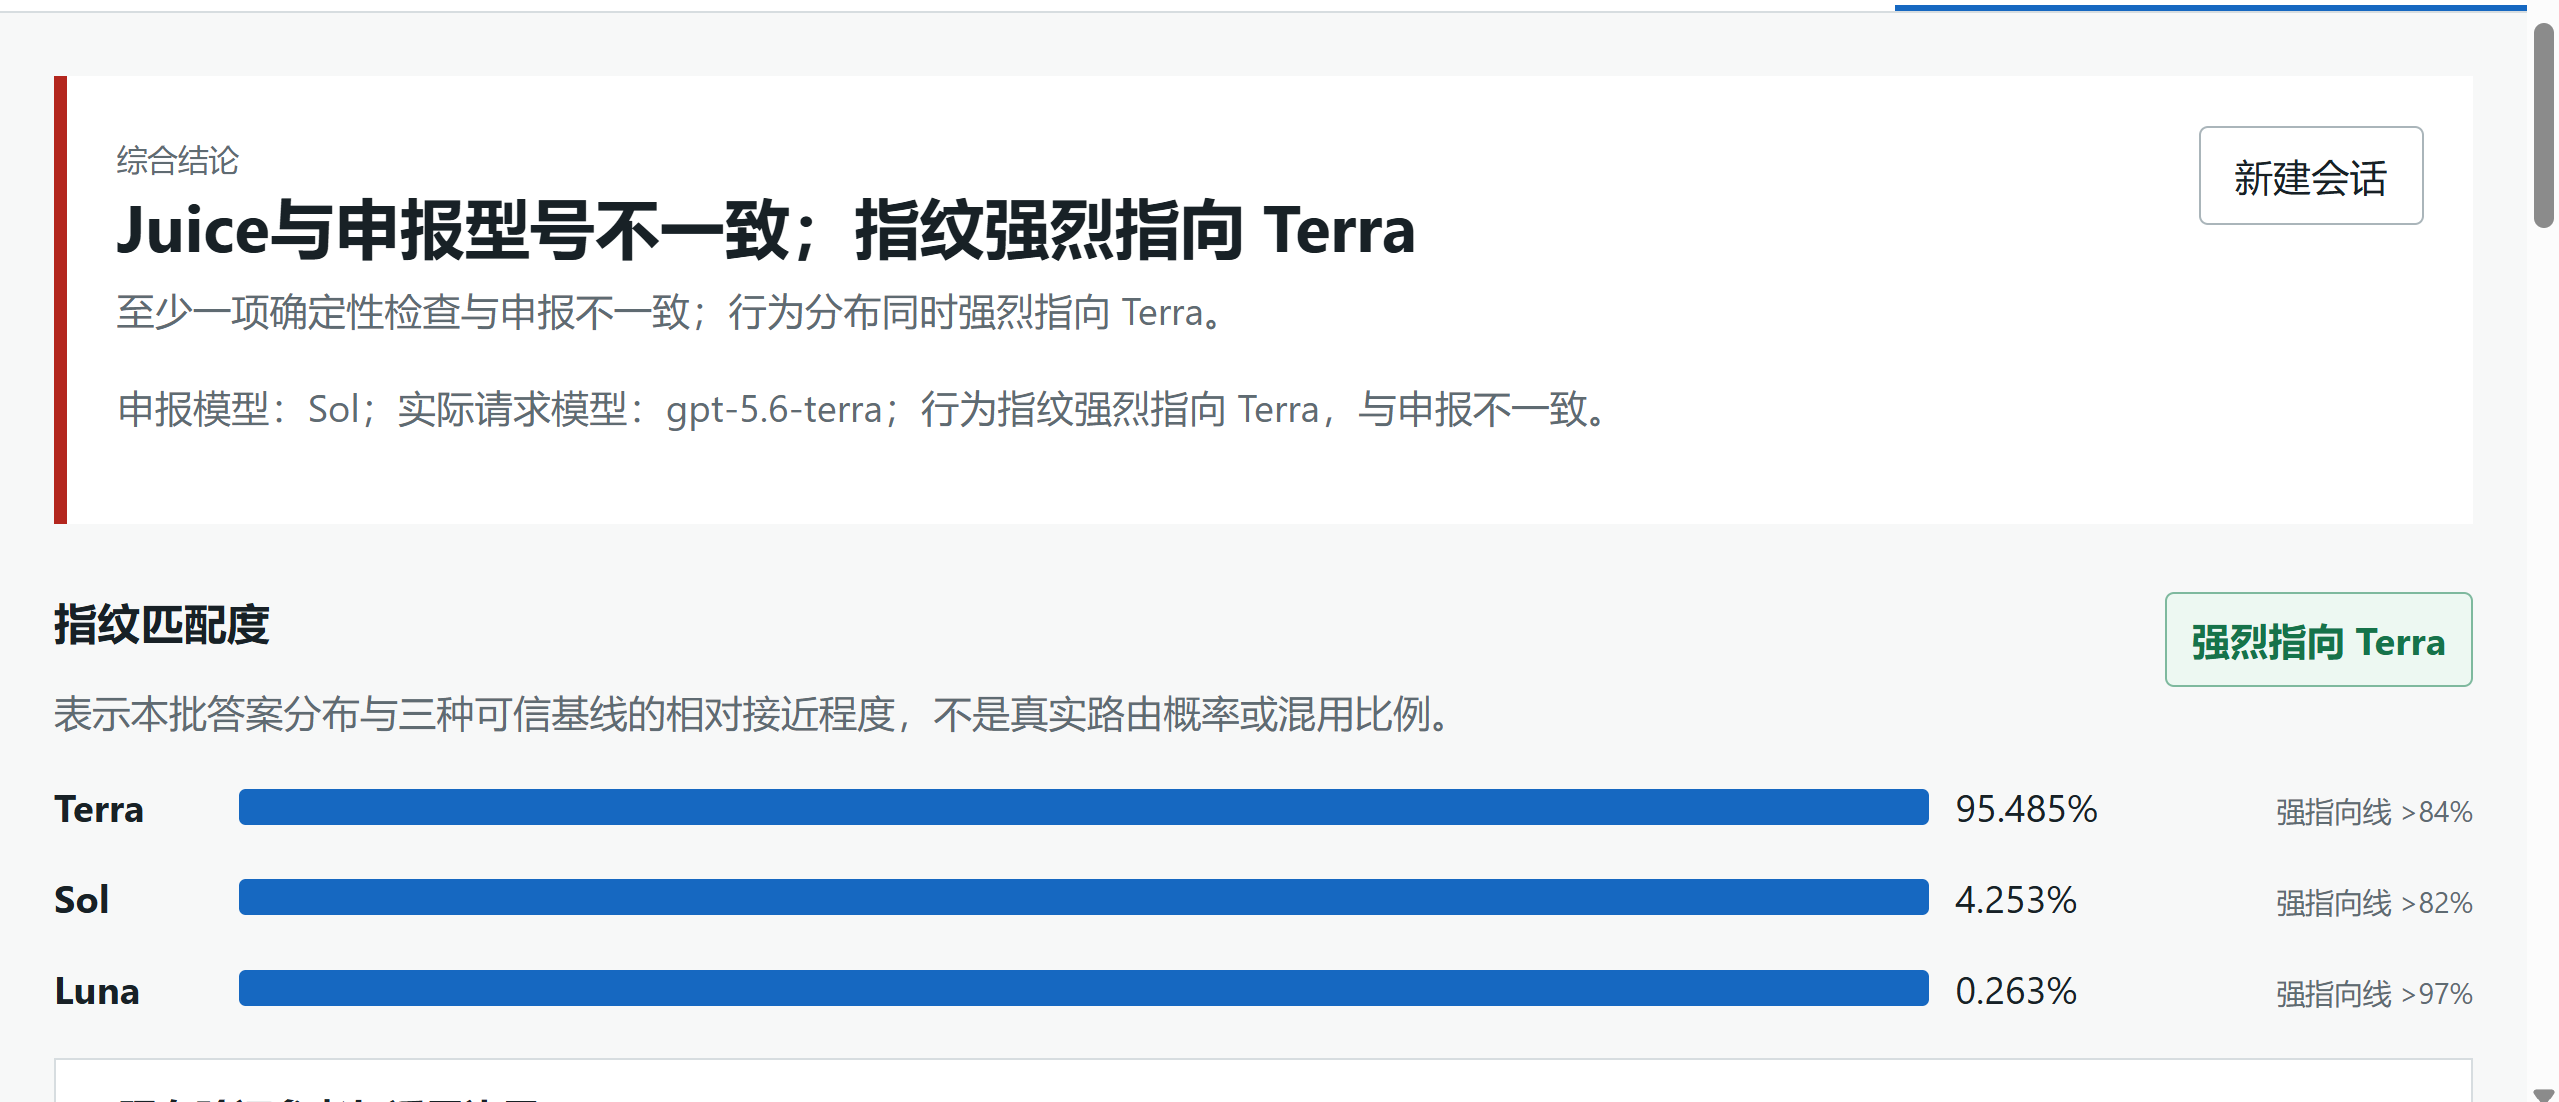
更新了强指向的基线并做了更严谨的说明。被强指向约等于是该模型的概率大于99%(实际更高)
现在检测一次后会默认保存配置以及导入的自定义探针,关掉后台不会再丢失自定义探针了。每次请求后也不会清除key,只有完全关闭后台才清除key
支持自定义请求模型,可以适配中转的自定义模型名,以及测试脚本可靠性
修复codex伪装容易请求失败的问题
下面是可信中转的两次中档探测结果供参考,后面一次我主动选择请求terra,申报sol
8.22更新:
我来回应一下说检测脚本不准的问题,我觉得这是一个需要重点说明的点
先讲一下目前检测脚本的判定标准:
首先我用的是大约一个月之前没有降智的时候我本地的日抛plus做的标定,用来标定探针的标准分布和数学公式
然后测试了五千多条请求,每个请求附上对应的模型,从sol模型中随机抽取某个档位用到的条数(例如低档每个探针三条共九条,就分层抽样抽各三条)来跑模拟。
其中低档跑了一千万轮
中档500万轮
高档100万轮
这么多轮次中,我们划定一条线,在某个模型池中跑的模拟要99%以上都高于这条线,这条线就是“强指向线”,也就是概率探针判定指向某个模型的线,如果三个模型都没被强指向,那么显示证据不足
(并且这条线向下取整,实际更宽容)
然后高中低三档都是99%以上的轮次强指向对应模型,但是低档有不到0.5%的误报率,也就是错误强指向,中高档在这么多轮模拟中都是0%误报率
其实从概率学角度讲,如果请求数足够大,跑的模拟足够多,真实的概率距离我们设定的99%概率偏差是极小的,在几千条请求+上百万轮随机抽样下,其实已经把真实概率和我标定的99%准确率的偏差压倒很低了,我让ai估算过,几乎可以忽略不计。
那为什么还是有确实是本地账号,也确实请求的是sol模型,为什么会报证据不足或者错误的指向?
有三个比较可能的原因:
1 网络波动导致请求有部分错误,自动判定了证据不足,这是证据不足最典型的原因
2 奥特曼降智,这已经成为了错误指向和证据不足的主要原因,目前很多人测试都表明官方会将账号的请求路由到低级的模型,比如论坛里很知名的5.5mini,甚至据说有人抓包过后台,是明目张胆把sol的请求路由到luna 5.5 5.4 5.4mini的。这里也附上我自己的一个实测666奥特曼掺水被我抓住了
这个很早就有人讨论,我也在本地的日抛账号上实测复现过了。官方确实会对不同的账号实施动态风控降智。在新模型发布前大规模降智,并且路由到不同模型,这跟新模型大规模部署,哪个模型的算力池有余就降成哪个,是符合直觉的。
3 确实是小概率事件,但如上所说,概率非常小
另外还有几个不太可能的超小概率事件
1官方更换了模型的具体小版本,并且与上个版本差异大到指纹出现明显差距,但这样探针就会一直不准,而直到现在我大部分时间测试都是很准确的
总之一句话:如果模型是真实的(没有被中转掺水或奥特曼降智),且所有探测项目都完成了,低中高三档的正确强指向概率是99%以上,低档错误强指向是0.5%以下,误报证据不足也是0.5%左右,中高档证据不足概率1%以下,误报率0%。这是大量实测数据和数学模型算出来的,都可以参考GitHub的原始技术报告,有疑问也欢迎找我探讨。
如果有人使用or等可信api发现仍然有误报情况,欢迎找我反馈(api不降智 另外赏金就没有了,这个项目至始至终一毛钱金钱收益都没带给我 )
原文:目前评分第一的 aihub 中转站 号池是不是掺水了 - #48,来自 heymeow

 突然想到一个无敌的策略,佬能想到破局之法吗