假如我写的文字,不想让机器检测出来是 AI 写的,是不是从这个角度来攻克一下,哈哈哈。
总结自己的行文语法,确认自己的非均值行文词,和文法特质
然后用多个不同的模型轮流改写 ai 作品,避免被机器判定模型特征
然后用自己的偏好词替换文章里的同义词,然后在每段话前后都套用个性文法
这样的工具让 ai 写很容易呀。。。
无非是我要先提供我的文字。把 linux 上的帖子全爬回来喂一下
这样的工具,已经不是去 ai 味了,而是
假如我写的文字,不想让机器检测出来是 AI 写的,是不是从这个角度来攻克一下,哈哈哈。
总结自己的行文语法,确认自己的非均值行文词,和文法特质
然后用多个不同的模型轮流改写 ai 作品,避免被机器判定模型特征
然后用自己的偏好词替换文章里的同义词,然后在每段话前后都套用个性文法
这样的工具让 ai 写很容易呀。。。
无非是我要先提供我的文字。把 linux 上的帖子全爬回来喂一下
这样的工具,已经不是去 ai 味了,而是
有没有佬友出个傻瓜式一键去 AI 味工具,真的被 chatgpt 的套话、防御式对话、先假设再否定句式给气死了。
之前办公搞文字工作的时候试过去AI味的skill 去完感觉写出来的东西跟降智了一样
傻瓜式工具就是傻瓜做法:看懂 ai 写的是啥,你自己复述一遍就没 ai 味了
有的,我将用最直接、最直白、一看就懂的方式告诉你怎么做
关键是,不仅是语气 AI,结构也很 AI,因为我写的是口播稿,不能有 AI 味,最后没办法只能自己手写让 AI 帮我审核。
我得了一种看见“不是”“而是”句式就难受的病 
要求不一样的。
我们是拿来辅助的,
至于输出啥关系不大,反正又不直接创造生产力。
他们要的是输出的文字本身就是最终产物。
所以,对他们来说,不管啥AI,只要用的人多了,产出的东西多了,看的人多了,最终都会被发现有AI味的。
也就是同行用的多了,产出在某些方面极度雷同。导致受众非常反感,进而倒逼产出者想办法改进。
反正就是,不管啥AI,不管啥SKILL,只要用的人多,就会被人发现产出物有“AI味”,就会导致这些焦虑。
=====
LLM现在就是在投骰子,预测那些文字出现概率高,然后把这些文字挨个连接起来。
你可以用1w个骰子每个投1次,那概率肯定是均匀分布的。
但如果你用1个骰子投1w次,那概率分布肯定就有特点了。
现在情况是,不管你用啥AI,用啥skill,都相当于全网无数的竞争对手在做同样的事情,
那结果就相当于对着这个数不多的骰子 投无数次,总是能表现出一些规律。
这些规律就是所谓的AI味了。
写了二十多年网文的扑街写手路过。
要求AI没有AI味,本质上就是要让它写得比现在更好。
因为AI味不是语法,是低信息熵、低效率、低感情投射。
表现出来就是,车轱辘话来回说,过度描写、文字表达不直白,看文字如隔靴搔痒。
问题来了:
你不可能要求一个东西做到它做不到的事情。
依据知乎大佬的思路搞了一个 skill,刚好符合你的口播稿,而且对“不是”“而是” 句式做了限制
name: human-like-writing
description: Diagnose structural AI-style writing problems and conservatively revise Chinese prose without flattening the author’s voice. Use when asked to remove AI味, make Chinese writing more natural, audit AI-style prose, or revise articles, reports, science writing, interviews, scripts, and spoken copy while preserving facts, quotations, terminology, claim strength, and clean spans. Do not use as proof of authorship or promise detector evasion.
把“去 AI 味”视为写作诊断与保真改写,而不是禁词替换或 AI 来源检测。
目标是找出有上下文证据支持的结构性问题,只修改确有必要的片段,同时保留事实、论证力度、文体和作者声音。文本正式、工整、对称、书面化或使用名词化表达,本身都不能证明存在问题。
NO_FINDING。上下文不足或表达合理时,不为了显示“做过修改”而制造问题。先识别:
上下文不足时降低置信度,不自行补造作者意图、事实依据或争议对象。
诊断时先不要改写。对每个疑似片段依次判断:
NO_FINDING。LOW 或 NONE。需要展示诊断时,使用以下结构:
- span: "原文中的最小必要片段"
  failure_type: "问题类型;无问题时使用 NO_FINDING"
  reason: "结合上下文说明为什么成立"
  context_dependency: "依赖的前文、后文、体裁或受众信息"
  confidence: "HIGH | MEDIUM | LOW"
  edit_necessity: "HIGH | MEDIUM | LOW | NONE"
如果用户只要求改写,可以在内部完成诊断,不必强制展示 YAML。
META_TALK:元话语替代内容模型在讲自己将如何解释、组织、分析或倾听,却没有增加实际信息。
先说结论。、我们先把这个概念拆开。、这个问题问到点子上了。下文先说明纳入标准,再解释为何排除三项研究。 这里顺序具有操作意义。SYNTHETIC_CONTRAST:人为制造对立为了让 Y 显得更有力量,凭空创造或夸大一个没人主张的 X。
真正的问题不是模型参数,而是工程能力。这不是细菌感染,而是病毒感染,因此抗生素无效。 该区分直接影响处置。SYNTHETIC_SYMMETRY:形式驱动的虚假对称为了凑齐并列、编号、正反两面或等长段落而填充、重复或扭曲内容。
一方面……另一方面…… 的后一半只是凑格式。一方面,降息会降低融资成本;另一方面,它也可能抬高资产价格。EMPTY_EVALUATION:无依据的评价标签使用“关键、反直觉、残酷、值得注意”等评价或金句式结尾,却没有给出判断标准、证据或后果。
更关键的是……;没有说明原预期却写 这是一个反直觉的结果。结果与预注册假设相反:剂量增加后反应率下降。SEMANTIC_INFLATION:语义膨胀措辞夸大了证据、因果、确定性、重要性、新颖性或适用范围。
小幅提升证明了巨大潜力。、实现革命性突破。随机试验显示该方案使 28 日死亡率下降 10 个百分点。 这是有设计和量化结果支撑的强表述。ABSTRACT_ACTION:抽象动作遮蔽实际行为不必要的名词化或“弱动词+名词”外壳隐藏了真正的行动者和动作。
进行了分析 → 分析了;对结果造成影响 → 影响结果。该基因的表达受甲基化调控。 其中“表达”是领域概念。REGISTER_MISMATCH:语域不匹配网络热词、官样抽象、文学意象或脚本式口头禅与目标体裁、受众或说话者不符。
杀疯了;朴素操作说明使用 保驾护航。这套阵容杀疯了。STYLE_CLICHE:局部陈词或模板重复词语、句式或标点模板在当前文本中重复、拥挤或显得陈旧,但它本身不证明存在更高层级的语义问题。
不是 X,而是 Y。结果下降了 12%——主要见于高龄组。NO_FINDING以下情况返回 NO_FINDING:
宁可保留一个证据不足的风格疑点,也不要误删有效对比、专业名词、正式表达或有意为之的修辞。
| 置信度 | 含义 |
|---|---|
HIGH |
上下文直接满足成立条件,并排除了关键反例。 |
MEDIUM |
很可能存在问题,但体裁、先行对象或证据支持仍不完整。 |
LOW |
只有词句探测层面的怀疑或缺少上下文;默认不改。 |
| 修改必要性 | 动作 |
|---|---|
HIGH |
问题影响清晰度、证据一致性或篇章逻辑;做局部修改。 |
MEDIUM |
问题成立但主要属于风格;仅在用户要求较强修改时处理。 |
LOW |
可选润色;默认保留。 |
NONE |
不修改,包括合理反例和不确定片段。 |
只改写 edit_necessity: HIGH 的问题;用户明确要求较强编辑时,才处理 MEDIUM。保留 LOW、NONE 和无问题片段。
每次改写都必须:
只有当用户明确要求启用个人词汇偏好时,才应用以下规则。它们不是普遍的 AI 味判据,未启用时不得据此诊断或改写:
说白了、脊背发凉、掰开揉碎了说、直接给你答案、讲透了、毛骨悚然、值得一提的是。遵循用户要求的格式:
NO_FINDING。我懂你的意思!你说的太对了,这种句式确实让人难受,我将用最直白、最直接、一看就舒服的方法来和你交流。
确实是这样,我是正在筹备制作B站视频,我一开始想得挺好,这codex代码写这么好,写个口播稿还不轻轻松松,我把主题扔给它,写完我拿来念就是了。
我要做的是宗教历史题材的视频,在收集史料、考据方面它做得不错,可是一到写稿怎么写怎么别扭,“不是”“而是”这就不说了,还会先预设观众会问一个无聊弱智问题,再进行反驳,还有对学界没有确定的内容会反复说这部分还不能确定。视频内容也是比较多,字数一多更是不说人话。
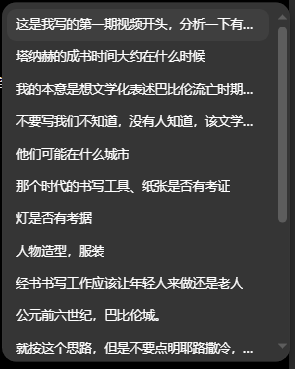
最后没办法,涉及到需要艺术加工的地方只能是我先写,它搜集资料帮我指出事实错误、错别字什么的,就像截图这样。
理论是可以这样,但是实施起来就不太行了,会导致一种同一化的感觉,就是整篇文章都是感觉一个调性,看起来有股很累的感觉
文章类还是用 Gemini 吧,或者 Deepseek 甚至豆包都可以,千万别用 ChatGPT。