测试显卡为rtx 3090,sglang版本:0.5.6.post3.dev9504
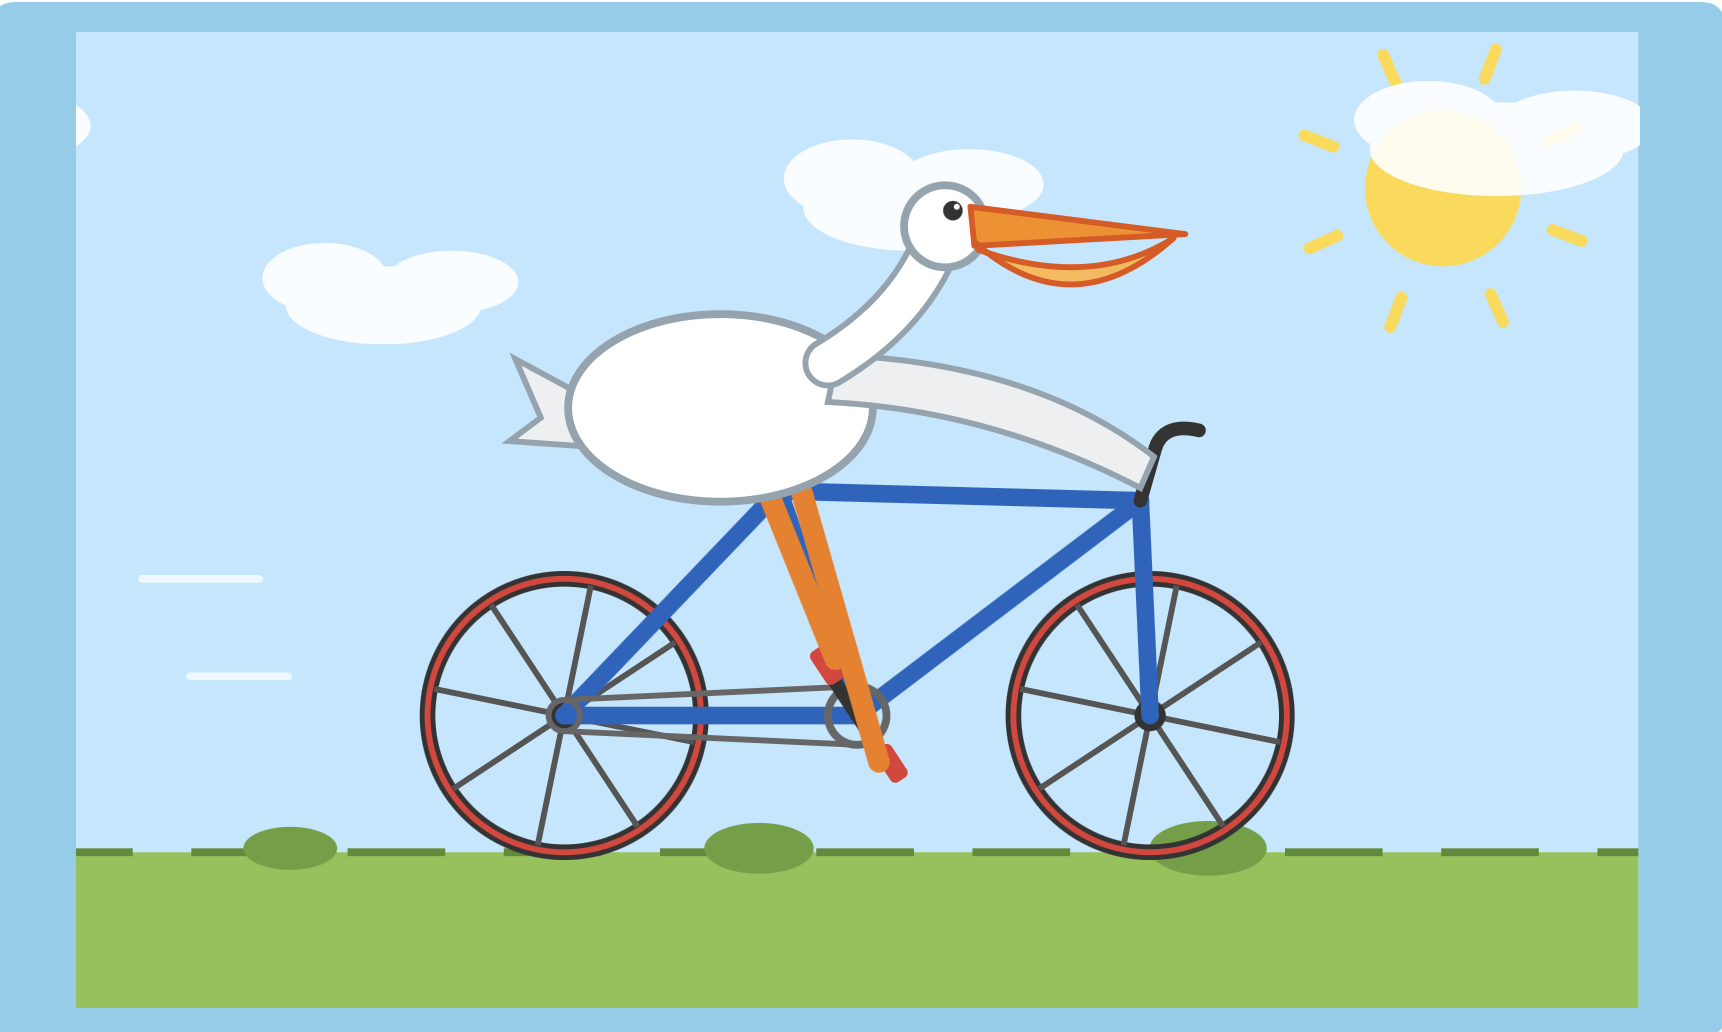
鹈鹕骑单车测试
最常见的group size = 128

group size = 64
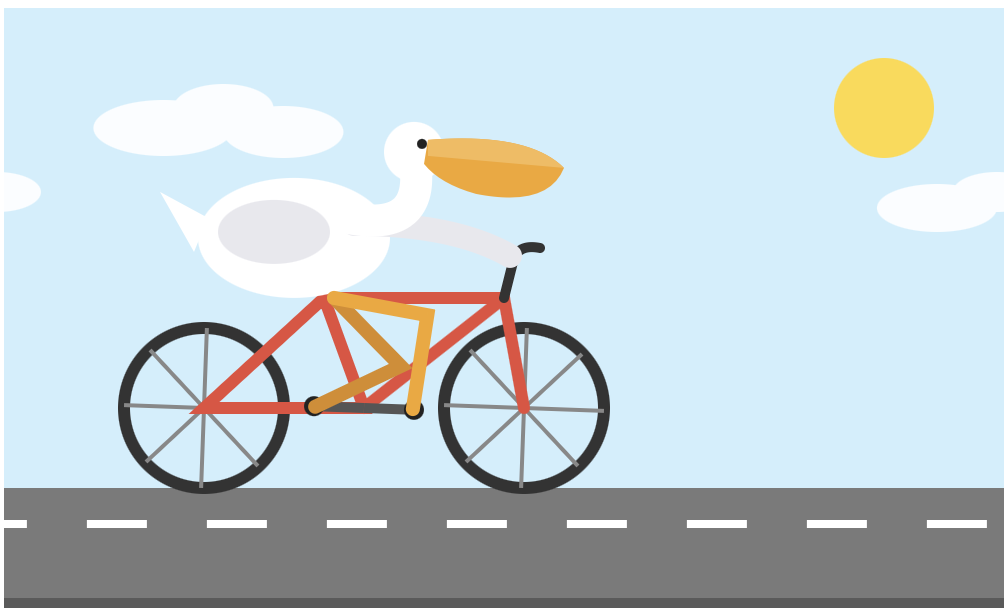
group size = 32
可用kv cache
| group size | token capacity |
|---|---|
| 128 | 121856 (119k) |
| 64 | 106560 (104k) |
| 32 | 77504 (75.7k) |
gemini spark一句话总结: 传统模型依靠无状态的纯 Softmax 注意力天然容错,而 Qwen3.8 采用了会逐步递归累积误差的 GatedDeltaNet 线性循环注意力与 256 维 QK-Norm,必须依赖 group_size=64 的细粒度尺度才能防止隐状态数值发散与注意力几何畸变。
个人觉得单流使用还是用unsloth的q4 km好一点,虽然速度慢了点