pdf/docx上传 ,想从试卷中提取题目、图形以及答案。做成1页1题的形式。 怎么提取。才能保证文字、选项、对应图片正确。
7 个赞
这个我刚好做过,是pdf转md后接AI格式化,pdf转md对接的minerU
4 个赞
好的, 转md确实是个新思路。 我试试 
看你想要做到什么精细程,这个没有想象中的好做。要兼容很多种情况,例如公式如何处理、图片会不会变形、多学科如何兼容等等

确实不好做, 我之前尝试了很多方式。 一开始只想提取内容,发现提取的效果差太多了。 后面让codex根据文档做课件。效果就很好。 我发现codex是用截图来实现的。html 中 所有内容都是图片。 但是我换了模型后效果就不太行了,某国产模型切分的图片,好几个题粘连在一起。如果能直接精准识别内容就更好了,后期数据使用更方便。
1 个赞
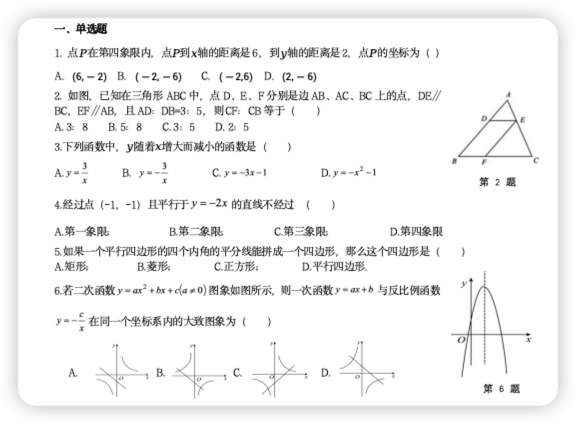
佬 如果是这种 第六题的图片占了 第五题和第六题右边的部分 转成md的时候 他能够对应好是第几题的图吗
用qwen3.8做,或者paddleocr-vl效果差一些,图的话用截图,让qwen3.8去对应
丢给GPT,他会用她的python工具慢慢裁剪的
转成md后,md里配图怎么处理的? 图片链接,还是图片都latex了?
纯图片用链接,公式用latex
1 个赞
谢谢了,兄弟。最近要识别一点东西。