可以用自己的api比如说deepseek进行非常低成本的ai自动tags生成,基于你自己确定的tags系统,不会产生tags冗余等等问题~
安装教程
Schema Tagger 的使用方式是:你维护标签列表,DeepSeek 阅读笔记并从列表中选择标签,插件检查结果后写入 tags。
下面的截图来自真实 Obsidian 运行界面,演示笔记和标签结果可以在仓库中复现。截图使用了自定义主题,默认主题下的颜色、字体可能不同。
1. 安装预览版
目前还没在 Obsidian 社区目录上架,先使用手动安装包。
下载 Schema Tagger 0.2.0 安装包。解压后会得到 schema-tagger 文件夹,里面应有三个文件:
schema-tagger/
├── main.js
├── manifest.json
└── styles.css
把整个文件夹放入当前仓库的 .obsidian/plugins/。如果你自定义过配置目录,请使用对应目录。重启或重新加载 Obsidian,然后在“设置 → 第三方插件”中启用 Schema Tagger。
找不到隐藏目录时:Windows 在资源管理器中显示隐藏项目;macOS Finder 可用 Command + Shift + .;Linux 常见文件管理器可用 Ctrl + H。插件装在仓库里,各系统的文件内容相同。
2. 配置 DeepSeek
打开“设置 → Schema Tagger”。接口和模型已默认填好:
| 设置 | 默认值 |
|---|---|
| 模型接口 | https://api.deepseek.com/chat/completions |
| 模型名称 | deepseek-flash |
| API 密钥 | 在 Obsidian 的密钥入口中新增或选择 |
首次使用时,API 密钥一行显示链接入口;配置完成后显示遮蔽值和“更改”。不要把 API Key 写进笔记或分享到截图里。

3. 告诉插件你的标签有哪些
点击“创建规范模板”,或选择已有的规范文件。新用户可以直接使用以下内容:
---
allowed_tags:
  - llm
  - research/paper
  - english/speaking
  - personal-growth
  - cs
  - plan/fitness
---
按自己的知识库调整这些标签。标签用英文小写,词间用连字符,最多三级,例如 research/paper。插件只从你列出的标签里选,不会创建拼写变体,也不会擅自扩充规范。
已有 Canonical namespaces 表格的用户可以继续使用:第三列中反引号包裹的词会作为白名单。
4. 给当前笔记补标签
打开一篇尚无 tags 的笔记,打开命令面板,运行 Schema Tagger:补齐当前笔记标签。
命令面板通常使用 Windows/Linux 的 Ctrl + P 或 macOS 的 Command + P。如果希望一步完成,在“设置 → 快捷键”中为这条命令绑定你喜欢的按键;插件不会抢占默认快捷键。
例如,这篇讨论论文阅读、语言模型和评测方法的演示笔记,DeepSeek 实际返回了 research/paper 和 llm:

再次运行“补齐”会跳过已有标签的笔记,不会为了重新分类重复调用模型。
5. 批量补齐最近的笔记
运行 Schema Tagger:预览最近缺标签的笔记。插件先在本地筛选,再显示清单。
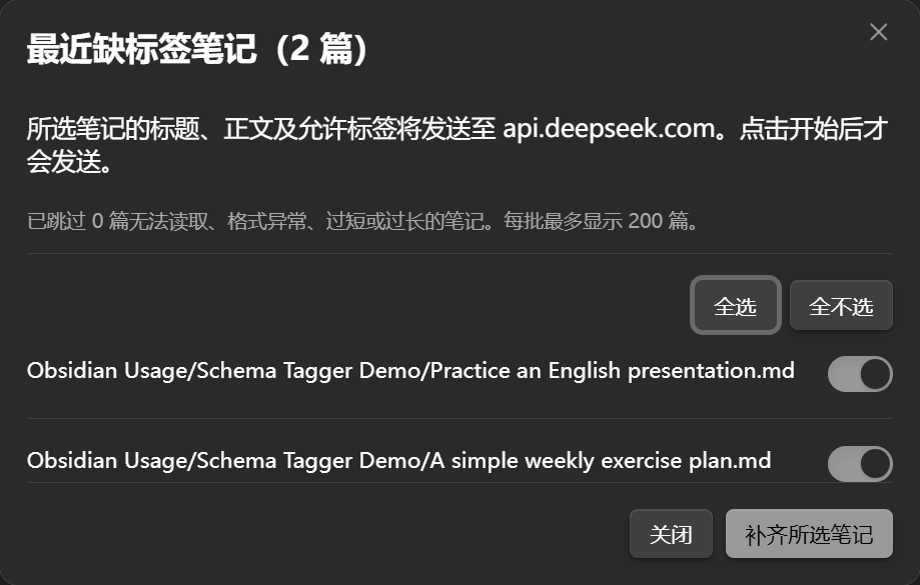
你可以全选、全不选或逐篇选择。点击“补齐所选笔记”后才会发送内容。运行过程中会显示进度,可以取消。
“最近天数”指过去这段时间内新建或修改过的笔记,只用于批量筛选;它不是自动运行周期,也不限制当前笔记命令。例如设为 7,就是扫描最近 7 天;设为 30,就是最近 30 天。
实际演示中,英语展示练习得到 english/speaking,锻炼计划得到 plan/fitness。AI 的选择可能因模型或内容变化而不同,应自行检查。
6. 整理已有标签,以及撤销
已有标签不准确时,运行 预览并重新整理当前笔记标签。插件先展示新旧标签,点击“应用标签”才会修改。

图中 reflection/daily 属于保护标签,因此保留;原来的普通标签 cs 被替换为更贴近正文的 research/paper 和 llm。
如果不满意,可以运行“撤销上次标签修改”。撤销记录只在当前插件会话中保存,最多 100 次;如果你在标签修改后又编辑了笔记,插件会拒绝覆盖这些新内容。