最近看站上分享科研工作流的帖子挺多,我也来水一点,给佬友们做个参考。
我从文献管理开始,用的是Zotero,文献下载下来之后,会用Awesome gpt插件先过一遍,做AI全文大纲分析和自动化的段落标注。这个插件是很早之前买的会员,所以能接各种网页版的AI。其实说实话现在这类功能自己AI手搓一个也不难,但这个作者一直在持续更新,我也就懒得换了,能用就继续用。
我在自己的香港公网服务器上搭了一个自用的中转站。起因是到处广薅各家羊毛,不同的软件都要填好几个端点,实在不好管理,干脆用现成的NewAPI的docker部署了一个。目前主要跑的是Agnes的免费API,虽然不算聪明,但读文献绝对是绰绰有余了。
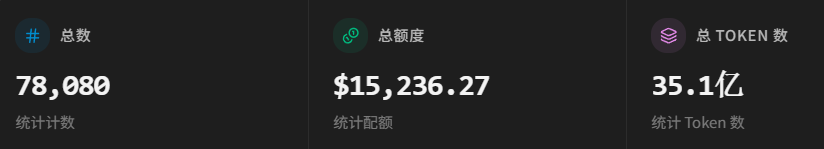
(这个配额这么离谱是因为薅羊毛的模型设置错价格了,并非富可敌国
 )
同一个服务器上还部署了一个hindsight记忆库,也是现成的docker镜像,给我的各个agent做统一的记忆系统接入。
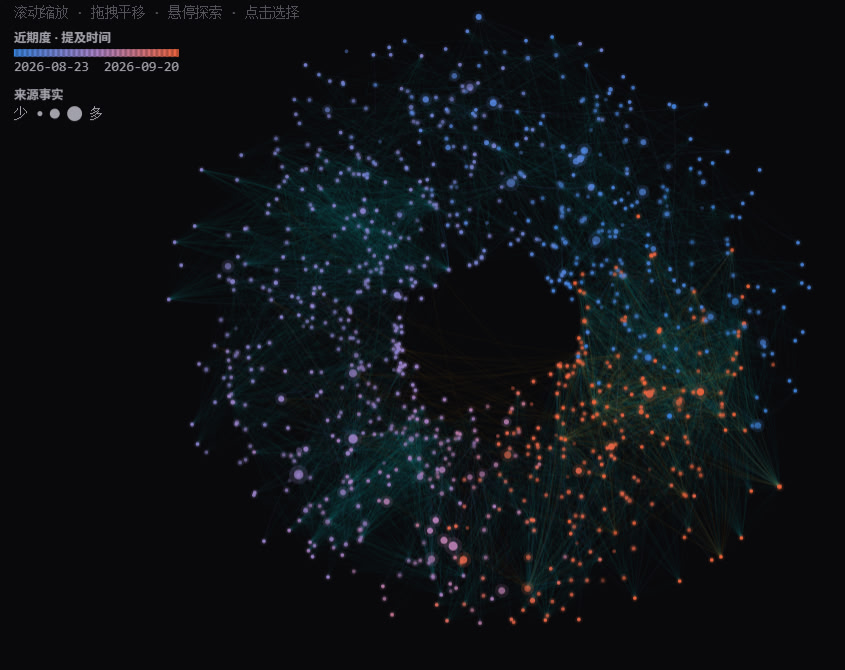
(到目前已经攒下了5.5k条记忆,也是薅免费模型用来合并和提取
 )
我是做药理的,平时会做到生信分析,其实就是写代码处理数据。现在主力用的是hermesagent。之前也折腾claudecode、opencode这类代码agent,也玩过openclaw和rustclaw。最后选hermes的原因也很简单:GUI做得好,更新也稳定(不知道现在openclaw还会不会自动爆炸)。另外有个我最喜欢的点是我的固定数据分析流程可以自动固化成skill,不用每次都从头搭建项目,这个还挺方便的,给这种设计理念点赞。
国模我基本都用过一点,这几个月用得最多的是deepseek-v4系列、glm-5.3-flash和deepseek-v4.1-flash。glm的代码和项目分析能力是真挺强的,帮我清理了不少之前agnes-2.5-flash写出来的屎山,重构质量出乎我意料。d4.1f最大的问题是雷霆大思考太多了(而且CoT拉的又快又多有的时候甚至看不清 ),明明不需要那么长的CoT的任务它也能给你想半天。个人体感下来,我的生信任务在hermes里开high思考强度比较合适,再高就是烧token等寂寞了。如果未来deepseek-flash下一代的后训练能像openai那样优化一下token工作效率,用更短的CoT把活干完就好了(许愿)
最近观察我还怀疑d4.1f的agent幻觉率相比glm貌似略高一些。但是这个是我最近才发觉,样本量还不大,有待进一步观察。
大概就是这些,我觉得选自己趁手的工具链是最重要的。
欢迎各位佬友交流