OrinX智能驾驶域控制的LLM+ComfyUI+源码+工作流AI辅助全自动部署包

本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:

  • 我的帖子已经打上 开源推广 标签: 是
  • 我的开源项目完整开源,无未开源部分: 是
  • 我的开源项目已链接认可 LINUX DO 社区: 是
  • 我帖子内的项目介绍,AI生成、润色内容部分已截图发出: 是
  • 以上选择我承诺是永久有效的,接受社区和佬友监督: 是

以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出


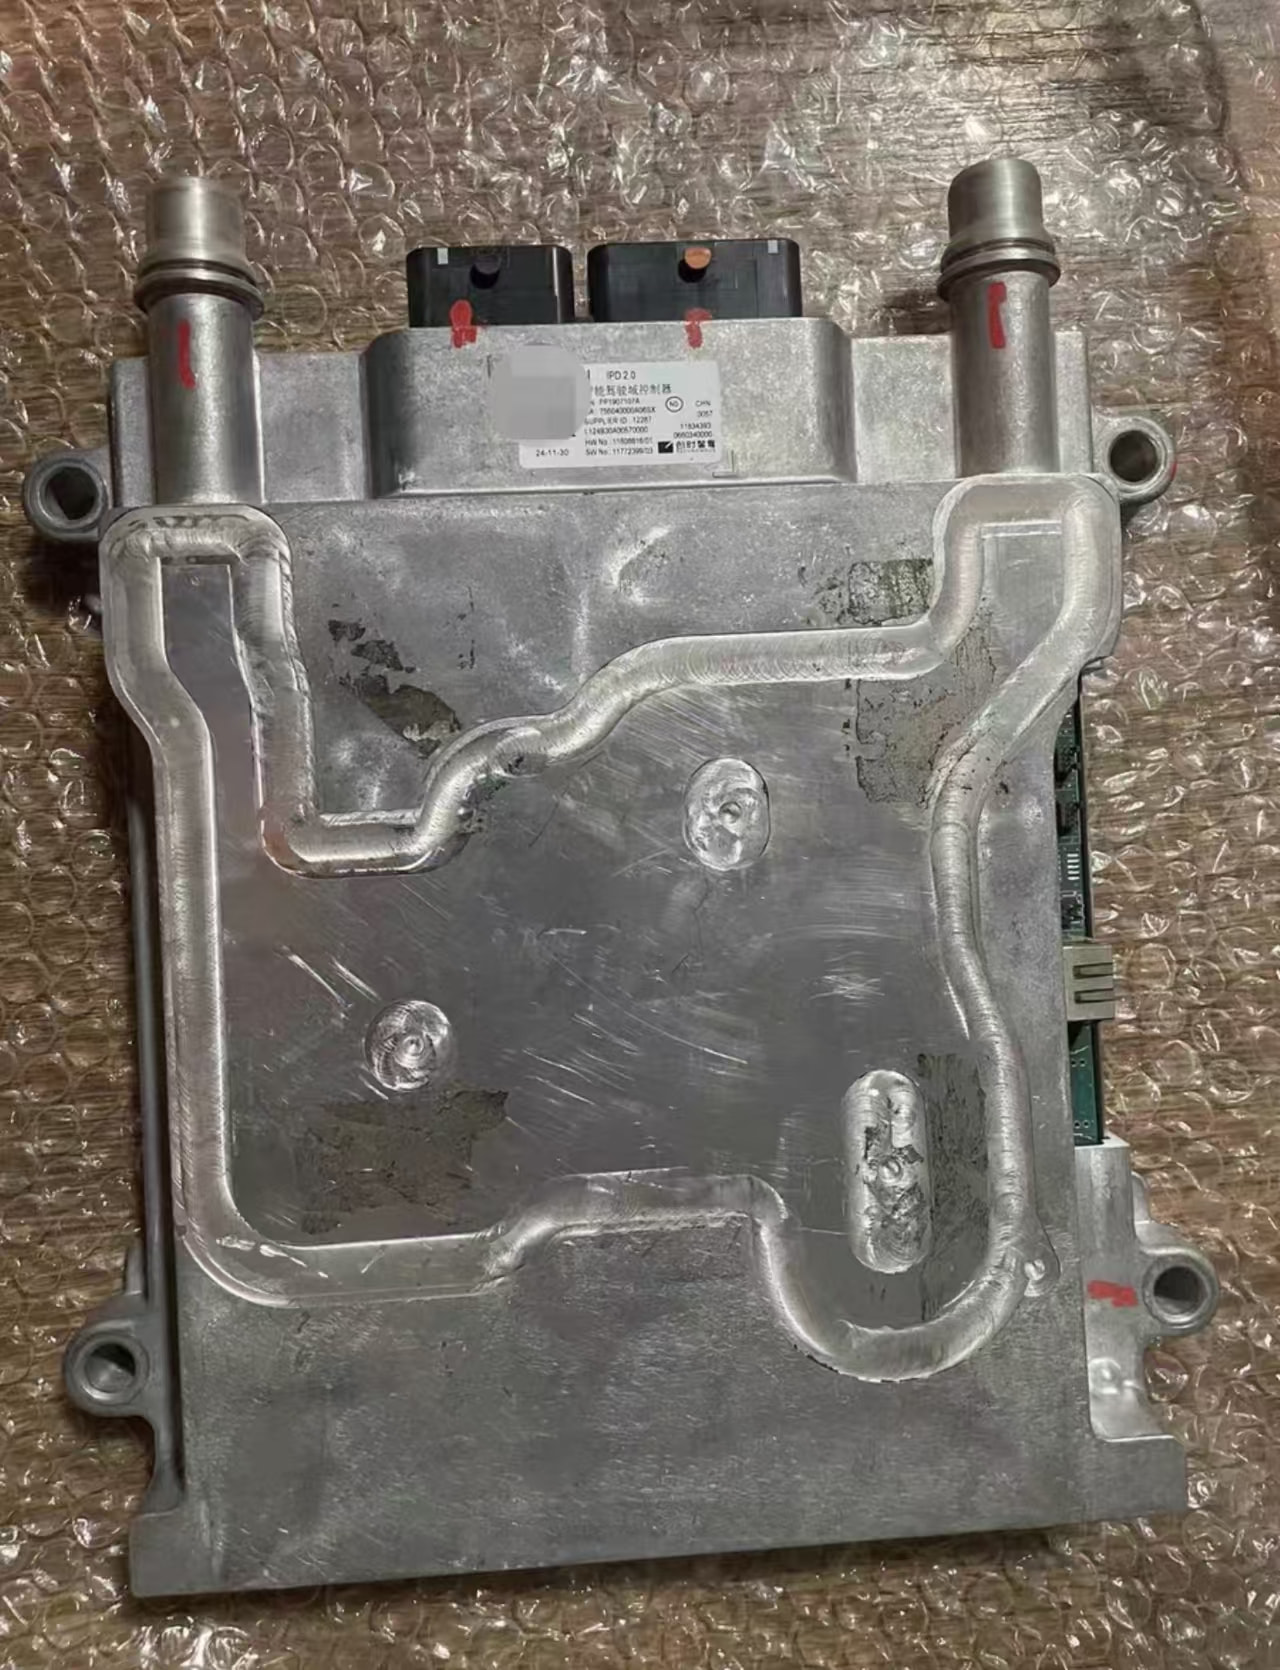
创时智驾 IECU 3.1 是一块智驾域控制器(主要有智己LS9和奥迪E5 2个版本),价格1000多块钱,拿来跑个35B MOE模型或者最近热门的JEV开源版速度还将就。原始的板子因为runtime版本过低跑不了ComfyUI,这个包魔改了运行时,Z-image和H3都可以跑,直接把它下载下来做为一个项目,让Codex或者CC去帮你部署即可.

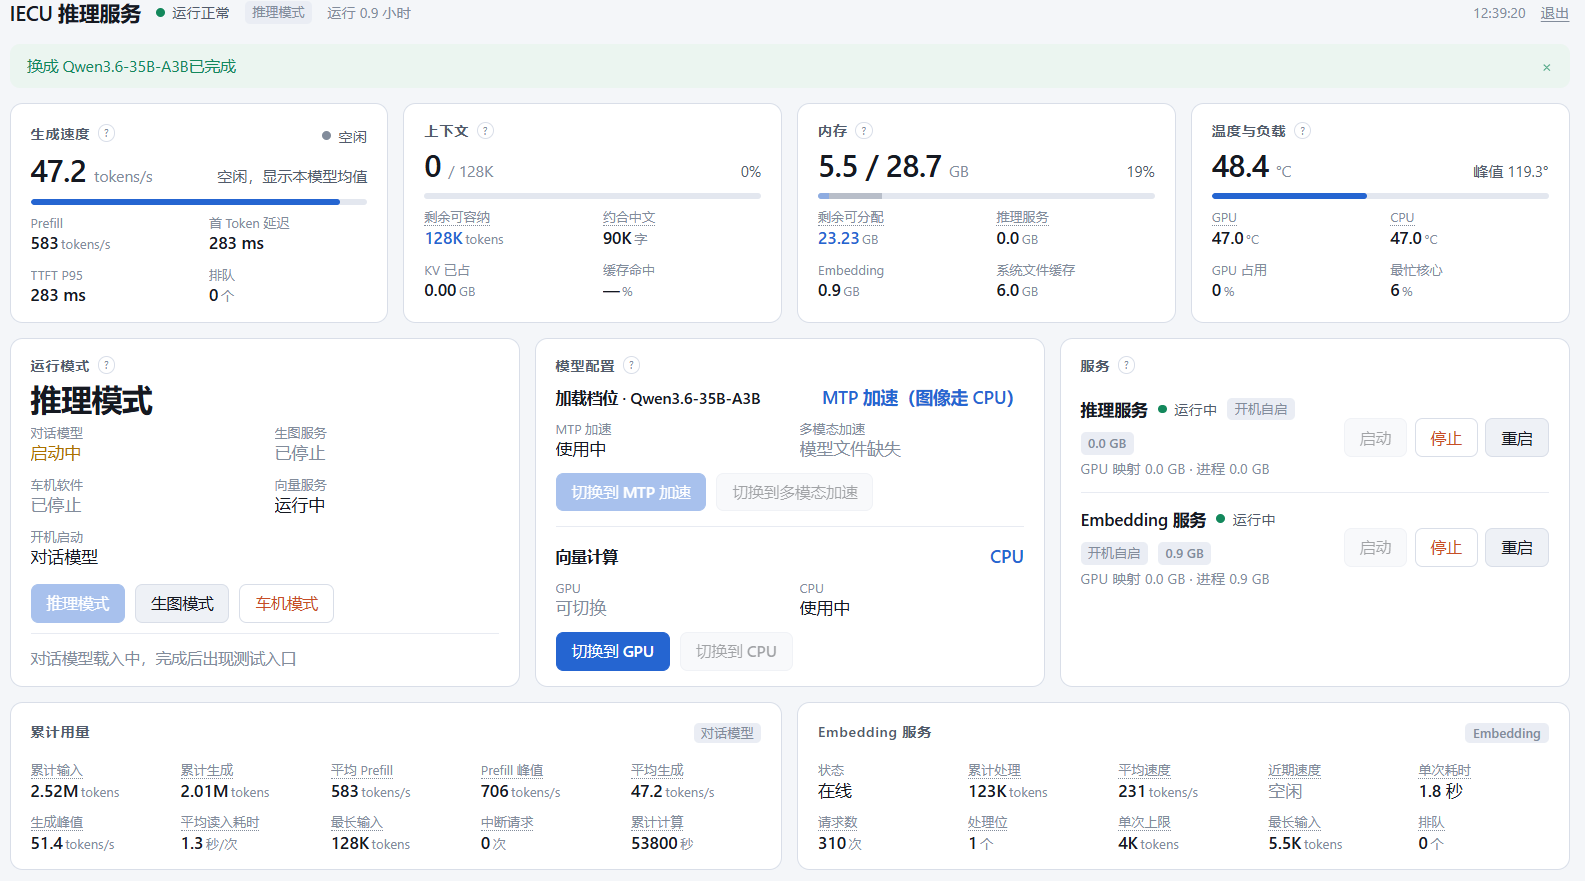
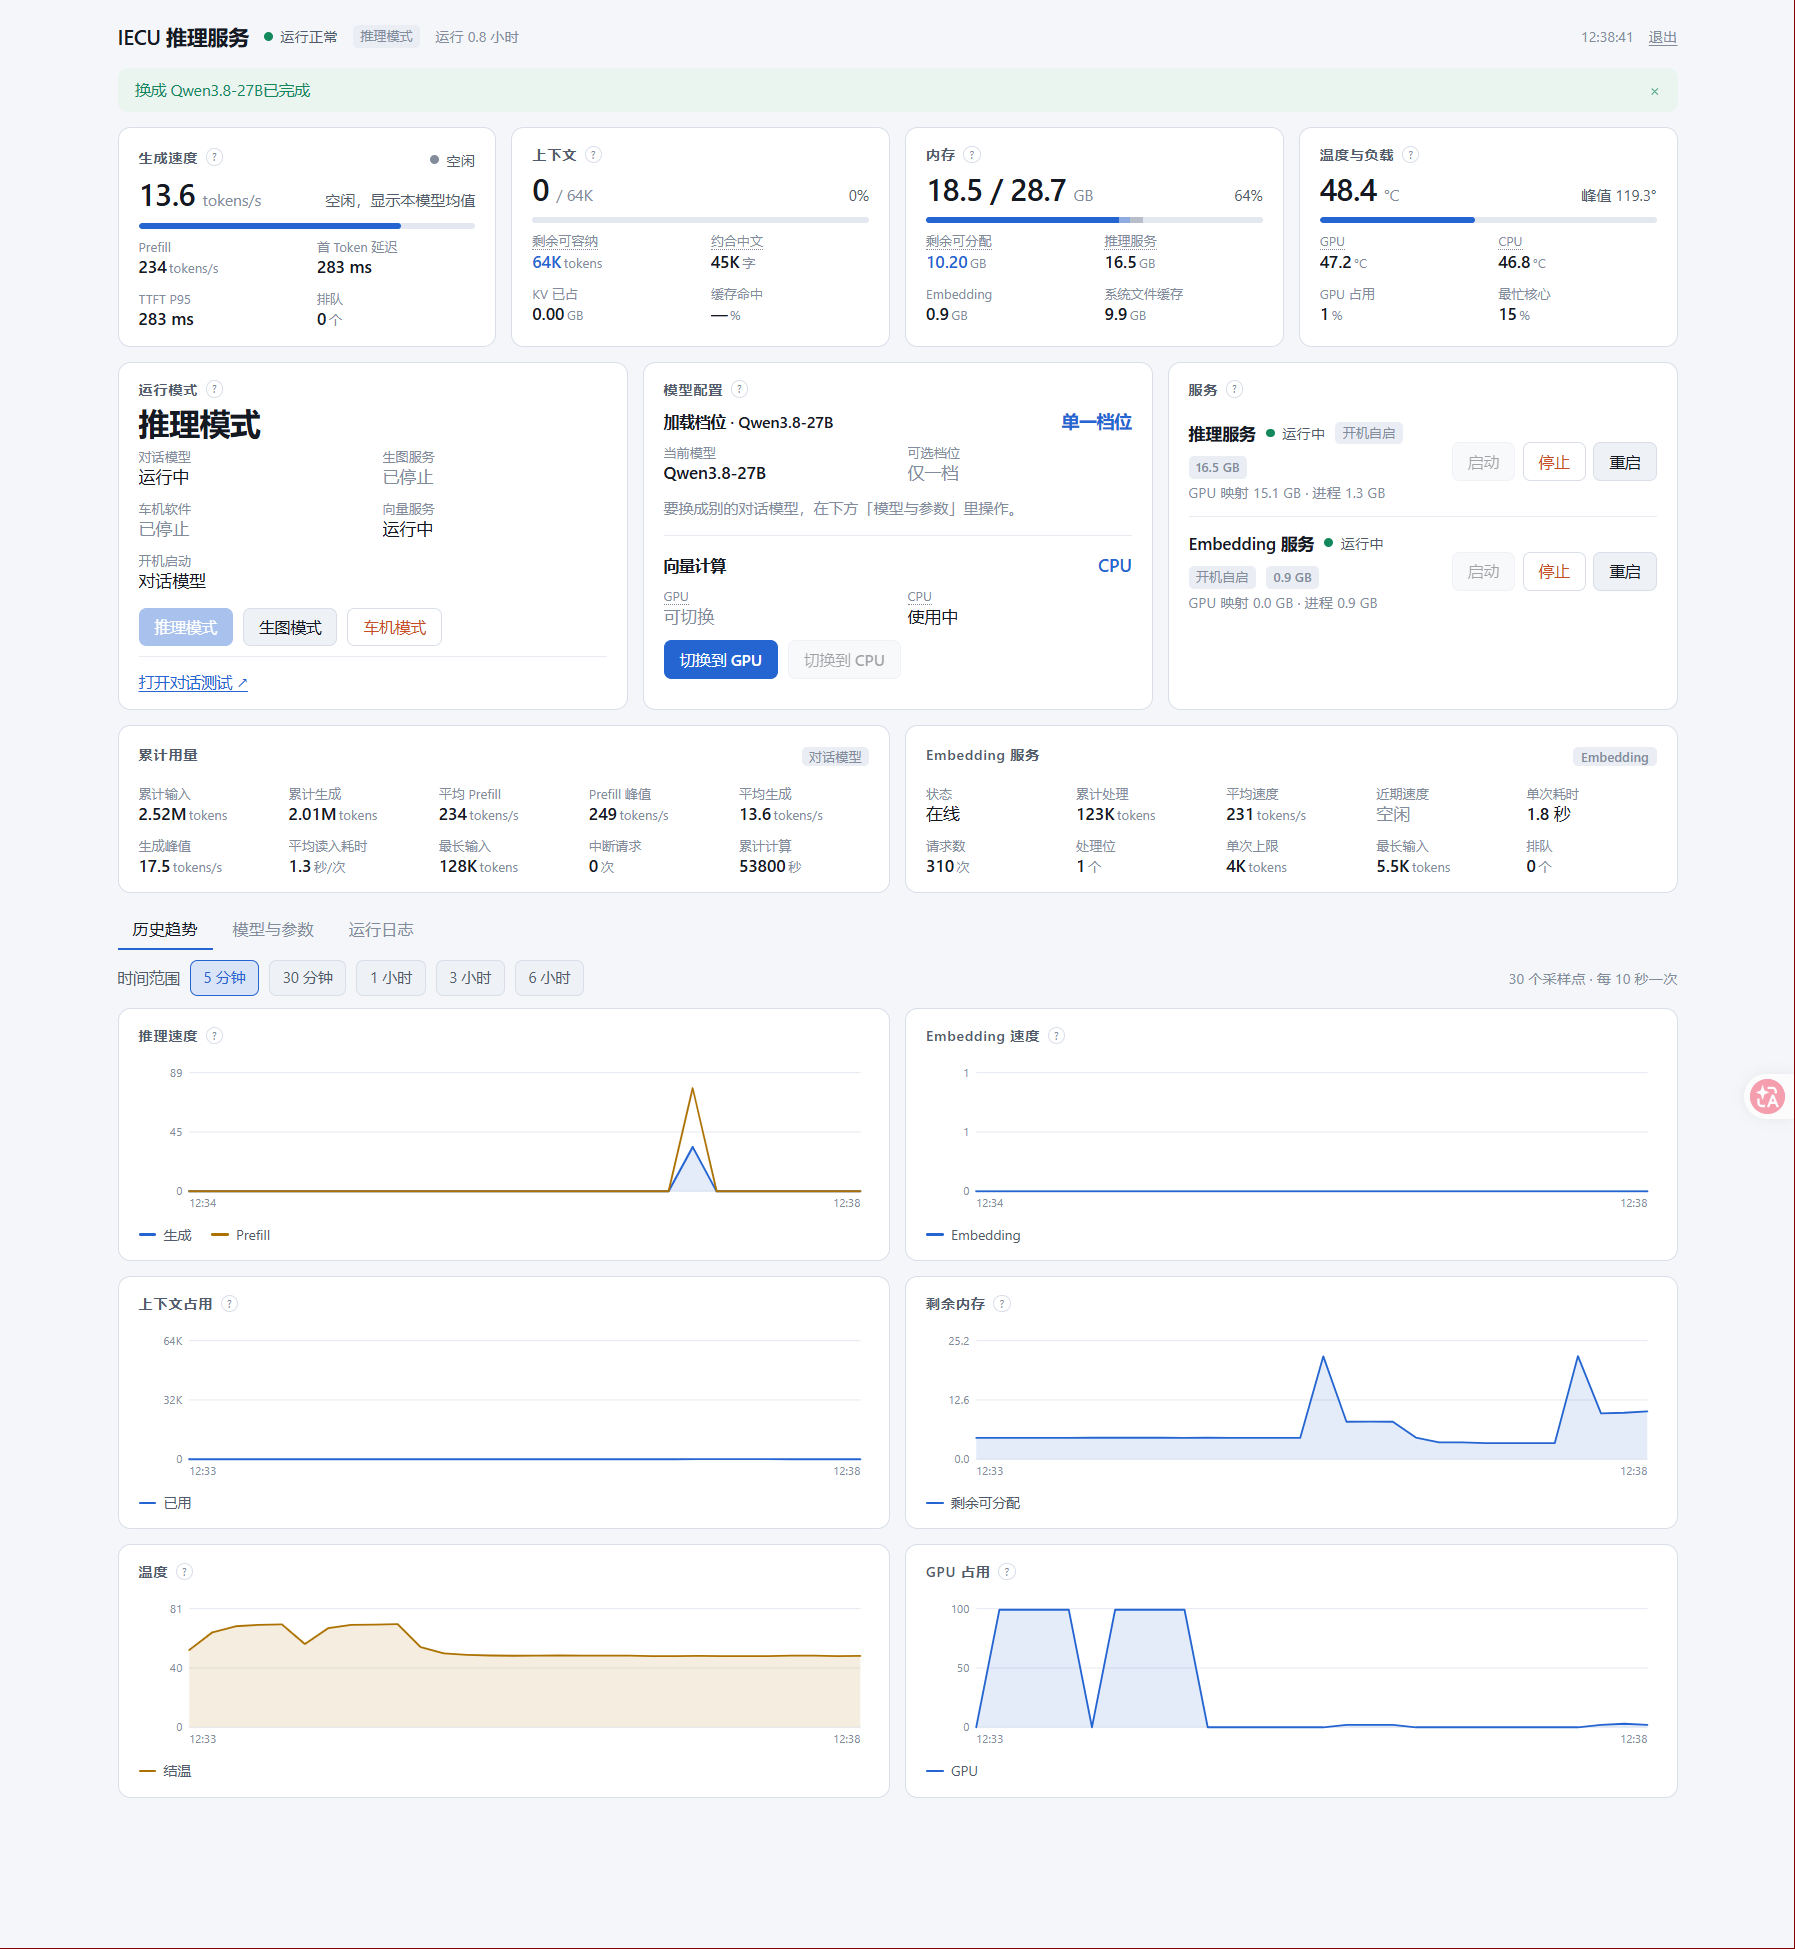
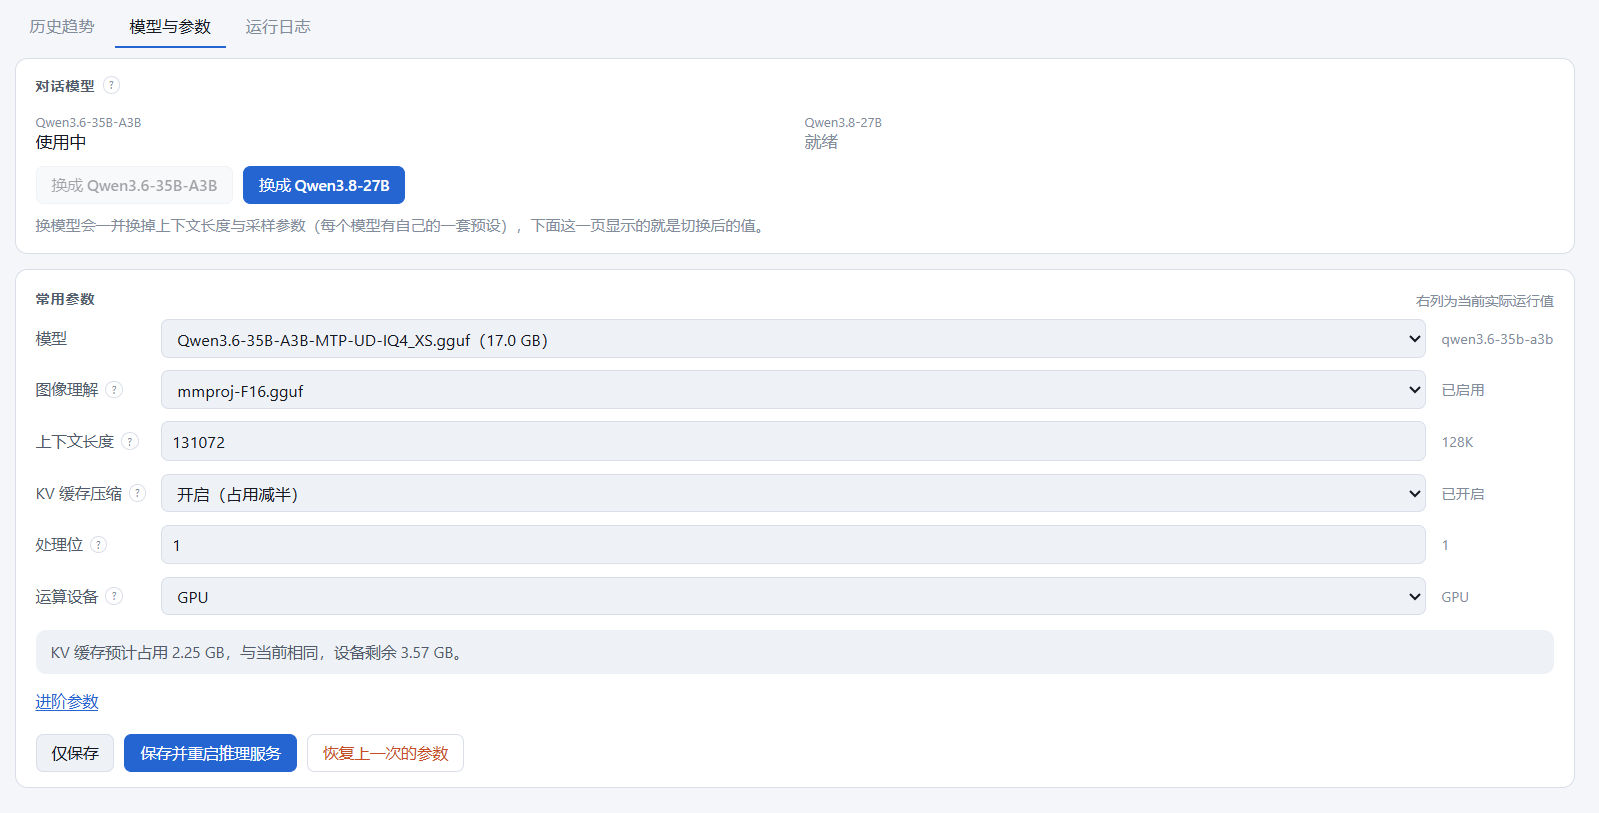
它内置了一个WEB面板,可便捷切换Qwen3.6-35b-a3b/Qwen3.8-27b(带Qwen Embedding模型,单板可跑私有Rag ),ComfyUI生图环境,带全套源码、Skills工作流、部署包、运维面板源码和完整部署资料。skills可以自动分析接入的板子,如果成功进入ssh则可完成自动化部署。

这个设备的硬件与原始系统情况如下:

  • NVIDIA DRIVE AGX Orin X

  • 12 核 CPU

  • 标称约 254T 算力

  • 32GB 统一内存

  • 128GB UFS 存储

  • DRIVE OS 6.0.9

  • Ubuntu 20.04 用户空间

  • 支持以太网和 SSH 登录

  • 原厂车机系统保留,可切回车机模式

    本部署包已完成的主要优化:

  1. 本地大模型
    板上已经部署两套大模型环境:
  • 35B:Qwen3.6-35B-A3B,
    支持 MTP+多模态同时在线,速度约 30~50 token/s

  • 27B:Qwen3.8-27B,速度约 10~15 token/s

  • 两套模型可以通过面板按需切换
    针对 MTP 加速和多模态看图之间的冲突进行了专项调优,现在两套能力都可以稳定使用:

  • MTP 对话模式(cpu多模态)

  • 多模态看图模式(gpu多模态)

  • 工具调用

  • 128K 上下文

  • Embedding 向量服务

  • 相对llama.cpp直接部署提速20%

  • 面板带thinking和nothinking2套推理端点适配不同需求(深度推理和指令跟随)

  1. ComfyUI 生图
    原板子不兼容生图,已根据板上实际环境,编译专用运行时,这些都是魔改的,把很多高版本的能力编译进了低版本,解决了依赖问题:
  • Python 3.13.15(魔改版)

  • PyTorch 2.11.0(魔改版)

  • torchvision 0.26.0

  • torchaudio 2.11.0

  • CUDA 12.2,Tegra / arm64 版本(魔改版)

  • cuDNN 9.20

  • OpenBLAS 0.3.29

  • Flash Attention
    经过多套运行时编译和实际测试,最终选定兼容性和速度最合适的版本。

    本部署包优化后的实测效果:

  • Z-Image,1024×1024,8 步连续出图:约 30.4 秒

  • 相比上一代环境,实际吞吐提升约 40%

  • ControlNet 双分支,512×512:约 21.3 秒

  • 原来跑不动的 ControlNet 双分支,现在可以正常出图

  • 首张出图约 82 秒,包含模型加载时间

  1. 中文运维面板情况如下
    设计了一套中文运维面板,可以统一管理:
  • 推理模式

  • 生图模式

  • 车机模式

  • 大模型预设切换

  • ComfyUI 服务

  • 模型参数

  • CPU、GPU、内存和温度

  • 推理速度和生图耗时

  • 服务日志

  • 网络状态
    三种主要模式按需切换,避免大模型、生图环境和车机系统同时占用大量内存。

四个 Skills的作用:

  • board-discovery(陌生板卡发现与接入)
    拿到一个新板后,自动尝试对接解码,解决新板不知道型号、MAC、IP、VLAN、端口和登录方式的问题。
  • iecu(现有板子运维与二次开发)
    用于换模型、调参数、看监控、排障、管理服务和继续开发。
  • iecu-provision(新板基线部署)
    把一块新板部署成完整的本地 AI 系统。
  • comfyui-import(ComfyUI 工作流导入与适配)
    用于检查缺失节点和模型、替换量化模型、适配工作流并验证真实出图。
18 个赞

可以讲一下哪些板卡是可用的吗?然后板卡的条件是什么?

2 个赞

智己ls6的c样,和奥迪e5的。。你看这个造型,带网口的应该都行。

1 个赞

什么意思,型号对,随便买?我记得您之前的帖子说需要能开SSH。现在还需要专门考虑吗?拆车件是否可行?

1 个赞

智己、奥迪orinx系列的带网口的应该都能ssh。索尔车机的都不带网口,需要type-c转网口。并且领克的需要can报文,有看门狗,挺麻烦。个人觉得orinx这个价格跑个qwen moe或者开源jev就很香了。thor看似64g,实际gpu只能读到46g,价格是这个的接近3倍,意义不大。

2 个赞

就像我之前回复的一样,这个可以用兼容包升级到12.4,这样可以关闭pytorch的版本检测编译最新版本,就没这么多魔改包的事了。然后奥迪和智己的内核是不一样的,有一些权限上的区别。智己一般是24g可识别内存,奥迪是28g,奥迪的单网口会挑网线和接口,会出现插2.5g亮灯到不上线的情况。

2 个赞

在B站看到过有人玩这个,但是还是有很多坑的,现在都涨价了

1 个赞

再贵的确没意义了。这玩意最适合的场景就是跑qwen3.6-35b-a3b,能到30-40t/s,完全达到可用性门槛了。这个机器的cpu性能也不差,可以部署有隐私需求的轻量ai应用,模型和后台应用一个板子就能解决。我给我媳妇vibe的ai辅助工作台就部署在这个上面的。平时放办公室离线运行,可以帮她把处室和下属局提交的简报做初评筛选,自动写驳回意见或者转化格式,在符合保密规定的前提下给媳妇提供个ai小助手,帮她出个初稿给她参考,可以省点精力。

1 个赞

不对吧,我奥迪板子和智己板子都有,都是28.7g。唯一得区别就是硬盘得挂载分区不太一样。。难道不同时期生产得板子区别这么大?

1 个赞

那问一下佬具体在哪里淘的?没发现哪里有渠道

1 个赞

最近也是想部署点小模型自用

1 个赞

就是咸鱼,多问问吧。还是有很多没涨价的

2 个赞

搞两个串流会更爽吧


这样的壳子,右侧有1个或者2个网口的都可以.1个网口的是千兆口,一般是奥迪板和比较新的智己板,2个的是比较早期的智己版,一个千兆1个万兆

2 个赞

智己的可以开到28g,但鱼上的人一般统一刷,只开到24g,当然现在如何就不知道了,但起码上个月还是这样

:rofl:应该是卖家没搞好,我截图的板子就是智己双网口的C样,8月初买的..

我读了下你的skill,你的驱动是541的,和我的530的不一样。在541的驱动上可以直接使用cuda-compat (CUDA Forward Compatibility Package)兼容cu12.6,基本就不用改东西直接编译了,你有测试过这个吗

因为搞完这个都一个多月了,记得不太清了…印象中被逼到编译这个路的原因好像和cuda没啥关系,印象中cuda原厂是11.X的版本,本身它可以升级到更高的版本,但是高版本下兼容性反而有问题..直接上高版本的好像和cuda还是啥不兼容,低版本又跑不起来新版comfyui.反正就是按下这头那头翘起来了..印象中好像是新版本的Comfyui对Python和PyTorch的版本有要求,好像是有一些调用是新版的写法,在老版上就会报错。最后的折中之道,就是一点一点降级去找折中点,降级到这个12.2才搞定的.好像是找到了comfyui更新后,有几个功能需要依赖高版本的Python和PyTorch的某几个写法,绝大多数都是兼容的.所以接去改造Python和PyTorch让新写法能等效低版本的方法,等于是骗过了comfyui,属于绕道过去了..

看样子你没有用过兼容包。这个在530驱动都能上12.5。
然后编译pytorch是必须的,官方预编译包是不带sm87的,l4t的停留在老版本,只有自己编。
你可以抽空让ai试下,这个是个专门用于在低版本驱动上运行高版本cuda的包,消费级是不支持的,但这个板子正好支持。

我翻到之前的开发记录了,
你可能想简单了,
这块板子这个板子是DRIVE OS,
不是标准JetPack环境,
所以标准环境的经验在这儿行不通。
cuda-compat +CUDA更高版这条路调试的时候测过,
是条死路,原因是这样的:

CUDA12.4和12.9都编译过新版PyTorch,
wheel 正常安装,但运行时直接报错。
顺着PyTorch源码定位过根因是torch的c10/cuda/driver_api.h里有一张驱动函数绑定表,按编译时的 CUDA 版本条件编入:

  • 12.3至12.7绑定 multicast组,运行时报cudaErrorDevicesUnavailable(46),这个能力需要NVSwitch,Tegra单SoC物理上没有。
  • 12.8及以上绑定green context组,运行时报cudaErrorSymbolNotFound(500),这个R530内核态驱动没有这些函数。。

cuda-compat只换用户态库,内核态驱动动不了,这两组绑定都过不去。
而且compat本身是JetPack那边的机制,
DiverOS Orinx的高版本用户态不需要compat就能直接装上,
12.9也可以用,LLM可以跑..但搞Comfyui的结果就是上面两个错误码。

所以要跑Comfyui,
又要保障尽可能高的CUDA版本以提供向后兼容性的情况下,
实际跑通的版本链就成这样了:
ComfyUI新版本需要较新的torch
→ torch需要较新的Python
→ 另外编了Python 3.13
→ CUDA12.3被multicast卡死,12.8及以上还多了green context绑定都过不了
→ Tegra ARM64包里能避开这两个问题、同时又足够新的只有CUDA12.2

最终组合就是这个项目提供的Python3.13 + torch2.11 + CUDA12.2三件套
如果只是跑ComfyUI,这个包FA、flex_attention都有,没必要追更高版本号了。

另外你说的智己版印象中我好像也遇到过。
这个100%是卖家误读,随便拿了个数就给你说了。
他把CUDA报的当时可用内存当成了板子实际容量。
这块板是统一内存,CUDA可见的可用量会随系统负载变化,
加载大模型并使用–highvram 后,
模型权重通过nvmap 制常驻映射到内存,
这部分占用不计入普通进程RSS,但是MemAvailable少了。
跑着推理服务时被nvmap常驻的模型权重占掉约5G,
读出来正好是23.7G≈24G。
把服务停掉或者清掉权重,
MemTotal 29415 MB就全部可用。
实际上这个板子也能跑通Qwen3.6-35B-A3B Q4的128K上下文,
还能塞一个Qwen-0.6B的embedding服务,
28.7G可以用的满满当当的

1 个赞