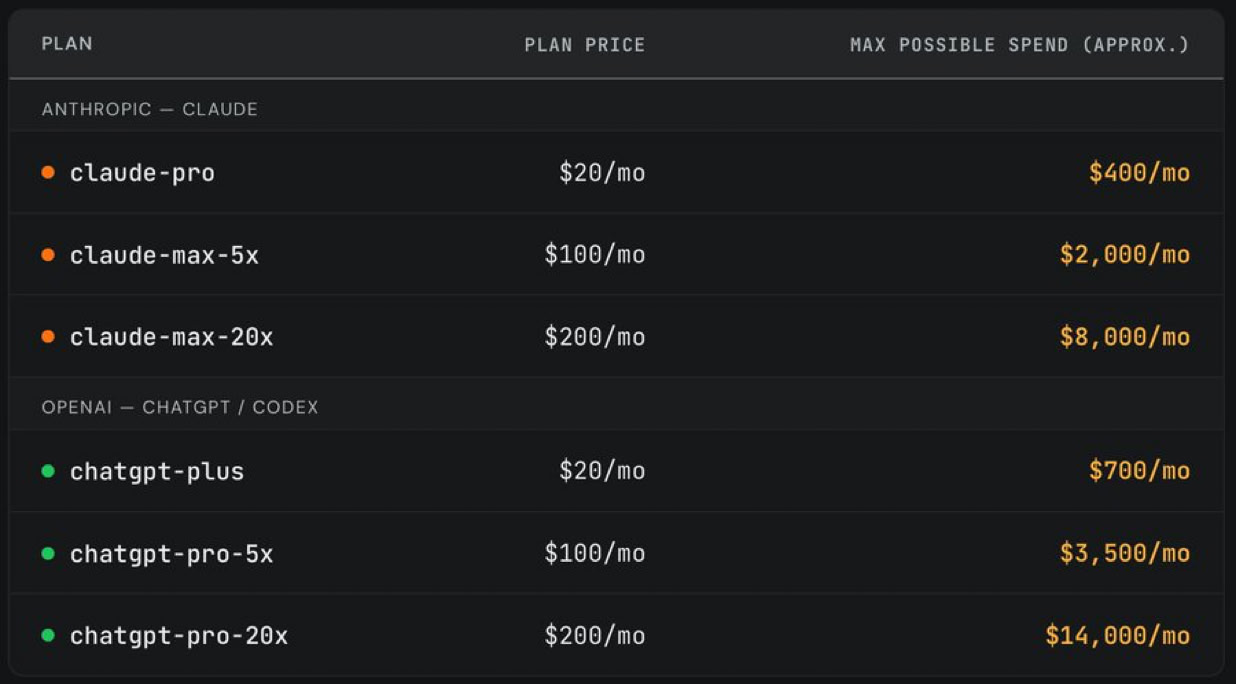
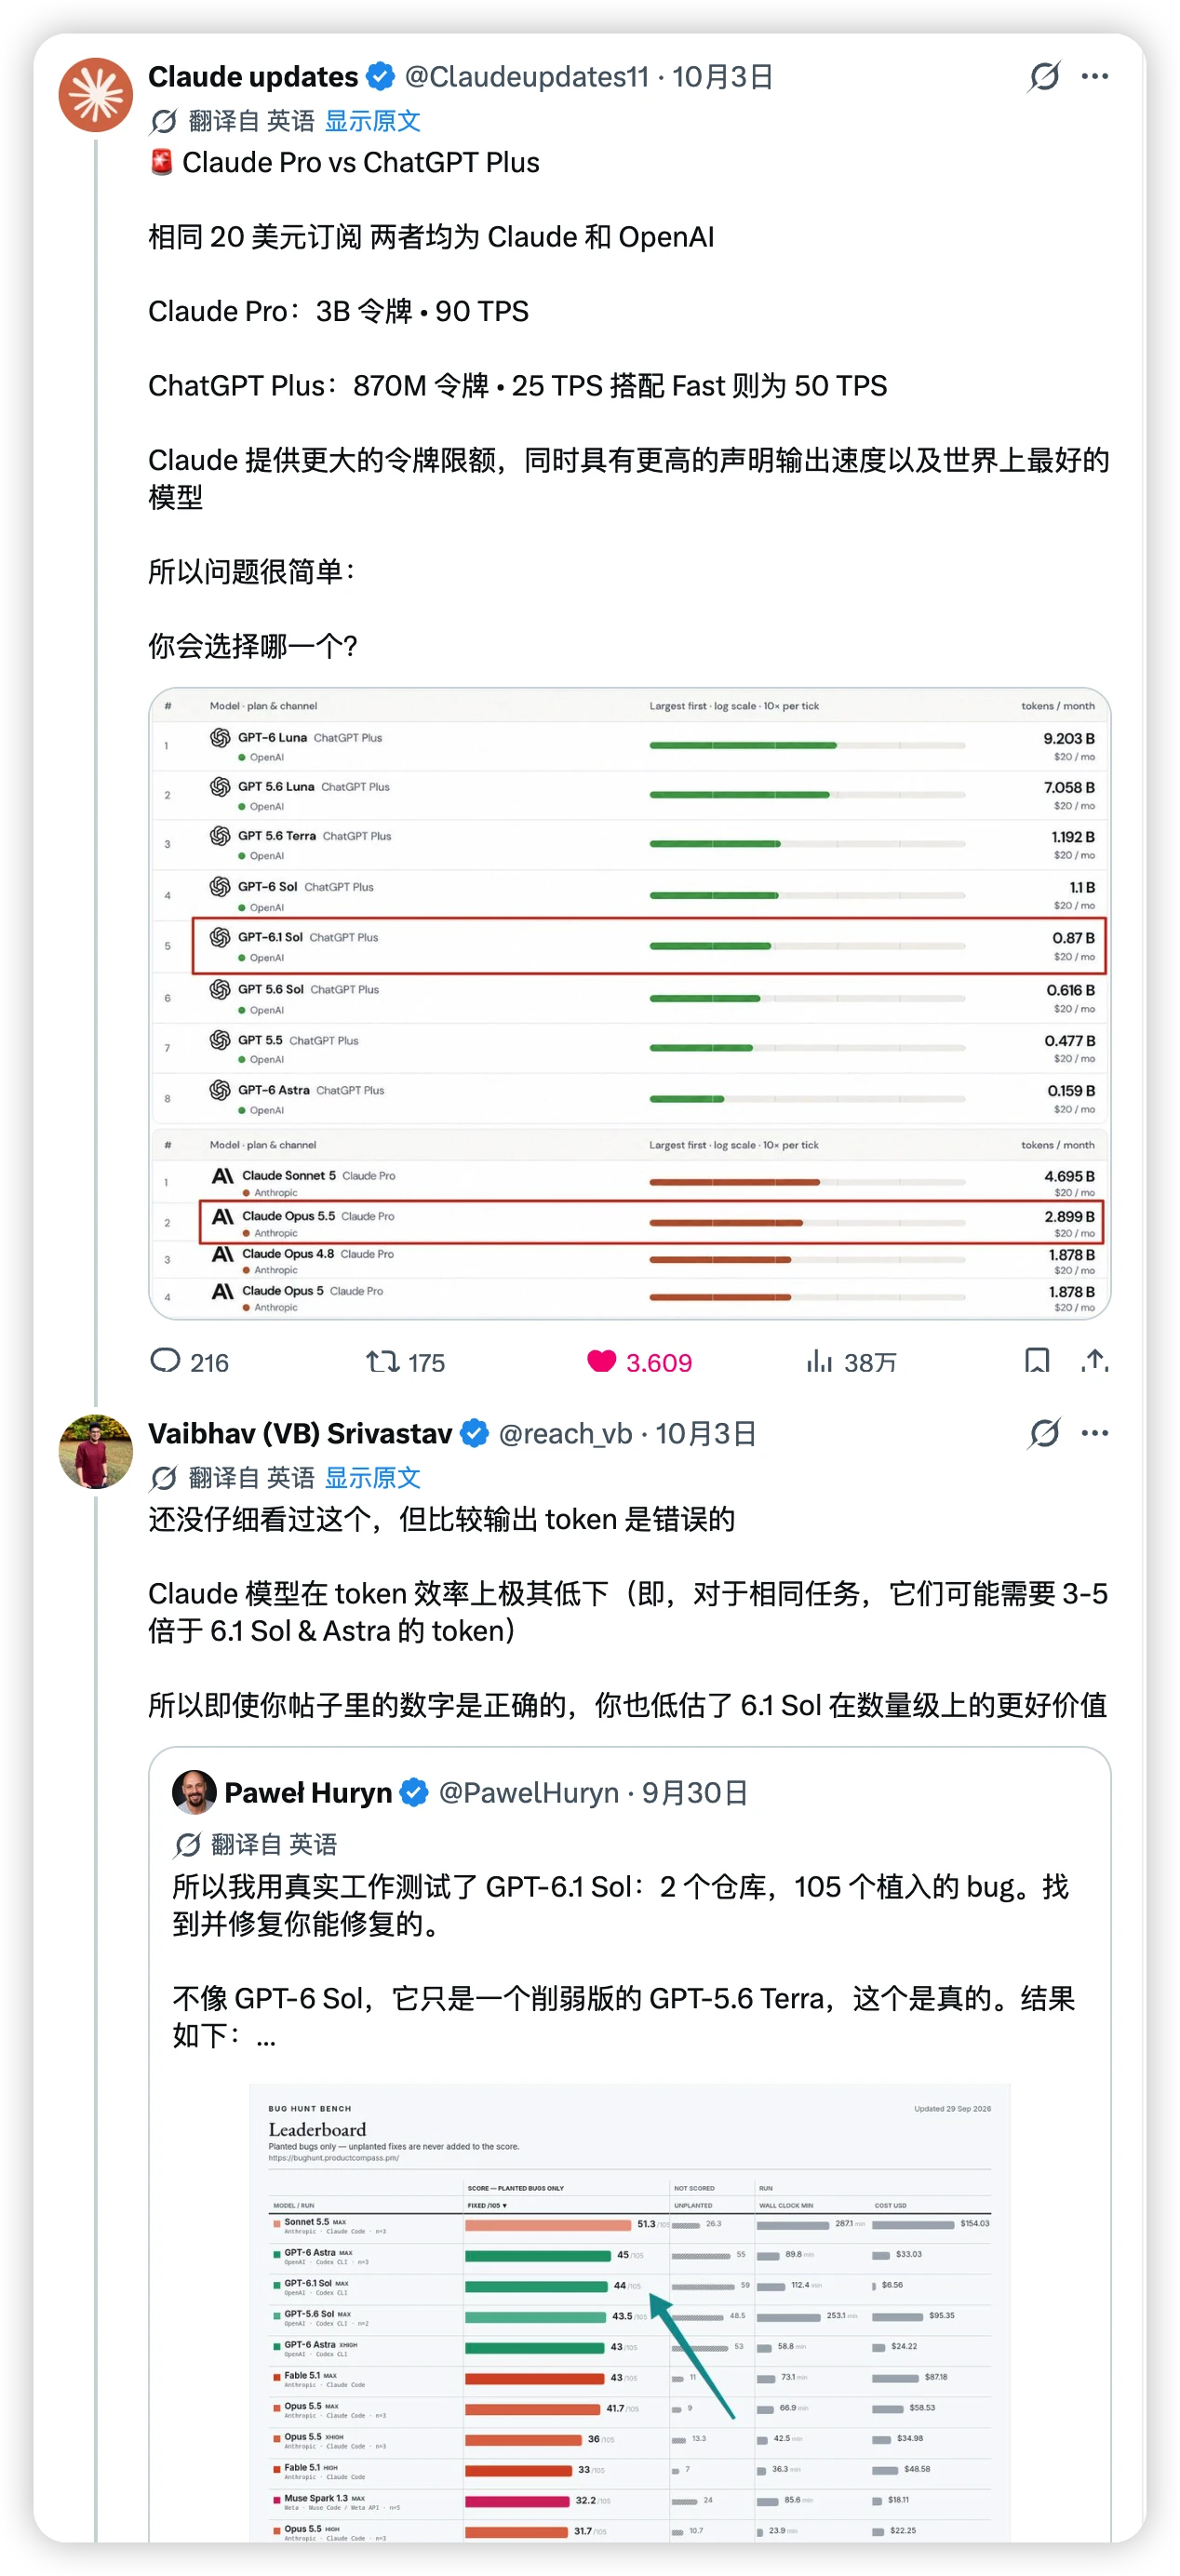
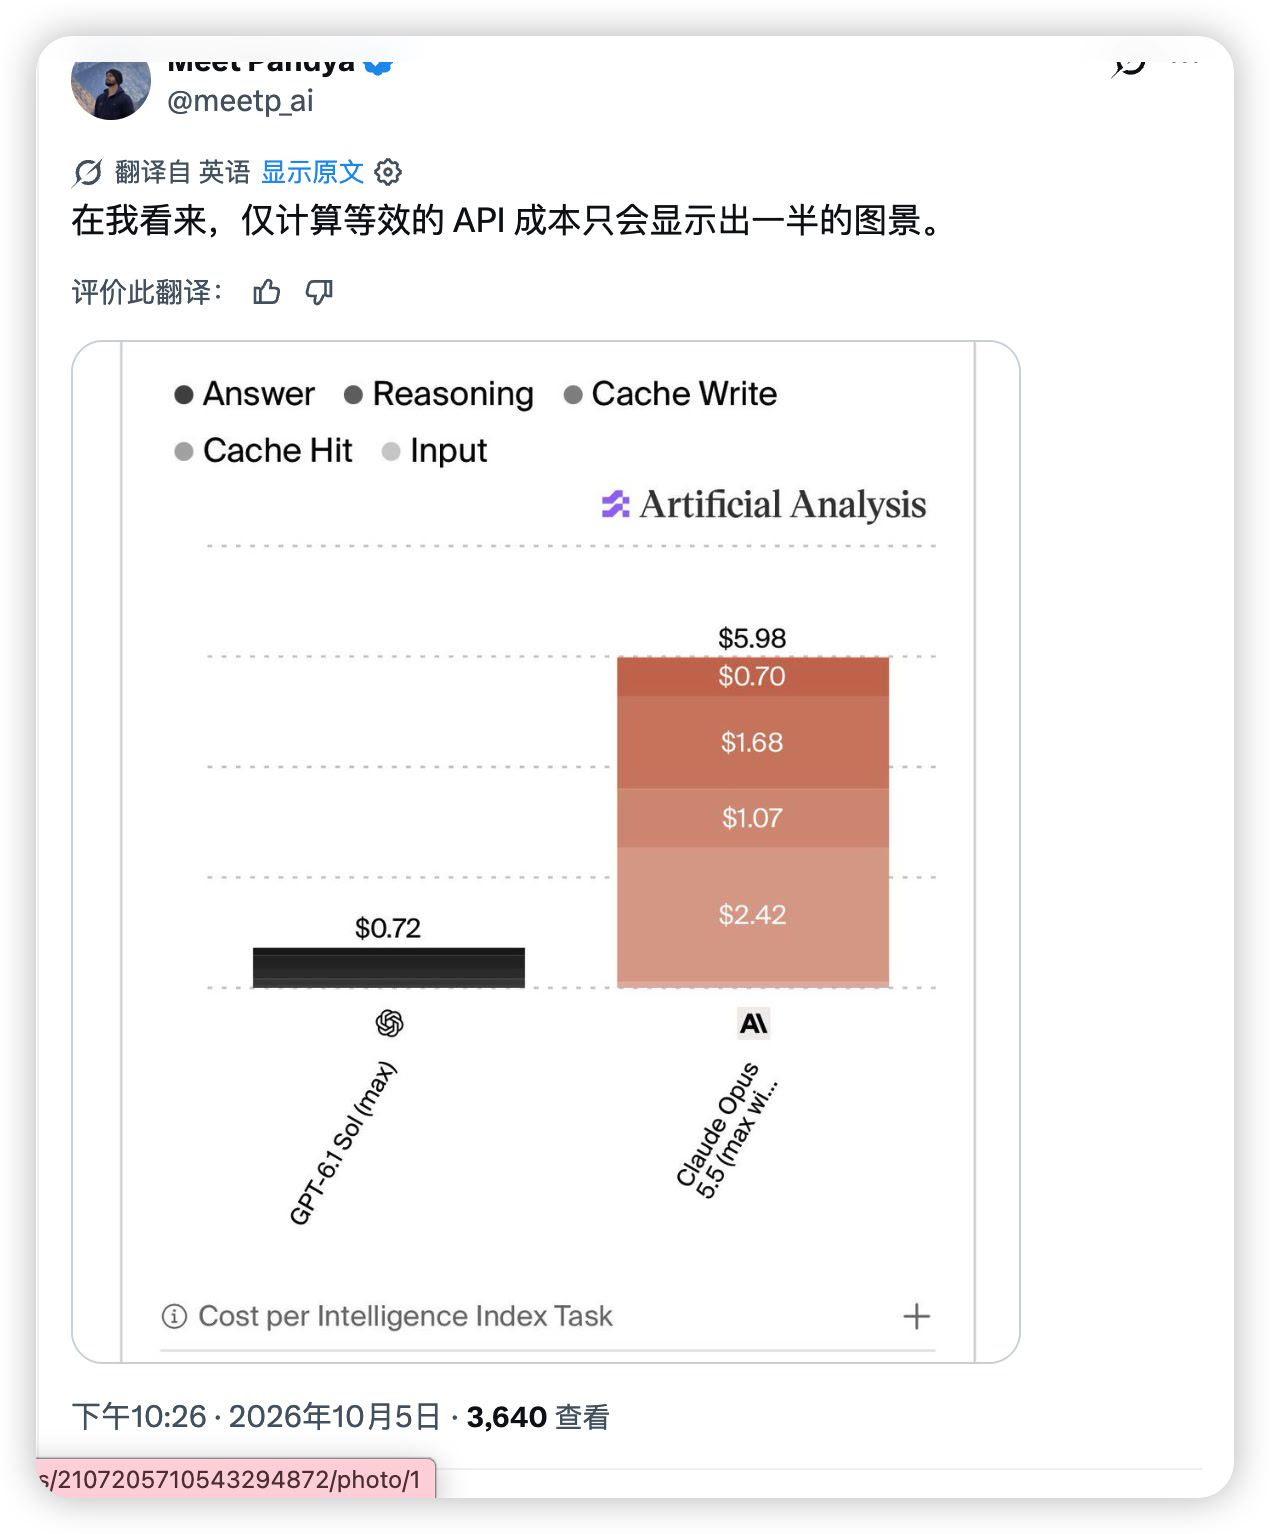
-
降额后的GPT VS Claude
-
老pro 200 (20x) vs 现pro 200 (10x)
-
老pro 200 (20x) vs 现在pro 500 (25x)
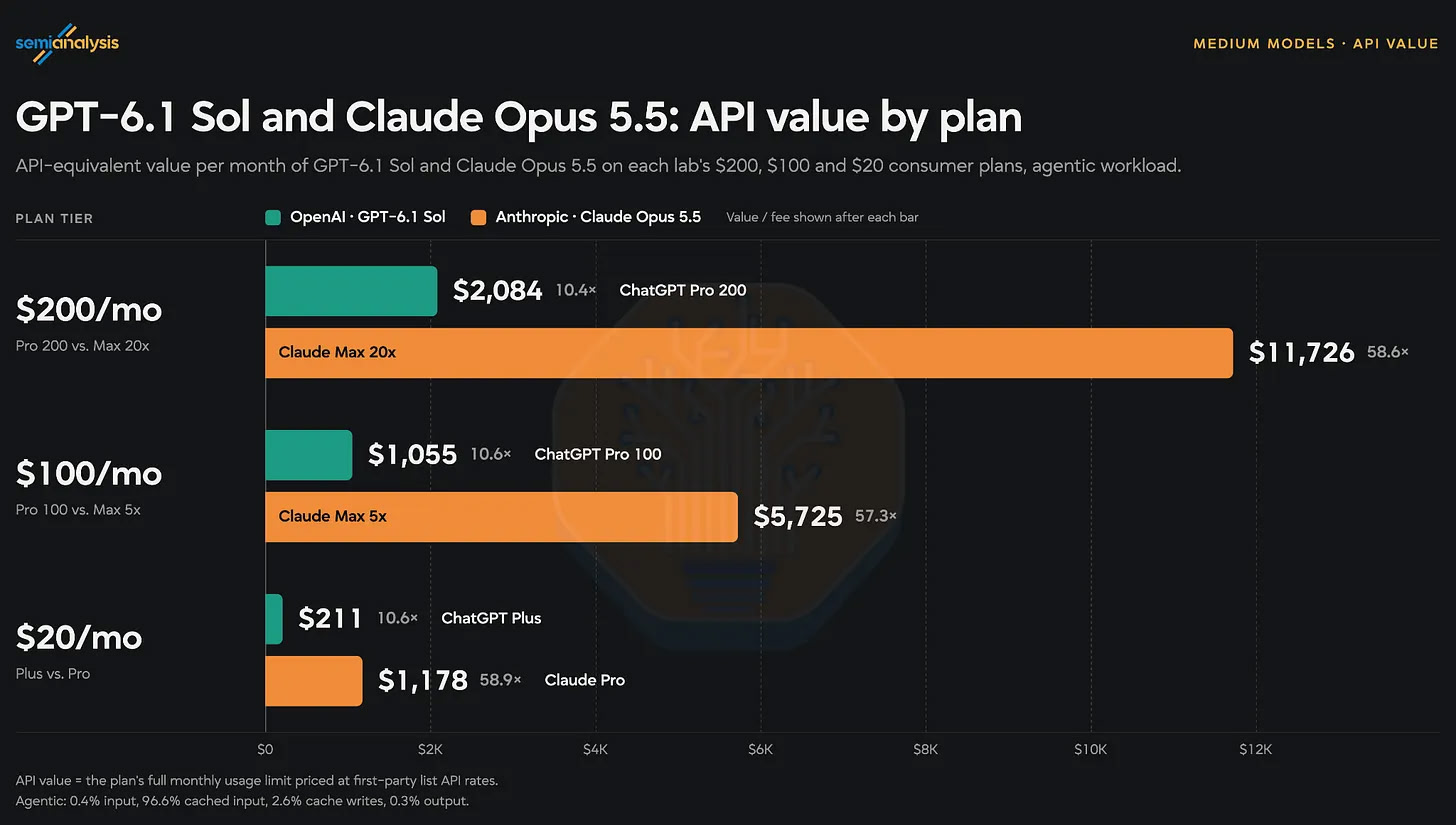
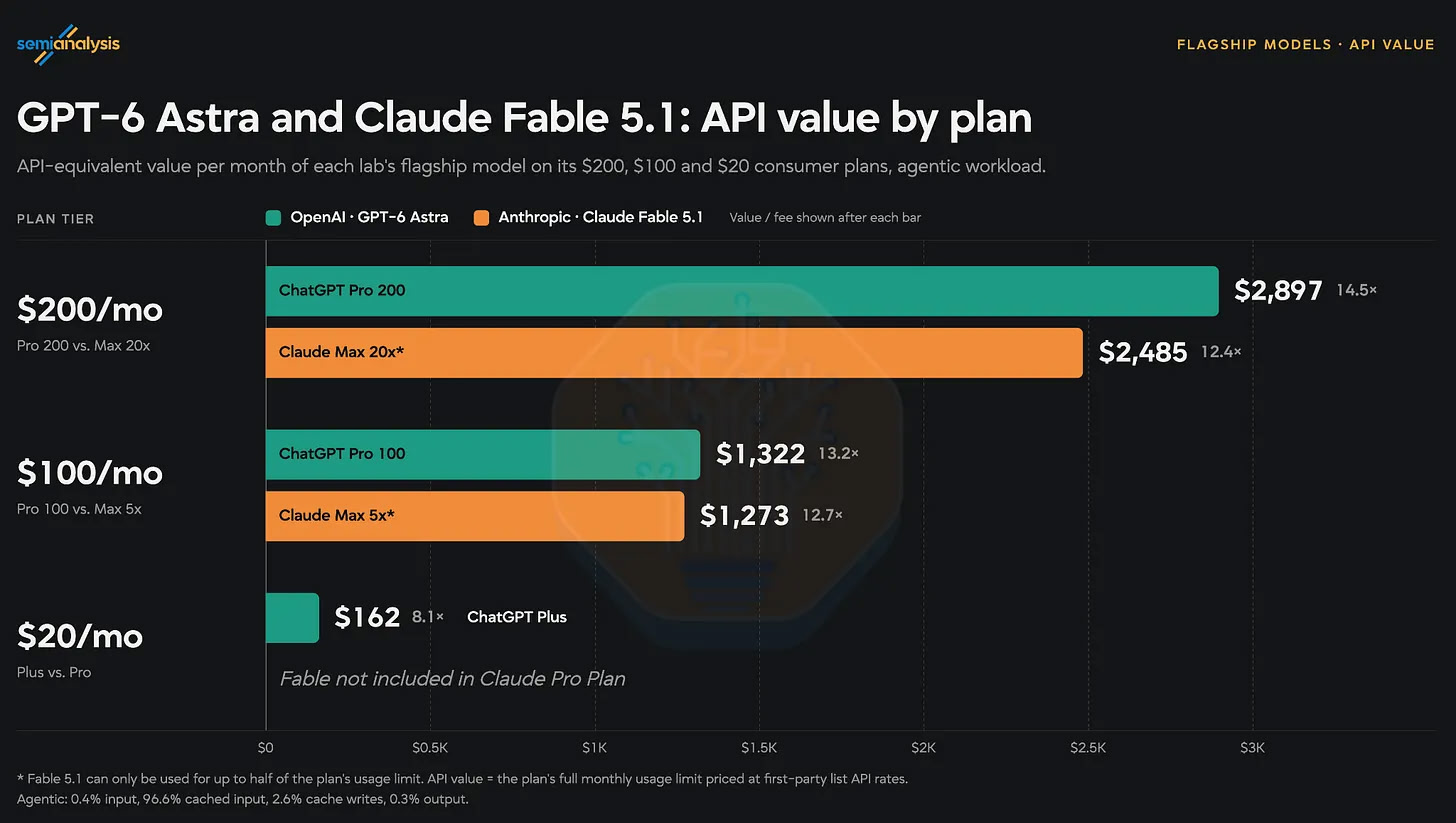
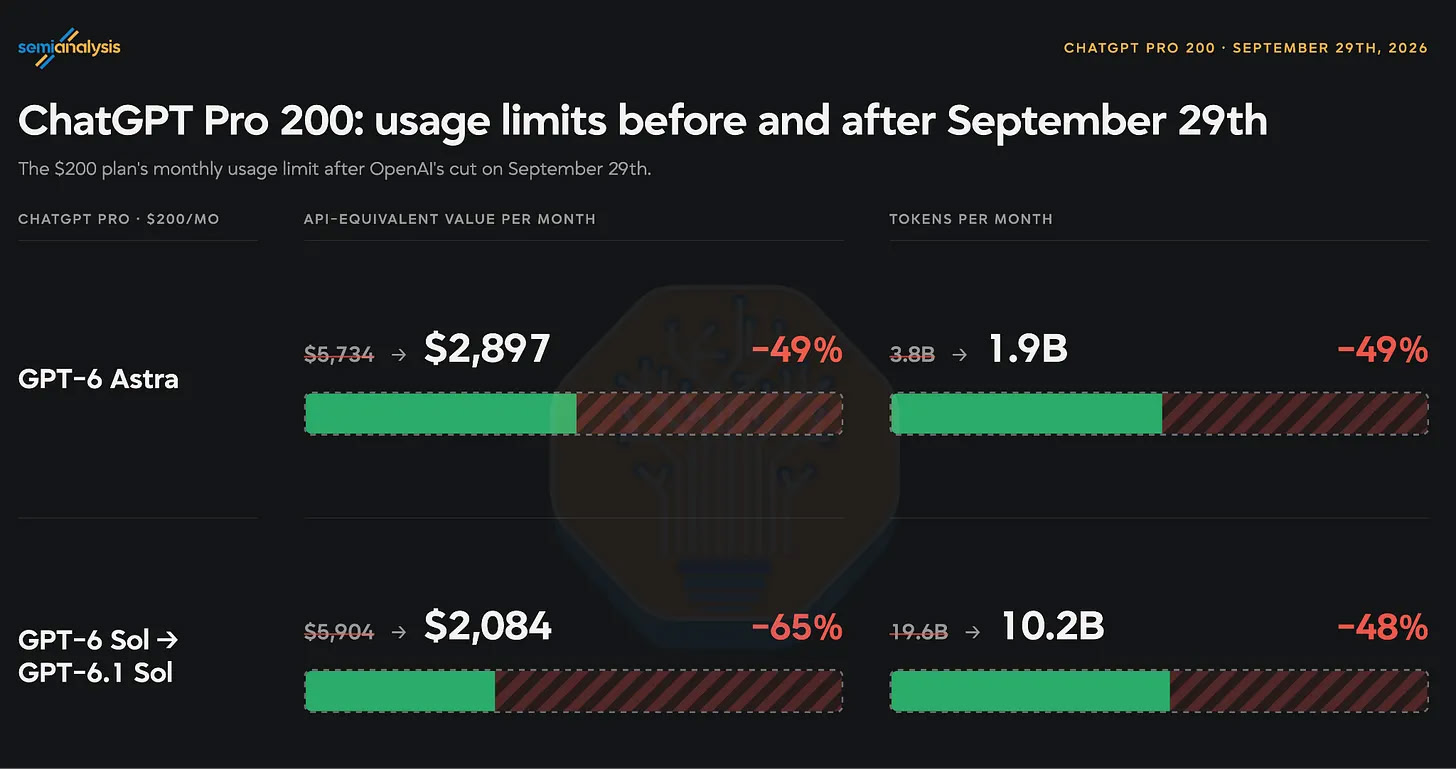

尴尬的是,就在今年6月10日,GPT订阅大概是Claude订阅的2倍
降额后的GPT VS Claude
老pro 200 (20x) vs 现pro 200 (10x)
老pro 200 (20x) vs 现在pro 500 (25x)
尴尬的是,就在今年6月10日,GPT订阅大概是Claude订阅的2倍
接下来的OpenAi
A. 装死不回应
B. 硬凹说自己token效率高
C. 继续Tibo的28天炒作计划
D. SemiAnalysis你们有尝试过购买多余额度吗
笑死我了,我能不能偷了去发帖
找到原文了!
You main Sol? And out of curiosity, you never buy credits?
我去,不行了,我要笑死了。这下还真是main Sol
看这图是5x的A/是最划算的囖?省事。
想起前几个星期都在感恩戴德重置卡就真的笑不出来
必须狠狠让大家认清O/的嘴脸,直接发 
3lue首偷,再偷必究
用不上A\,想用却用不上
就好像下定决心和女神表白,结果女神把微信拉黑了
O\则像绿茶婊,吊着你,敷衍你,不理你 
现在最搞笑的是我计算了一下,10月29以后就算我吧现在的20x换成两个5x我能做的事情比现在的20x还多。20x真的是不够用。Astra轻度工作(Medium,high,xhigh根据任务切换。对话中不切换强度)的一个下午都能用掉10%。。。
O/每次都这样,一有人讲不够用就搬Token efficiency说事
是啊,再说他这个token效率纯属硬挤,说什么就只做什么
说实话我个人感觉这个efficiency很大一部分来自OAI模型会背题。我很多次问leetcode的题目他想都不带想的。实际上真的只要不在数据集里面的题目该读的文件,该思考的不会少太多的。虽然OAI模型确实同样的工作输出更少(可以看最近几个paper透露的OAI的COT,确实很压缩)但是绝对没有AA的价格这么夸张。
确实有背题,感觉AA的评测也有很大问题,而且这人放出来的似乎是差距最大的?哈哈
AA的评测图一乐就完事。甚至不如B站那些斗蛐蛐。这玩意还是小马过河。开了个A/20刀的试用了一下opus,感觉A/模型更懂我的意图。我已经决定等20x变成10x以后换成双5x了。
狠狠羞辱openai,真是被惯坏了
Anthropic的模型真的太懂人类意图了,真有一种全心全意为用户服务,用户不说都为用户服务的感觉
是啊是啊,这就应该狠狠干它