Strata又有大动作了, 支持DeepseekV4.1-Flash了. ISTA也发布了GSQ-RCO版的1bit和2bit的deepseek模型了. 写的量化效果很好,损失非常小.
过几天大家调用的DeepseekV4.1-Flash 1017的API可能就是1bit量化的了.
这是Strata写的实测数据:
| PC | output | prompt |
|---|---|---|
| RTX 5070 12 GB, 64 GB RAM | about 5 tokens/s (code) | 231 tokens/s at 8K |
| RTX 3060 12 GB, 46 GB RAM | about 8 to 10 tokens/s (code 9.9, agent work 7.8) | 149 tokens/s at 8K |
| 1x Radeon AI PRO R9700 (AMD), IQ2_XS | about 11 tokens/s | not measured |
| 4x Radeon AI PRO R9700 (AMD) | about 31 tokens/s (55 to 69 with DSpark) | about 505 tokens/s at 8K, about 818 at 32K |
这是我在3090ti+32GB内存跑到数据:
解码8-14t/s. 预读400-500t/s.
没啥可以用性, 但可以拿来玩玩. 而且我看了,用消费级显卡, 瓶颈有很大一部分是CPU的内存控制器带宽, 现在普通台式机都是双通道DDR5, 上限不高. MTP层自己就8个多G, 显存不够没法开.
自己在家跑还是选Qwen3.8-flash-next吧, 刚出的Gyro的版本也很不错, 显卡计算压力大一些但同质量模型比GSQ-RCO的小
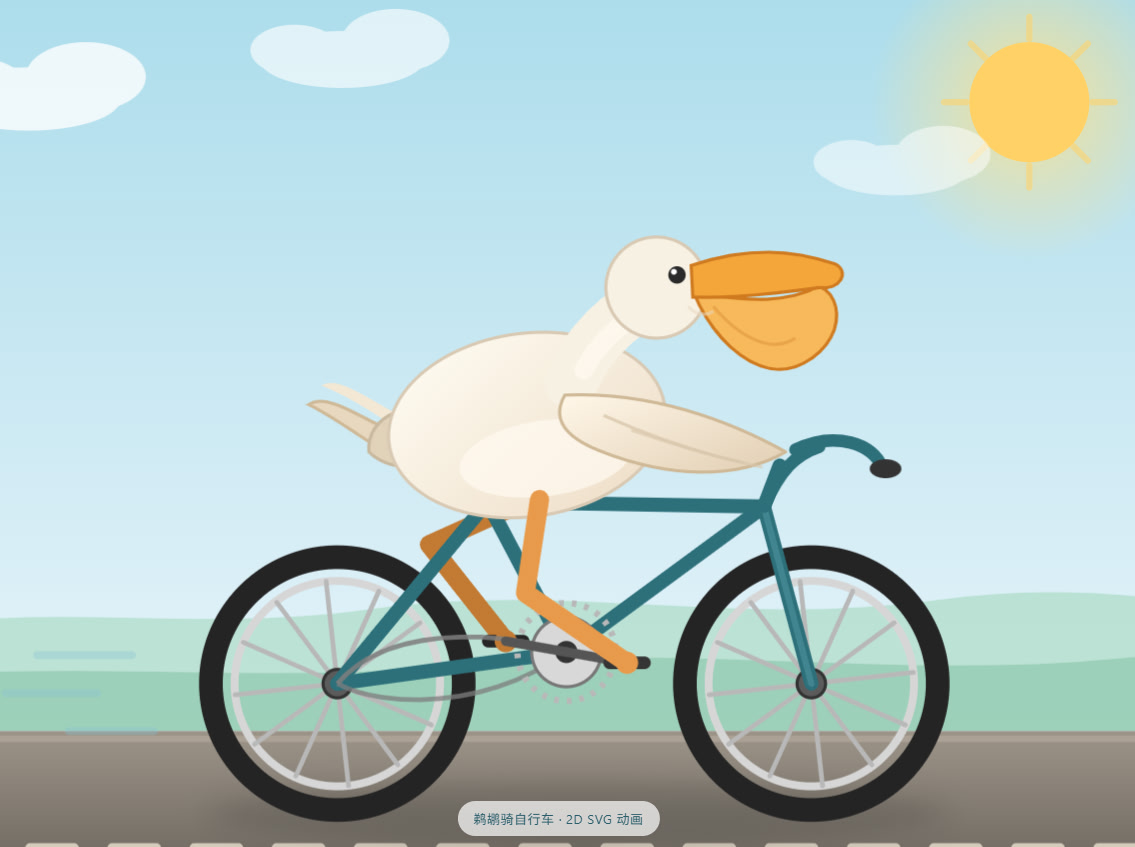
附一张画deepseek v4.1 flash IQ1_M (239GB) 的鹈鹕, 画了半个多小时, 动画是正确的.