我觉得一件事要做的比别人好,肯定要有资源和人才。但是a\和o\不止有大量的卡还有全世界的ai人才。实在是想不出要如何超过别人
9 个赞
梁文锋说不缺人才,缺卡。
21 个赞
缺卡不能自己造吗 现在华为已经造出来了
5 个赞
训练卡是要环境的cuda 现在训练模型还脱离不了这个,推理卡确实能造。
4 个赞
不能。看寒武纪,三季报不及预期,因为中芯没产能给它。国产卡放量至少到2028年。良率赶上台积电等2032年以后。
4 个赞
国产卡产能拉完了,ds新模型出不来有他的锅
8 个赞
人才从来不缺,甚至还会饱和化.
不要以个人英雄视角代入ai发展,从来没有说一个人改表了一个工程结果这样,推出来的都只是团队代表,而且这个人的作用更多是管理推进项目作用,并非纯技术.
算力相比重要多了,就跟盖房的地基一样,决定了最高能盖多少层楼.
算力都在平行往好了发展,可以说是跟时间赛跑了
1 个赞
我一直说,现代科技比的就两个东西,廉价资金募集能力,和高密度人才组织效率。这两点不管你承不承认,都比不过 老美的oa。 那么短时间内除非看到其他的竞争优势, 不然保证不掉队就很了不起了。
2 个赞
国内人才可不缺,甚至可以说比美国还好质量还高的,AI这块主要还是华人发力,而美国现在由于地缘政治的因素,对华人移民实在是不友好,华人大佬是一定会斟酌政治风险这块的。
国内现在短期风险是缺卡,长期风险是RSI落后,因为这个东西本质上可以抽象成两个要素,人力资本(人才)和实物资本(卡),一旦RSI能够真正跑通,国外的人才落后差距就会被AI自己迅速追平。
但是反过来也是一样,如果在国内把训练卡给赶上之前,RSI的链路没有跑通,那国内追上完全只是时间问题,你想想,但凡中国有人有卡,几乎不存在落后的可能性。
5 个赞
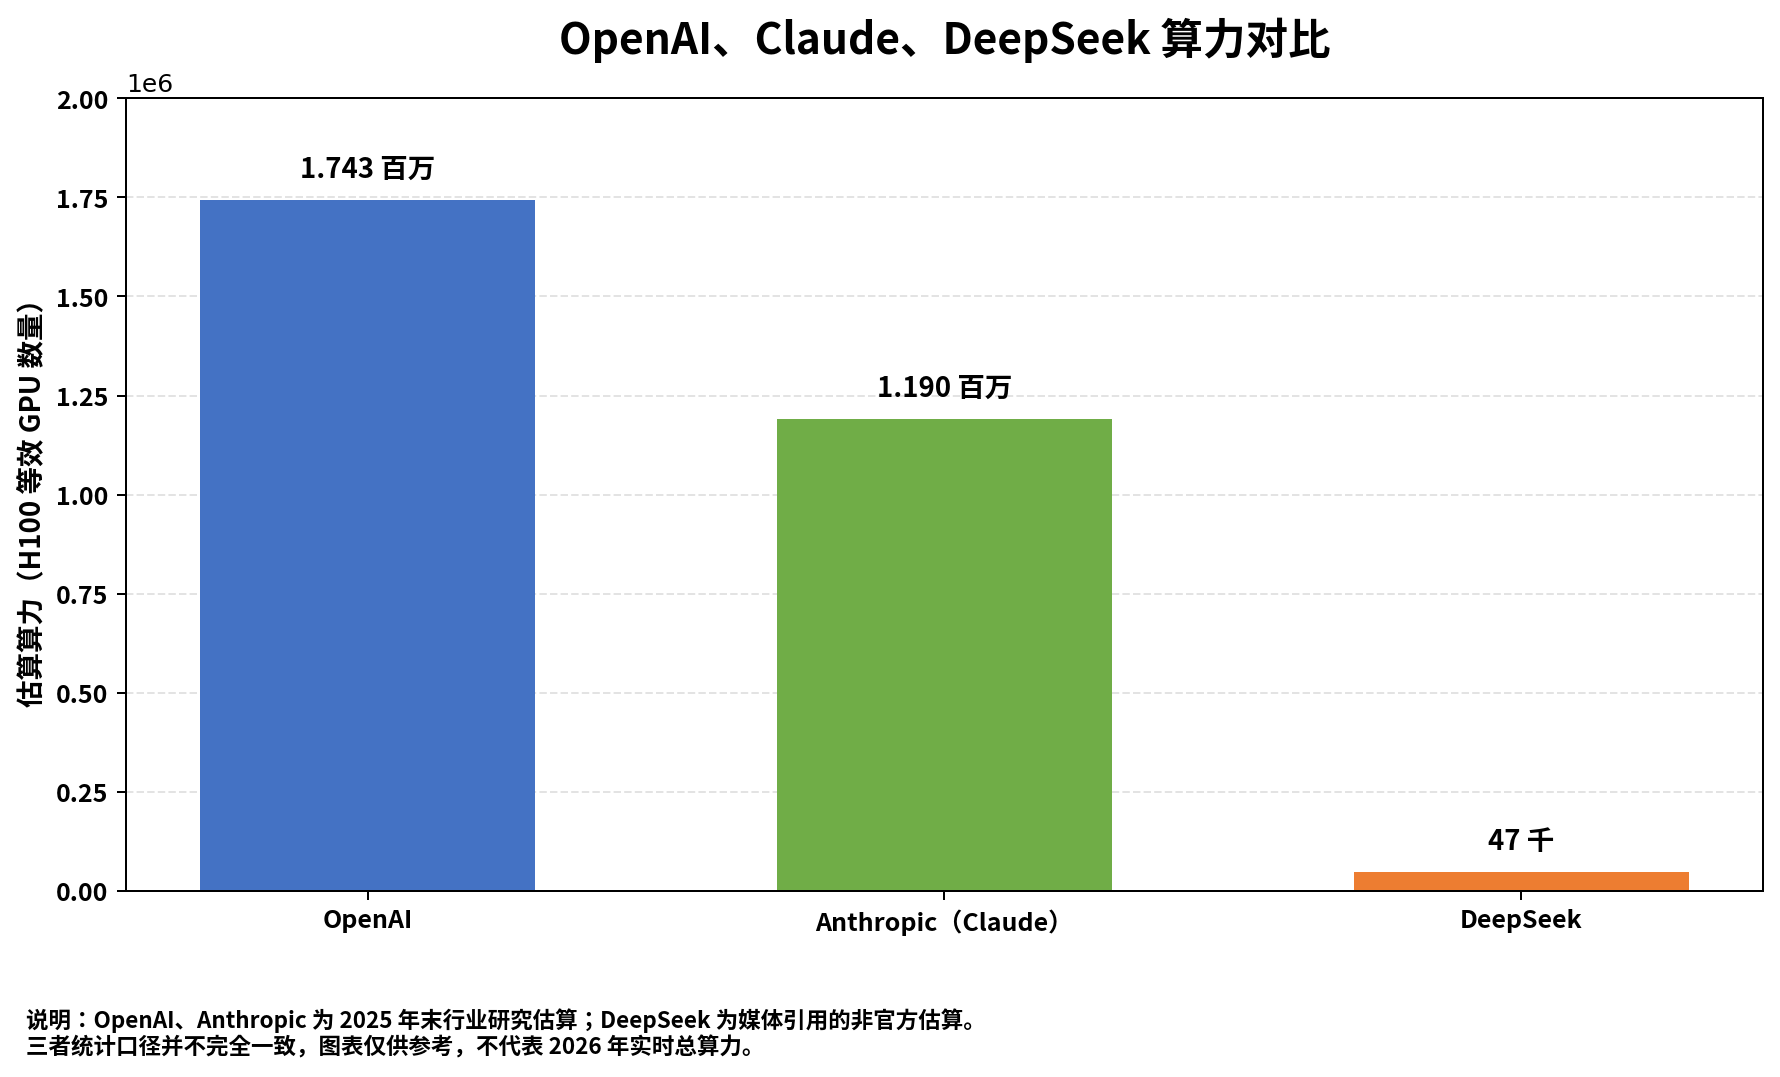
然后卡这个东西,OA两家的模型很大,这是非常非常高的门槛,卡这个东西是有I/O Bound的,不是说我现在训练了1个1T的模型,我要训练一个2T的,卡翻一倍就可以,实际上可能是翻3-5倍,我要训练1个4T的模型,在技术不迭代的情况下,甚至可能无论翻多少倍算力,永远都训练不出来,有句话叫More is different,算力这个东西不是堆上去就能解决问题的
9 个赞
openai 这么多算力居然还打不过Claude
要cos天涯神贴么. 中国何时超过日本.
12 个赞
能保持追赶就已经很厉害了。
主要还是缺卡,由于缺,导致大参数模型越难训练,最终价格也很难比OA便宜。
国模总不能一直在flash模型吧,想和OA竞争,最终参数量还是要上来
但是在大参数模型上,感觉国模还是处于一个探索阶段 
2 个赞
看到一个帖子,deepseek就是斩杀线,比dp差的滚出去
我个人认为,O和A现在手里的模型不是最新的,至少是领先几代的,但是国内是研究出来啥发啥
所以就是一种追脚后跟的
人才和算力都提上去才有可能超越
这个图要是数据保真的话,那 Deepseek 要是有同量的卡,那不得把GPT和a 吊起来抽啊?
1 个赞
不用超过一直追赶就行了
哪怕落后个1年 1年之后国模就会有astra 6和opus 5.5的水平就很不错了
用户量也相差很多吧 之前O那边用户量没那么多的时候一下就追上去了
保持当前势头是不可能超过的
所以目前只能努力吊着,不要被甩开太多,等他们烧钱烧不动了,才能有机会
这也不算什么丧气话,英伟达和台积电这两座大山还是太难翻了
反正这条赛道上就两个选手,慢慢跟着呗,也没其他人进场竞争
又不是像核武器那样不弄出来就肯定会受制于人,所以才不惜代价倾国之力去搞,大模型按照目前的落地情况来看,不用急
5 个赞