[!quote]+
我们在持续学习(Continual Learning)中引入了“睡眠”阶段,使大型语言模型(LLM)能够在持续整合新知识并增强推理能力的同时,缓解“灾难性遗忘”或因知识截止日期导致的静态知识局限。
现代大语言模型通过预训练和上下文学习(In-Context Learning, ICL)展现出了卓越的性能。然而,模型一旦部署,其状态往往趋于静态——受限于固定的知识截止日期,它们无法获取长期能力,也难以适应新信息。
虽然利用新数据更新模型看似是显而易见的解决方案,但持续更新参数往往会引发“灾难性遗忘”——即在学习新任务时,模型在先前已掌握任务上的性能会严重下降。另一方面,若仅依赖上下文学习(ICL),知识的留存将受限于当前的上下文窗口:一旦会话结束,所获取的短期信息便会随之丢失。
受人类大脑在休息期间处理并稳固记忆这一机制的启发,我们在持续学习中引入了一种“睡眠”框架。该学习范式赋予大语言模型(LLM)一个持续的周期性生命周期,使其能够不断学习,并将脆弱的短期上下文信息转化为稳固的长期参数。通过这一框架,我们证明了在“主动交互”与“离线记忆巩固”之间进行交替,能够让大语言模型持续获取新知识,保留长达 1000 万(10M)token 的长上下文知识,并提升其复杂推理能力。
[!quote]+ 重新思考机器学习:活跃(清醒)阶段与睡眠阶段
传统的机器学习依赖于训练和推理之间的严格界限。而在持续学习(continual learning)框架下,这种区分显得有些人为——智能体必须不断地学习、适应并处理信息。
在“睡眠”范式下,大语言模型(LLM)在两种主要状态之间切换:
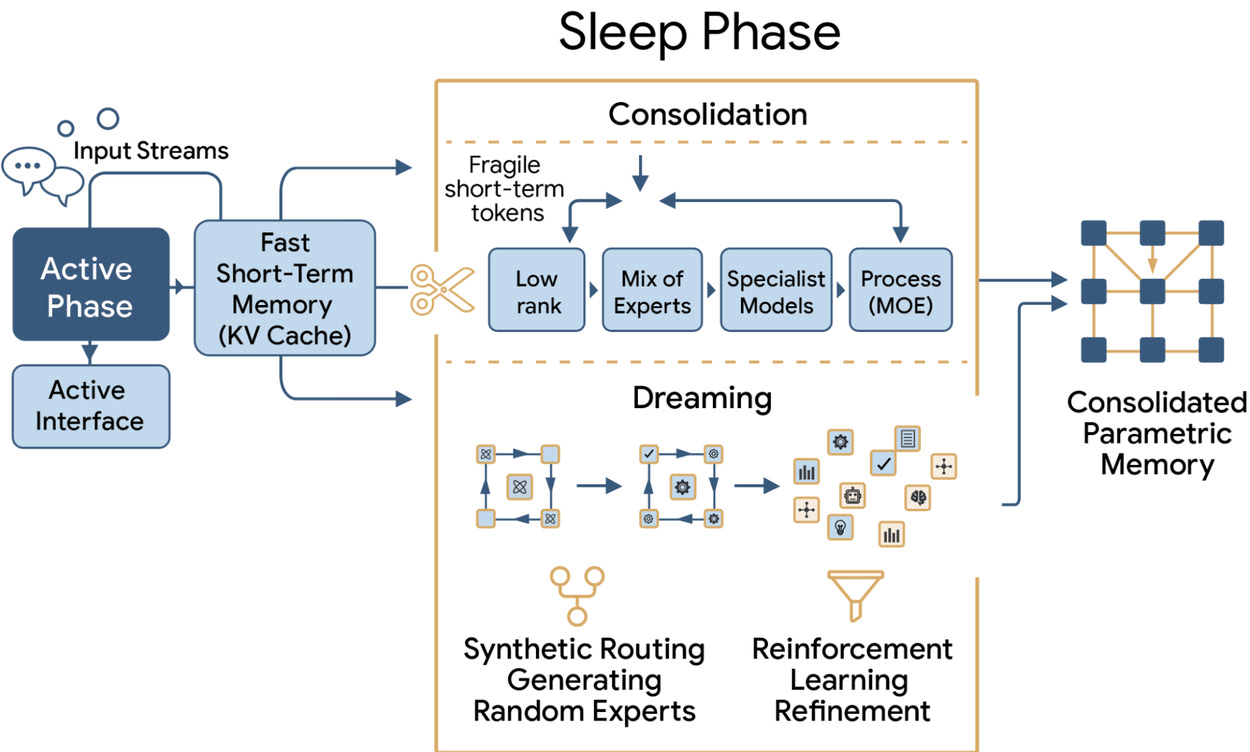
- 活跃(清醒)阶段:模型主动接收、处理输入信息并与之交互,同时将临时信息存储在快速的短期记忆组件中。
- 睡眠阶段:模型暂停处理新的输入,转而将内部计算资源用于记忆巩固和自我提升。
尽管“睡眠”、“做梦”和“自我提升”等术语借用了神经科学的概念,但我们的框架完全是在固定的模型架构和人类设定的训练规则内运作的。在离线睡眠阶段,模型会启用预先分配的“专家混合”(Mixture-of-Experts, MoE)记忆模块,并利用自身生成的练习样本来更新数值权重。这种自动化的“训练后”循环,使已部署的模型能够在保持核心代码库和设计不变的前提下,吸收新知识并提高推理的准确性。
[!quote]+睡眠过程的关键组成部分
睡眠范式通过“记忆巩固”和“做梦”这两个阶段,来解决“灾难性遗忘”问题并实现持续适应。
1. 记忆巩固
在人脑中,非快速眼动 (NREM) 慢波睡眠通过抽象和提炼,将脆弱的记忆转化为长期存储结构。我们提出的睡眠框架通过以下两种关键技术机制,模拟了这一自然现象:
- 参数扩展与连续记忆层级: 为了防止灾难性遗忘,模型会在睡眠期间动态调整其容量。通过采用专家混合 (MoE) 和 Hope 架构,新激活的低秩(low-rank)专家被整合进稳定且更新频率较低的记忆模块中;这样既能存储新知识,又不会干扰原有的参数。
- 知识播种(向上提炼): 存储在高频层(例如“上下文记忆”)中的脆弱短期记忆,会被迁移至新扩展的长期参数中。这一过程通过广义知识蒸馏 (GKD) 结合基于强化学习 (RL) 的模仿学习来实现:
- 同策略蒸馏 (On-policy distillation): 扩展后的“学生模型”会根据“教师模型”在自采样序列上生成的分布,学习针对特定 Token 的反馈。
- 学会模仿 (Learning to Imitate, LTI): 当学生模型补全由教师模型生成的文本前缀时,系统会根据其语义相似度和绝对相似度(通过莱文斯坦距离衡量)给予奖励。 * 突触修剪: 一旦记忆巩固至低频模块的过程完成,高频的临时参数便会被重置,从而为后续的活跃会话腾出容量。
2. 通过“做梦”实现自我提升
在快速眼动(REM)睡眠期间,人脑会主动模拟各种情境,巩固情感与语义之间的联系,并探索全新的神经通路。与之类似,在“做梦阶段”,该睡眠框架构建了一个自主的自我提升循环:
- 随机专家选择: 在合成数据生成过程中,混合专家模型(MoE)的路由机制会随机激活非典型的专家单元。这迫使模型融合不同领域的知识,从而发掘出潜在的模式。
- 精选式演练: 模型生成合成训练样本(即“梦境”),并通过基于梯度的筛选机制进行过滤,优先保留那些最有助于提升模型整体能力的样本。
- 强化学习(RL)优化: 模型针对筛选出的优质“梦境”样本进行监督微调,并评估这些生成内容是否确实提升了模型在下游任务中的表现。
[!quote]+ 理论基础
除了实证结果之外,我们的“睡眠”范式还有一套理论支撑。该理论阐明了为何其包含的两个阶段(记忆巩固与“做梦”)能够支持持续学习,且无需以牺牲旧有能力为代价来换取新知识。在记忆巩固方面,分析表明“知识植入”(knowledge seeding)可被理解为一个结构化的低秩压缩问题。模型无需将其短期记忆痕迹中的每一个细节都复制到参数中,而是从中提取出一组精简的“方向”——这些方向既能最大限度地保留模型在实际推理时的行为模式(即“在策略”行为),又能维持学习目标所奖励的语义特质。
这一视角解释了两种信号的互补作用:基于“在策略”的蒸馏(on-policy distillation)确保了记忆巩固与模型在推理阶段实际产生的行为轨迹相一致,从而减少了仅依赖“教师模型”生成的数据分布进行训练时可能出现的偏差;与此同时,语义奖励机制界定了哪些内容值得保留——它优先保留那些承载语义内涵及与任务相关行为的方向,而非仅仅追求对标记(token)概率的简单匹配。随后,参数扩展机制提供了必要的容量,使得这些被选定的记忆能够被写入模型,且不会覆盖掉先前已巩固的知识。
在“做梦”阶段,该理论将“随机专家激活”(random expert activation)与“基于奖励的样本筛选”视为改善学习几何结构的机制。引入不同的专家混合(MoE)模块,拓宽了合成生成过程中所探索的梯度方向范围,使模型能够接触到比仅在常规“清醒”状态下处理数据时更为丰富的更新信息。随后,基于梯度的筛选机制会突出那些蕴含最有效学习信号的合成经验,在强化关键学习方向的同时,保持底层梯度空间的结构完整性。
综合来看,这些步骤构建了一个更为均衡的优化环境:学习过程不再被少数几个方向所主导,梯度条件(gradient conditioning)得到了优化,模型在精进自身能力时也能取得更稳健的进展。从这一视角来看,“做梦”并非仅仅是简单的“自生成数据增强”;它是一个经过精心设计的流程,旨在通过多样化、筛选和巩固更新信息,助力模型实现自我提升。
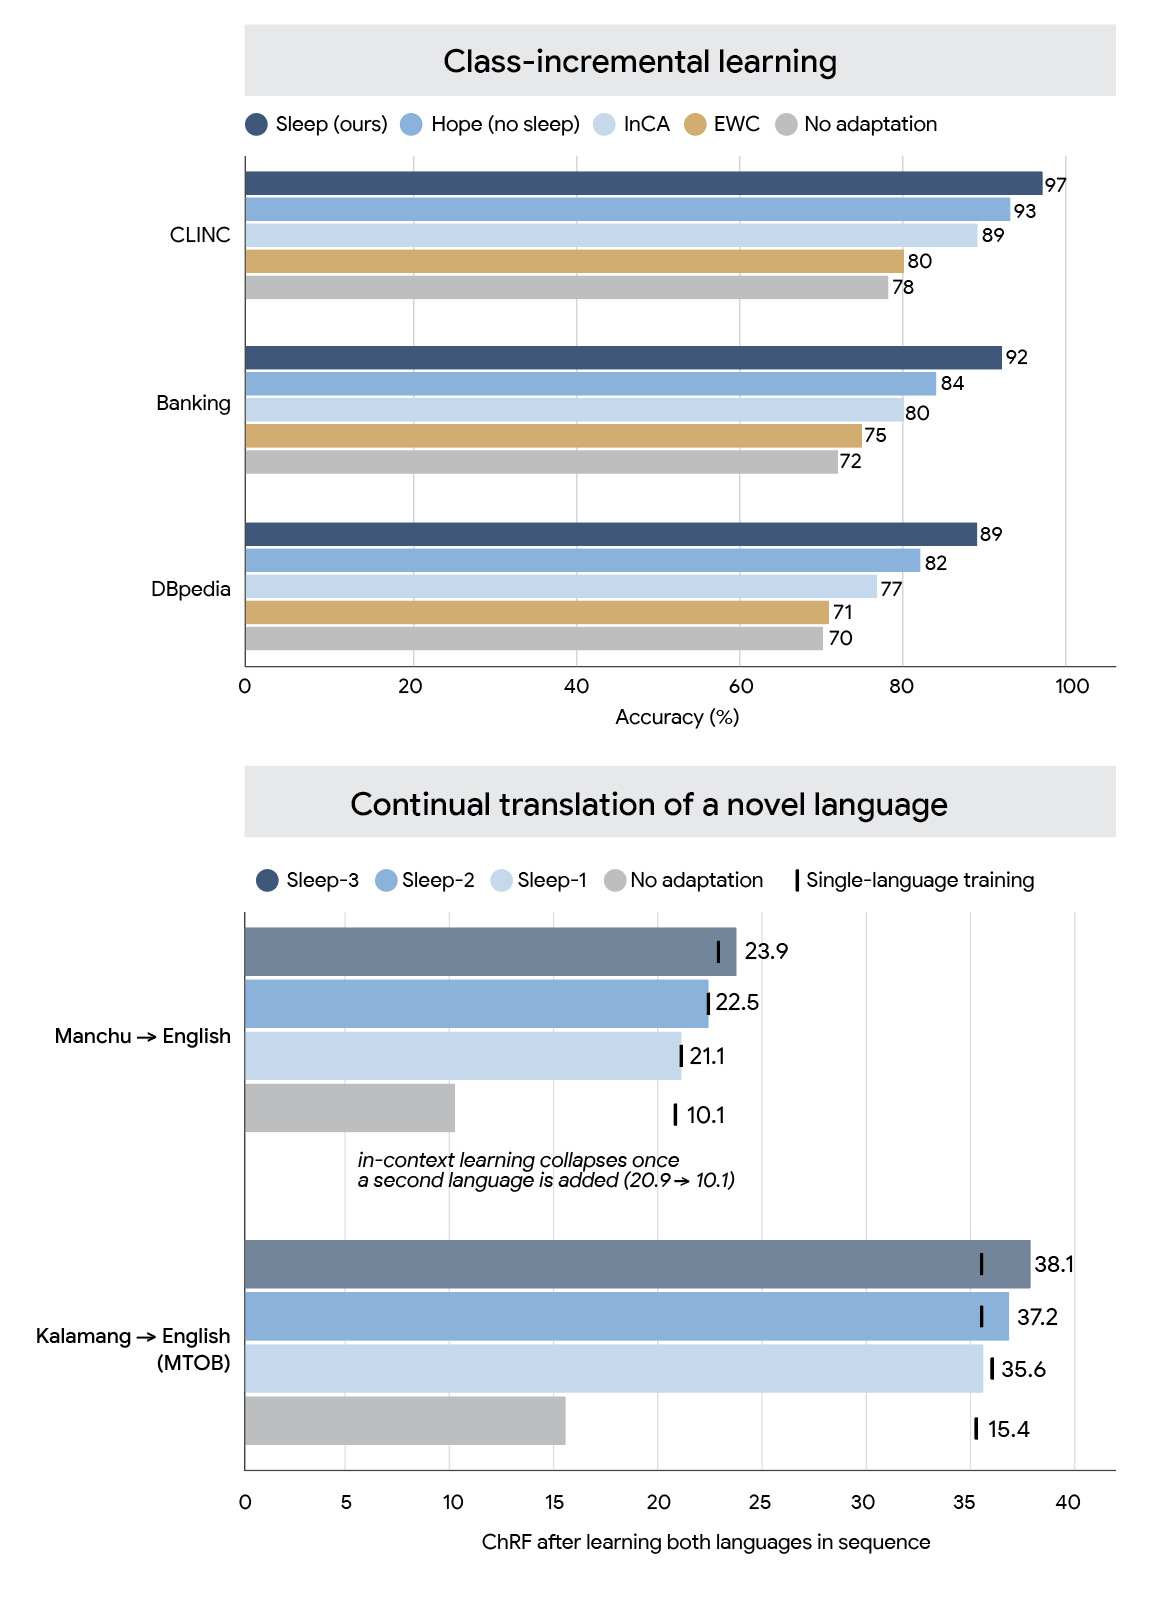
在针对满语(Manchu)和卡拉曼语(Kalamang)等未见语言的“持续翻译”(continual translation)任务中,我们的“睡眠”(sleep)框架在多阶段评估中实现了近乎零的性能下降;相比之下,ICL、“Cartridges”以及“监督微调”(SFT)等标准基线方法在顺序学习过程中均出现了严重的“灾难性遗忘”(catastrophic forgetting)。
在基于 BABILong 基准的长上下文理解任务中,我们的“睡眠”方法展现出了近乎完美的扩展能力,支持处理长达 1000 万(10M)token 的上下文。该方法通过“睡眠期巩固”(sleep-time consolidation)机制,将长上下文信息直接压缩至参数化记忆(parametric memory)中,其表现优于 GPT-4 和 Titans 等强劲的基线模型。
在基于 SQuAD 基准的事实知识整合及“持续预训练”(CPT)任务中,我们的“睡眠”方法在单任务评估中取得了 48.9% 的成绩,在 CPT 评估中取得了 46.2% 的成绩。该方法能够成功整合新的事实信息,且不会损害模型原有的表征,其表现优于基础模型、SFT 以及“自适应语言模型”(SEAL)等基线方法。最后,在包括 AIME 24/25 和 HMMT 25 在内的数学推理基准测试中,经过“睡眠”增强的基础模型分别取得了 79.2%、69.0% 和 46.1% 的准确率。这一表现优于 SFT(监督微调)、组相对策略优化(GRPO)以及同策略自蒸馏(OPSD)等基线方法,表明将“记忆巩固”与“模仿学习”相结合,能够带来更出色的推理性能。
[!quote]+ 结论
我们提出的“睡眠”范式为实现自主且持续学习的人工智能系统开辟了路径。通过摆脱静态预训练和脆弱的上下文窗口限制,让模型在“主动学习”与“离线休息”状态之间交替切换,大语言模型(LLM)不仅能够保留短期记忆,还能将新习得的技能抽象并转化为长期的参数结构,从而在避免“灾难性遗忘”的同时实现持续的自我提升。