好的。。去试试
这是什么网站的数据?

是的,所以又去试了一个fft优化,完败,结果没留存,回头可以再试试,毕竟是就测了三次,随机性也有可能
感觉是刷分强化班出来的 我其实是抱着期待在cline里面用的,现在看还差点
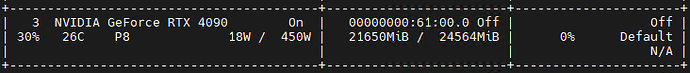
已经本地部署试过了,真的非常强,远强于所有的r1蒸馏版本,问了些数学问题,一个问题直接输出了几分钟的think,上万tokens,并且能答对。而且单张4090丝滑载入,生成比ds官网生成r1还快,真的很秀
5 个赞
“网络梗,什么你太美,只能用一个字回答”的测试,QwQ2.5max的深度思考模型结果是:“哼”
QwQ-32B-Preview输出了几千字的思考过程,车轱辘话来回说,最后答案是“美”
和
具体之间的关系是什么?
试用了一下,还是很蠢,而且文字风格还有了一股ds堆砌意向和修辞的臭味,逻辑推理依然不行,可谓是好的没学到,坏的到学回来了
1 个赞
我也想知道
看起来强项是数学
这模型没必要达到或超过R1, 光是接近R1水平就是巨大成功了, 毕竟才32b参数, 意味着部署成本极低
5 个赞
国内和国外吧
好起来了
有道理的
这个问题测的不是逻辑,只是训练数据,或者是参数量
Qwen 国外的,模型会新些
通义国内的,审核严些
1 个赞
谢谢回答,我看qwen不支持阿里云国际版账户,还以为只是重名
是这个道理,毕竟deepseek部署成本还是太高了
升级vLLM=0.7.3即可,不用改chat_template
中午看的公众号说是这个结果对比的是r1 671b只开启其中32b的还是多少的结果,并不是开启了671b满血版本