
9 Likes
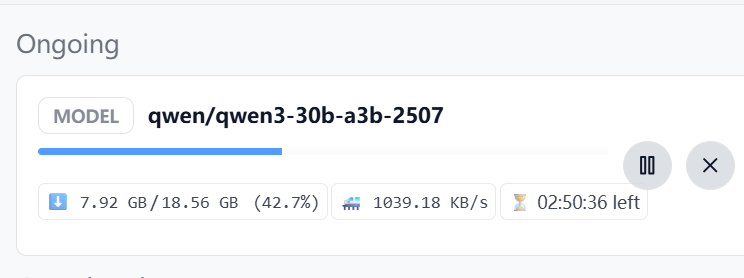
这是本地24G显卡,能运行的最好模型了.
前几天的2507 no-thinking版本,还是差了一点.
1 Like
佬没用梯子或者镜像么,怎么下这么慢
下载试试,我这个集显的看能跑动不
我上午试的是ollama官方发布的4bit量化模型, 能100% GPU, 推理速度飞快. 才3B激活参数.
哈哈哈,一个 chat,一个 code
等下再下来,试试。我这个U9 285H 没有独显的看多少token/s
我也试的这个,意料之中的不怎么好用
qwen不会将4月发布的模型全都更新一遍吧
很有可能
不过qwen-max倒是一直没更新 都半年多了 理论上应该有个超大的开源模型作为基础的
1 Like
感觉他家商业模型不咋更新,或者更新了不说
都是跟着开源模型一起更新的 只是max好久没更新了
1 Like
thinking模型ollama官方还没上线,楼主这个比较好用.
我现在已经用这个替换原来的qwen2.5:14b来翻译了,飞快!
4bit量化,权重精度下降太严重了
ollama run qwen3:30b-a3b-instruct-2507-q4_K_M
佬~ollama官网这个30b-a3b好像不是tingking-2507吧,我看官方还没出呢
是的, thinking还需要等等, 30b-a3b-instruct-2507-q4_K_M这个模型我个人测试下来, 不算太好用.
