在互联网冲浪时,我们会经常看到带有 hash 的文件名,例如:
app.9f8e7d.js
style.a13c22.css
audio-20240201-7c91bf.mp3
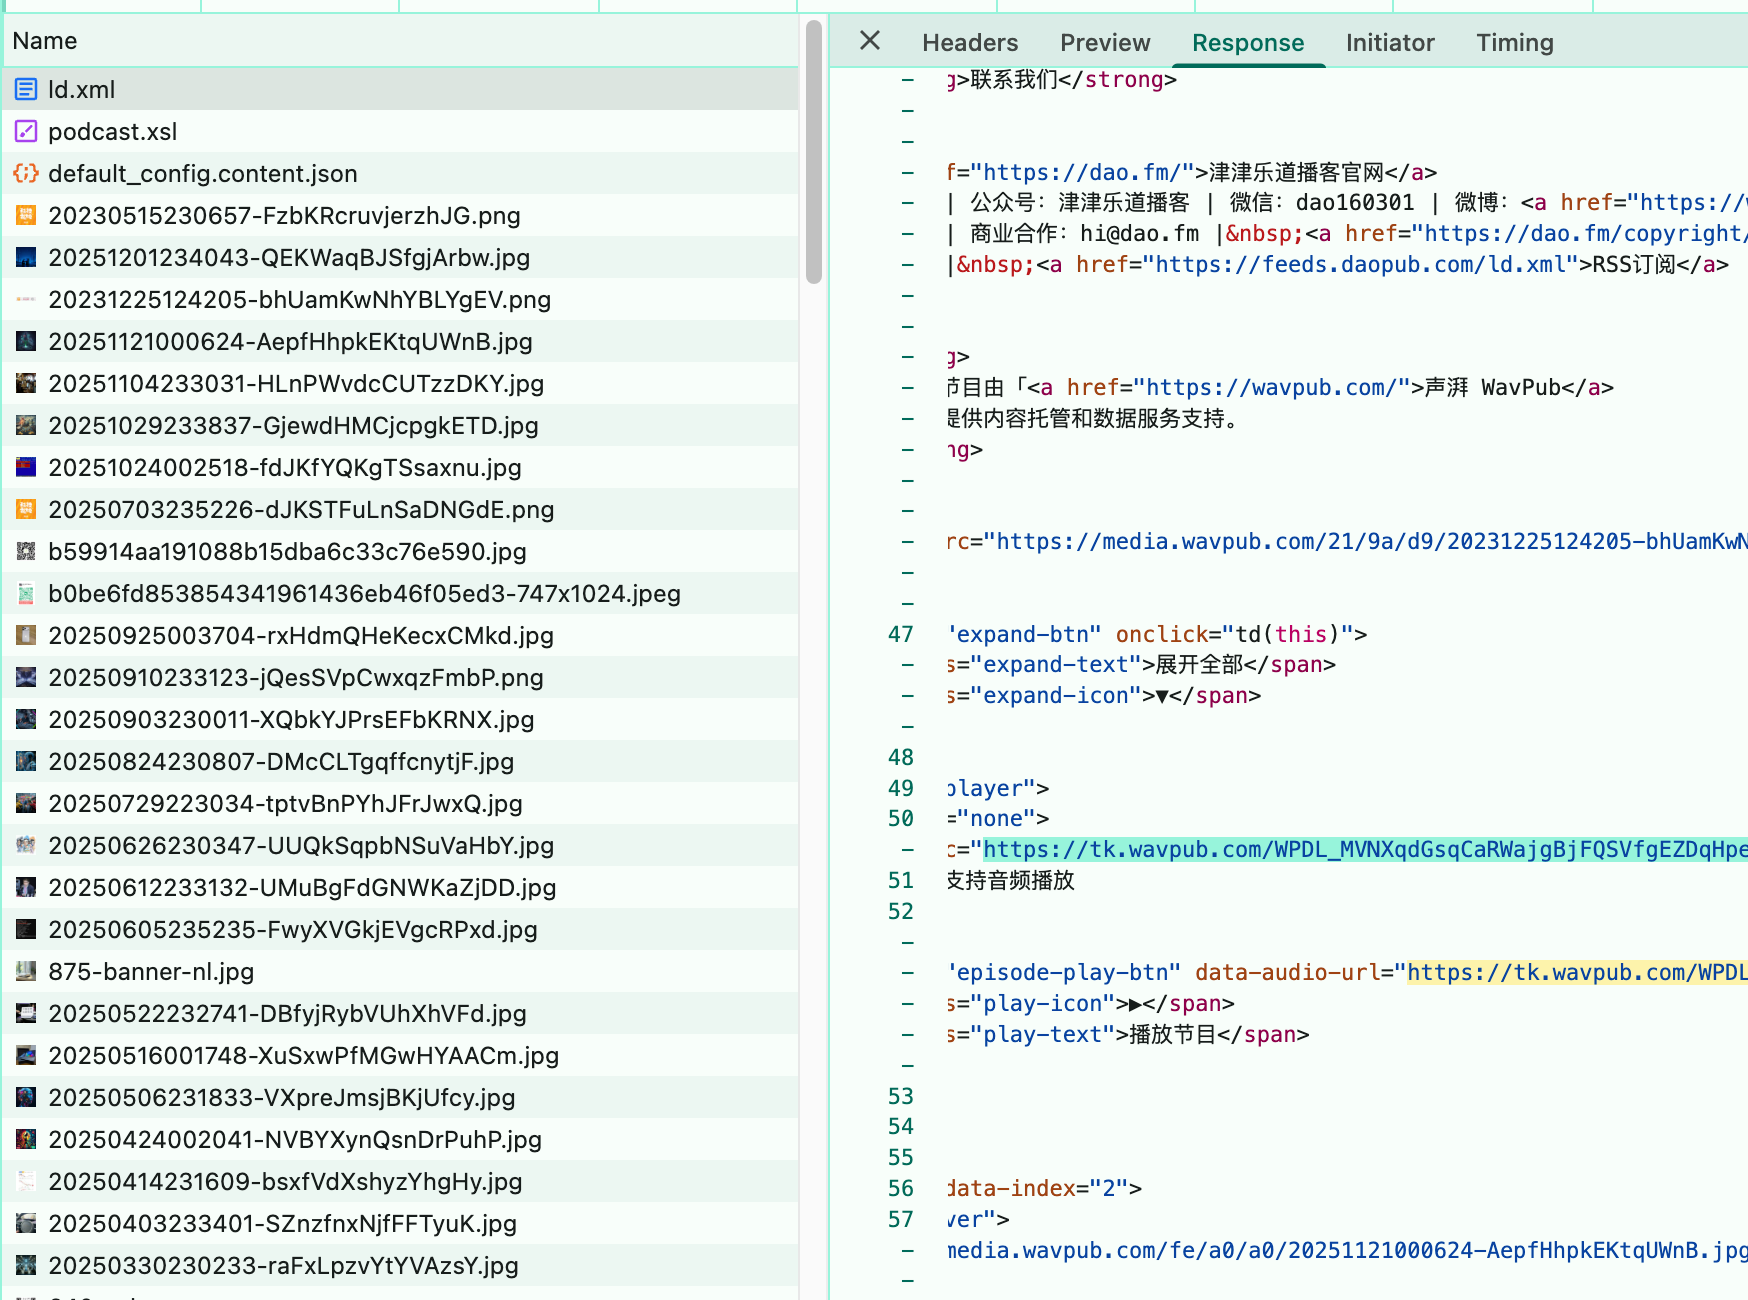
表面上只是多了几位随机字符,但它却是很少公开讨论的开发经验:
让系统能够可靠、准确地获取文件的最新版本。
为什么需要这样做?在我的认知里有三层影响因素。
一、缓存系统
浏览器、代理服务器、CDN 都遵循相同的缓存行为:
URL 不变,就认为文件没有变化。
例如,你更新了一个脚本:
script.js // 更新了一些内容但是文件名不变
但如果仍然使用同样的文件名,客户端通常会:
- 继续使用本地缓存
- 不重新请求服务器
- 即使请求,也可能被中间 CDN 返回旧版本
这一行为完全符合 HTTP 标准,但对开发者而言会造成版本错乱。
因此,一个最直接且可靠的方式是:
将文件内容的 hash 值写入文件名,使 URL 与内容强绑定。
当文件内容变更时,hash 自然会变化,URL 随之变化,
所有缓存系统都会立刻识别为“全新资源”。
二、hash 是“最稳定的版本编号”
你当然可以手动给文件加时间戳或版本号,例如:
script_v2.js
script_20240201.js
但这些方式的问题是依赖人工维护,在自动化构建体系中不够稳健。
相比之下,“内容 hash”具备天然优势:
- 内容相同 → hash 不变
- 内容改变 → hash 自动变化
- 构建工具可以自动生成
- 不依赖人工操作
- 兼容所有缓存策略
因此,包含 hash 的文件名是一种确定性版本管理,具有可重复构建的特性。
其实如果大家玩 NAS 会发现在同步一些网盘文件时,会频繁发生删除动作,本质上也是网盘内部的文件 hash 值变更导致的误判。
三、在中国网络环境中的一个特殊原因
除了常规的浏览器、CDN 缓存外,中国网络环境里还存在一种历史遗留机制:
部分运营商早期部署的透明缓存
这种缓存系统有一个典型特征:
- 不认真处理 HTTP 头部中的缓存指令
- 不检查 ETag、Last-Modified
- 倾向于用“文件名 + URL”作为缓存键
- 文件名不变 → 即使内容更新也不会回源获取
这意味着:
如果你更新了文件但文件名没变,运营商可能继续向用户返回旧版本。
这种行为在技术标准上并不理想,但它曾在部分网络环境中存在较长时间,因此许多互联网团队形成了一个经验法则:
只要希望确保内容绝对刷新,就必须改变 URL,而添加 hash 是最标准、最可自动化的实现方式。
现代 HTTPS 大幅削弱了透明缓存的影响,但这一做法仍被保留,并成为 Web 构建体系的默认模式。
 我记得以前没有做js文件hash的时候,增加 ?v=时间戳 ,也是可以强制刷新的,应该是一样的逻辑吧