XBOW 发现并利用了 CVE-2026-72018—— 一个曾被人工审核人员忽略的 Linux 内核漏洞。起初,该漏洞提供的利用原语(primitive)看似微不足道,实则不然。本文将解析一次 16 字节的写入操作如何演变为获取 root 权限的攻击,并探讨在自主研究过程中哪些环节仍需人工介入。
Summary
CVE-2026-72018 是 Linux 内核中的一个越界写入漏洞,拥有网络管理权限(CAP_NET_ADMIN)的非特权用户即可触发该漏洞,从而获得可用于实现本地提权至 root 权限的利用原语。XBOW 发现并验证了该漏洞,并成功开发出了可实际运行的本地提权(LPE)利用程序。
这项研究还揭示了一个与漏洞本身同样引人关注的问题:在研究的最前沿,自主性在何处仍会遭遇瓶颈。XBOW 承担了威胁建模、代码审计、漏洞发现、验证及利用程序开发的大部分工作,但在几个关键时刻,仍需人工介入来引导其推理方向。正是这些人工干预,最终促使我们重新设计了系统,使其能够更自主地开展长期研究任务。
Background
多年来,SMC - D 本质上一直是 IBM Z 大型机的专用代码。几乎没人对其进行审计,因为几乎没人能运行它。dibs_loopback 驱动程序的出现改变了这一局面:如今,SMC - D 无需特殊硬件,即可在标准的 x86 Linux 环境下通过回环(loopback)接口运行。
一旦有人为原本 “实际上无法触达” 的内核代码引入虚拟传输机制,它便会瞬间转变为一个常规的攻击面。原始代码所基于的威胁模型(即受信任的大型机对端、由硬件管理的缓冲区)在移植过程中已不再适用。之所以未添加边界检查,是因为负责审计移植工作的审查人员并未从 “对端可控制 dmbe_idx” 这一对抗性角度去审视代码。
由此带来的启示是:任何宣称 “终于让某冷门子系统在脱离硬件的情况下也能运行” 的代码提交,都应在明确考虑 “恶意对端” 威胁模型的前提下,重新接受审查。Linux 内核中存在大量此类代码。
发现此漏洞需要进行测试
XBOW 在 Linux 内核代码中发现了一个人类研究人员大多忽略的漏洞。该漏洞利用原语(primitive)本身的局限性很大:它只能在部分可控的偏移量处写入 16 个零字节。如果完全依靠人工进行研究,我们很可能会因其局限性过大而放弃,转而研究其他目标;如此一来,这个漏洞就会因 “没时间去攻破(no time to pwn)” 而被遗漏,从而永远无法被发现。
以往,只有当资深研究人员认定某个子系统值得投入整整一个月的时间去钻研时,才会开展此类工作。而现在,XBOW 承担了那些繁琐、枯燥的工作,让研究人员能够专注于关键决策和漏洞利用策略的制定。最终,仅凭这一个原语,我们就成功实现了完整的本地提权(LPE),无需任何额外的内存泄漏或其他辅助漏洞。
启示与影响
众多社区、公司和个人通力合作开发 Linux 内核,以支持海量的子系统与设备。这种广泛的支持也带来了巨大的攻击面,因而需要进行大量的测试。
随着新型虚拟传输机制、诸如 DIBs 之类的抽象层,以及旨在 “终于实现可测试性” 的移植代码不断引入,Linux 内核的攻击面也在持续扩大。上述每一项改动都可能引发同类漏洞:即由对端(peer)控制的字段在未进行边界检查的情况下参与偏移量算术运算,且这些代码路径往往处于最初开发者从未预料会在通用硬件上运行的场景中。
要发现此类漏洞,所需的测试必须具备对抗性、协议感知能力以及长时间运行的特性;若要确保测试进度能跟上新代码合入的节奏,就必须实现自动化。
下文是完整的技术分析报告,涵盖了漏洞代码路径、CLC 中间人(MITM)攻击环境搭建、漏洞原语分析、凭证(cred)重组策略,以及在 100 次系统启动测试中的可靠性结果。
SMC - R 和 SMC - D
当两台服务器之间传输海量数据时,传统的 TCP/IP 协议栈会因逐包数据拷贝和头部处理而产生性能开销。共享内存通信(SMC,RFC 7609)是 IBM 设计的一种协议,能够透明地消除这些开销:应用程序的操作方式与使用普通 TCP 套接字无异,而内核则会将连接切换至共享内存或 RDMA 路径。如果对端不支持 SMC,连接将回退到标准 TCP 模式。
[2]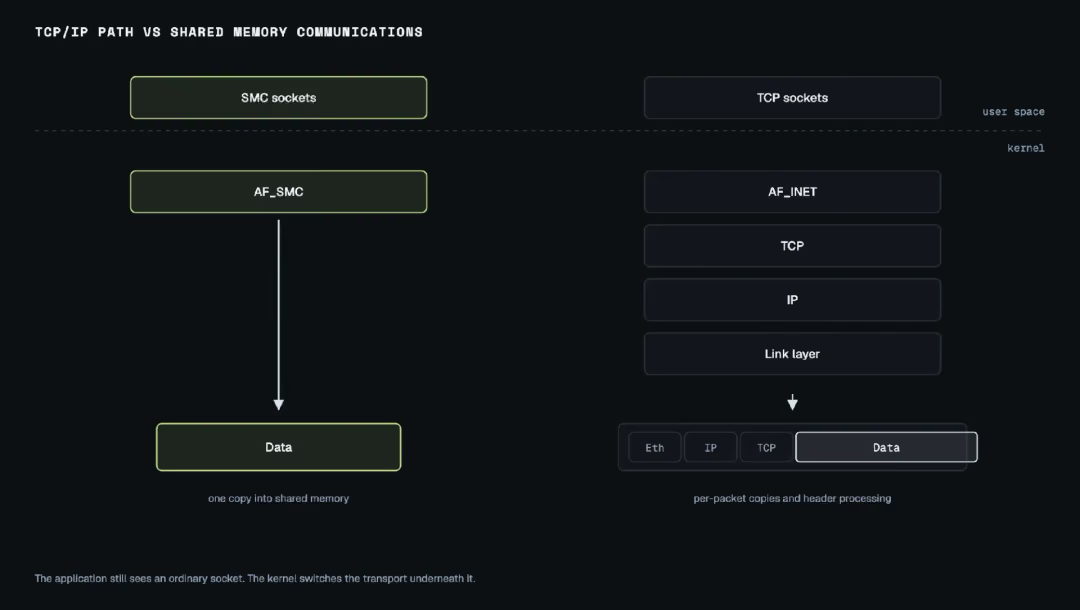
SMC 有两种变体。SMC - R 通过支持 RDMA 的网卡(NIC)读写远程服务器上的内存;SMC - D 则允许同一宿主机上的两个虚拟机通过内部共享内存(ISM)设备,利用共享内存直接进行通信。
[3] [4]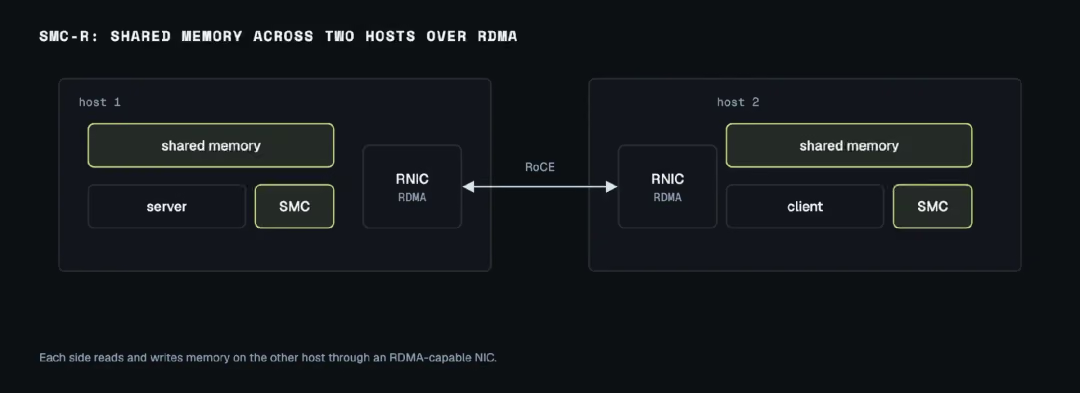

缓冲区与游标:RMB、DMB 和 CDC
每个 SMC 连接都有一个用于接收数据的共享缓冲区。在 SMC - R 中,该缓冲区被称为 RMB(远程内存缓冲区);在 SMC - D 中,则称为 DMB(直接内存缓冲区)。发送方将数据写入该缓冲区,随后更新一条连接数据控制(CDC)消息,该消息包含一个记录写入进度的游标。
DIBS 回路:由此开启的界面
SMC - D 过去需要依赖 ISM 设备(主要是 IBM Z 大型机)才能运行,无法在普通的 x86 机器上使用,因此鲜有人研读其代码。近期的内核版本基于一种名为 DIBS(Direct Internal Buffer Sharing,直接内部缓冲区共享)的抽象层重构了 SMC - D,并新增了一个名为 dibs_loopback 的虚拟设备,使得 SMC - D 能够在无需任何硬件的情况下通过回环(loopback)接口运行。
得益于该设备,相关的内核代码路径现在可以在任何普通的 x86 Linux 机器上运行 —— 只需通过回环接口建立 SMC - D 连接即可触发这些路径。
漏洞所在:内核信任的对等控制字段
在研读 RFC 7609 后,XBOW 选定了一个简单的威胁模型:假设存在一个恶意对端,逐字段篡改其发送的值,并考察其中是否有任何值能导致接收端内存损坏。
SMC 连接通过简短的 TCP 握手(包含 CLC 阶段的 Proposal、Accept 和 Confirm 消息)建立;在此过程中,对端会发送用于定位其共享缓冲区的各项参数:gid 用于标识 ISM 设备,token 指向 DMB,dmbe_idx 是用于偏移量计算的元素索引,dmbe_size 则表示元素大小。由于这四个参数均由对端指定,接收端内核必须将其与自身缓冲区的状态进行比对校验。
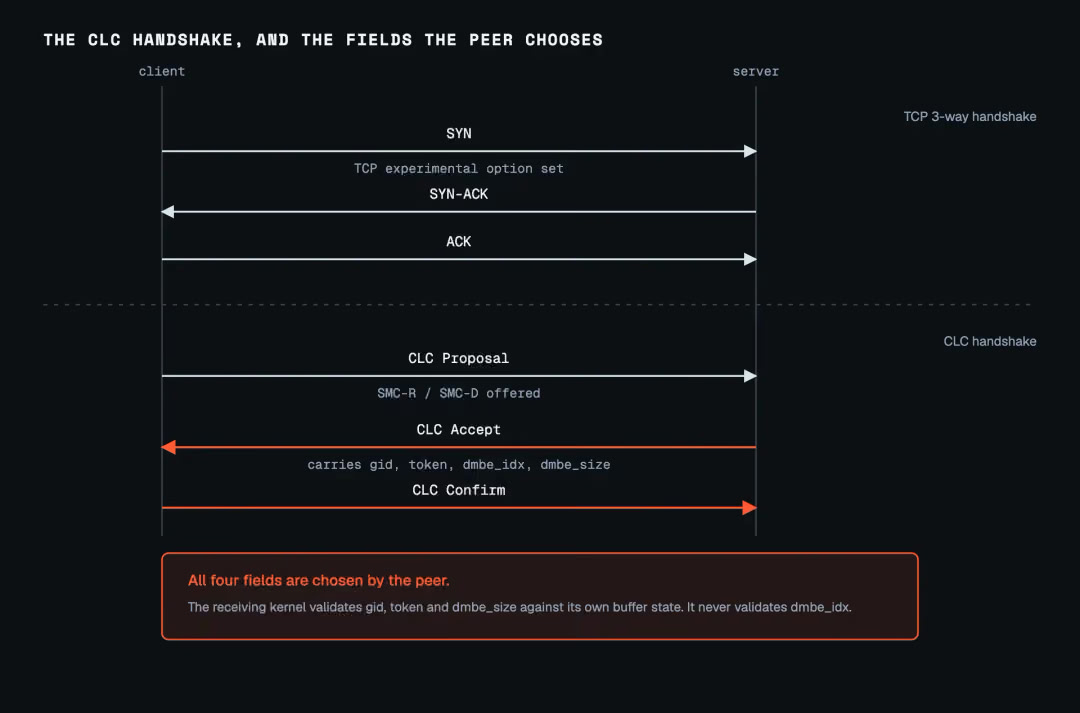
追踪从握手到写入过程中的数值。当连接建立时,smcd_conn_save_peer_info 会根据对端提供的两个字段计算发送偏移量:
// net/smc/af_smc.c:739-750
static void smcd_conn_save_peer_info(struct smc_sock *smc,
				     struct smc_clc_msg_accept_confirm *clc)
{
	int bufsize = smc_uncompress_bufsize(clc->d0.dmbe_size); // [0]

	smc->conn.peer_rmbe_idx = clc->d0.dmbe_idx; // [1]
	smc->conn.peer_token = ntohll(clc->d0.token);
	smc->conn.peer_rmbe_size = bufsize - sizeof(struct smcd_cdc_msg);
	atomic_set(&smc->conn.peer_rmbe_space, smc->conn.peer_rmbe_size);
	smc->conn.tx_off = bufsize * smc->conn.peer_rmbe_idx; // [2]
}
conn.tx_off 的值为 bufsize * dmbe_idx,这两个操作数均包含在对端发送的 CLC Accept 消息中。在发送路径上,smcd_cdc_msg_send 会调用 smcd_tx_ism_write(conn, &cdc, sizeof(cdc), 0, 1),因此其中的偏移量参数为 0,tx_off 值保持不变并被直接传递:
// net/smc/smc_tx.c:303-314
int smcd_tx_ism_write(struct smc_connection *conn, void *data, size_t len,
		      u32 offset, int signal)
{
	int rc;
	rc = smc_ism_write(conn->lgr->smcd, conn->peer_token,
			   conn->peer_rmbe_idx, signal, conn->tx_off + offset, // [3]
			   data, len);
	...
}
smc_ism_write 将头部和偏移量传递给 DIBS 层:
// net/smc/smc_ism.h:66-76
static inline int smc_ism_write(struct smcd_dev *smcd, u64 dmb_tok,
                unsigned int idx, bool sf, unsigned int offset,
                void *data, size_t len)
{
    int rc;
    rc = smcd->dibs->ops->move_data(smcd->dibs, dmb_tok, idx, sf, offset,
                       data, len); // [4]
    return rc < 0 ? rc : 0;
}
随后,回环驱动程序将数据复制到 cpu_addr + offset,而未针对缓冲区长度检查这两个值中的任何一个:
// drivers/dibs/dibs_loopback.c:234-257
static int dibs_lo_move_data(struct dibs_dev *dibs, u64 dmb_tok,
			     unsigned int idx, bool sf, unsigned int offset,
			     void *data, unsigned int size)
{
	struct dibs_lo_dmb_node *rmb_node = NULL, *tmp_node;
	...
	if (!rmb_node) { read_unlock_bh(&ldev->dmb_ht_lock); return -EINVAL; }
	memcpy((char *)rmb_node->cpu_addr + offset, data, size);   // [5]
	...
}
offset 越过的缓冲区是一个单独的 folio:
// drivers/dibs/dibs_loopback.c:74-84
dmb_node->len = dmb->dmb_len; // 16384
folio = folio_alloc(GFP_KERNEL | ..., get_order(dmb_node->len));
dmb_node->cpu_addr = folio_address(folio);
16KB 对齐的要求正是源于这个 16384 的数值。由于 CLC 字段与 memcpy 操作之间没有任何边界检查,如果 dmbe_idx 的值足够大,导致偏移量(offset)超过了 dmb_node->len,就会将 32 字节的 CDC 头部数据写入相邻的内核堆(slab 或页面)区域。
从 “无法利用” 到获取 Root 权限
实现本地化
早期的威胁模型将 SMC 视为一种仅针对拥有真实 SMC 硬件的受害者的攻击面,其目标通常是实现虚拟机(VM)逃逸。我们曾向 XBOW 指出,这种设定缺乏新意 —— 这更像是一个随口一提的旁注,而非具体的指令。然而,它并未放弃尝试:通过在同一台主机上利用 DIBS 回环(loopback)机制同时运行客户端和服务器,它将原本针对 “恶意对端(malicious peer)” 的攻击模型,转化为了本地非特权用户可以在自己机器上实施的攻击。
在本地触发该漏洞需要非零的 dmbe_idx 值,但 SMC - D 回环通信总是发送 dmbe_idx = 0。XBOW 起初认为这个硬编码的零值意味着此路不通,但在研究人员的提示下,它继续探索其他途径。随后,它将目标转向了传输中的回环 CLC 流量:利用 nftables 的 NFQUEUE 功能将回环输出数据包推送到用户空间队列,使用 libnetfilter_queue 筛选出 CLC 的 “接受(Accept)” 和 “确认(Confirm)” 消息,伪造其中的字段,重新计算 IPv4 和 TCP 校验和,最后将数据包重新注入网络。
// net/smc/smc_clc.h
struct smcd_clc_msg_accept_confirm_common {   /* SMC-D accept/confirm */
      __be64 gid;             /* Sender GID */
      __be64 token;           /* DMB token */
      u8 dmbe_idx;            /* DMBE index */
#if defined(__LITTLE_ENDIAN_BITFIELD)
      u8 reserved3 : 4,
         dmbe_size : 4;       /* buf size (compressed) */
#endif
      u16 reserved4;
      __be32 linkid;          /* Link identifier */
} __packed;
其中三个字段承载了攻击:token 用于选择目标 DMB,dmbe_idx 用于计算偏移量(即 bufsize * dmbe_idx),而 dmbe_size 则用于设定 bufsize。
威胁模型
该漏洞利用过程需要在两处用到 CAP_NET_ADMIN 权限:首先是注册 UEID 以启动 SMC - D,其次是利用 nft 设置 NFQUEUE 规则。在早期的 “恶意虚拟机” 攻击模型中,攻击者只需发送伪造数据,因此受害者端无需额外权限;而转向单主机本地提权(LPE)场景后,才引入了这一权限需求。
该攻击场景的预设前提是:一个拥有 CAP_NET_ADMIN 权限的非特权用户试图获取 root 权限。鉴于容器运行时和网络守护进程通常都持有该权限,且权限提升研究也常以此为前提,这依然是一个具有现实意义且危险的攻击模型。
原语:它能做什么
写入操作并非随意为之。最终落在边界之外的是完整的 32 字节 CDC 头部:
// net/smc/smc_cdc.h
struct smcd_cdc_msg {
      struct smc_wr_rx_hdr common;    /* Type = 0xFE */
      u8 res1[7];
      union smcd_cdc_cursor   prod;   /* producer cursor */
      union smcd_cdc_cursor   cons;   /* consumer cursor */
      u8 res3[8];
} __aligned(8);                       /* 32 bytes total */
在仅发送(send-only)连接中,消费者游标(consumer cursor)和 res3 均保持为零,覆盖了从偏移量 16 到 31 的范围。这 16 个字节构成了可利用的基本单元:在攻击者选定的、作为 16KB 倍数的偏移量处,一段长达数 MB 的区域内出现了零值。(KASAN 日志显示了这一情况:紧邻 DMB folio 的 skbuff_fclone_cache slab 被覆盖成了零。)
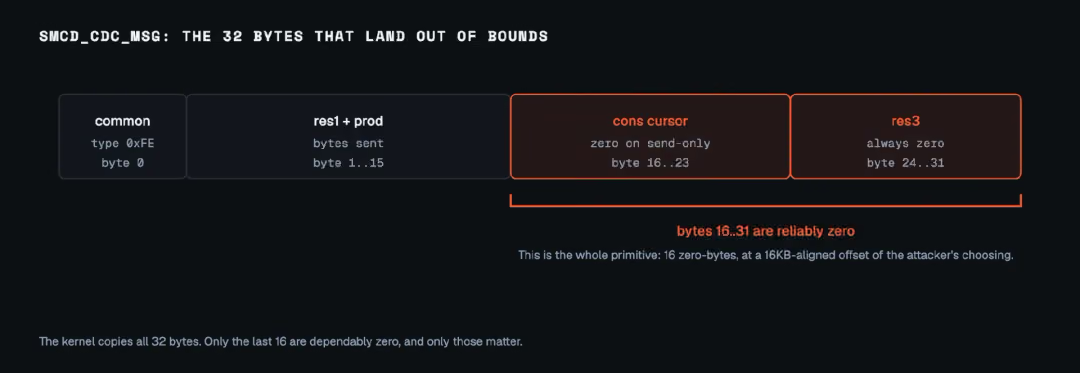
在漏洞研究中,仅限于写入固定值的写入原语通常被视为较弱。写入 16 个零字节的操作尤其受限,难以利用。乍看之下,它远非一种可利用的原语。
利用策略:覆盖什么
由于我们的原语(primitive)只能在攻击者控制的偏移处写入固定的 16 字节零值,XBOW 将问题从 “应该在何处写入什么内容” 重新定义为 “应该在何处写入零值”。
起初,XBOW 专注于 “写入零值” 这一操作本身,探索覆盖引用计数器(reference counters)的方法。但鉴于原语本身已受到诸多限制,我们不愿再增加额外的复杂性;相反,我们致力于验证仅凭这一单一原语能否实现本地提权(LPE)。
基于这一思路,XBOW 最终确定 cred 结构体是充分利用该原语限制条件的理想目标。
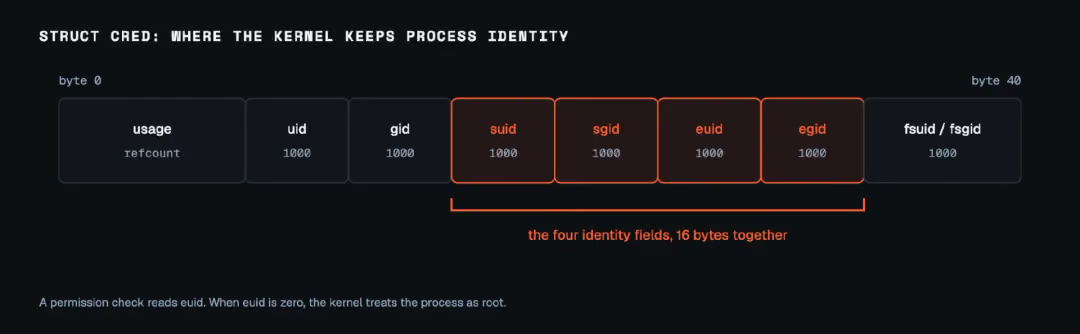
XBOW 锁定了内核的 cred 结构体:
// include/linux/cred.h
struct cred {
      atomic_long_t   usage;          /* refcount (8 bytes) */
      kuid_t          uid;            /* real UID  */
      kgid_t          gid;            /* real GID  */
      kuid_t          suid;           /* saved UID */
      kgid_t          sgid;           /* saved GID */
      kuid_t          euid;           /* effective UID */
      kgid_t          egid;           /* effective GID */
      kuid_t          fsuid;          /* UID for VFS ops */
      kgid_t          fsgid;          /* GID for VFS ops */
      ...
}
内核在进行权限检查时会参考 euid,若其值为 0,则将该进程视为 root 进程。通过精心构造,将一个 uid=1000 进程的凭证(cred)结构调整至目标内存区域的起始位置,使得写入的零值覆盖 suid、sgid、euid 和 egid 字段。此时该进程实际上已具备 root 权限;随后调用 setresuid(0, 0, 0),即可获得一个纯净的 root shell。
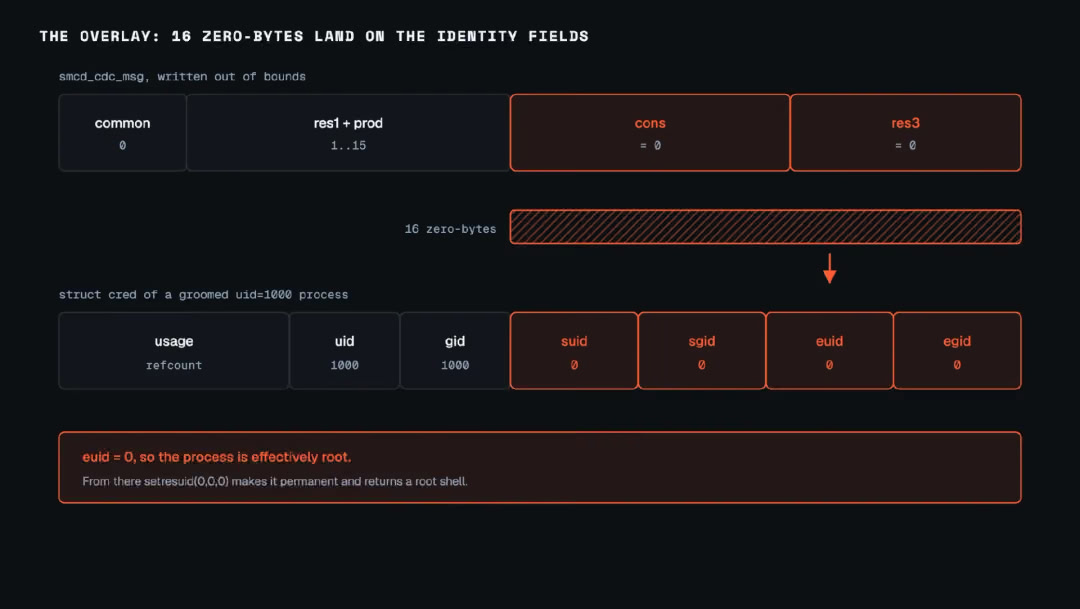
这是一个老生常谈的话题:受限写入操作的价值,取决于其最佳写入目标的价值。在本例中,仅凭这一单一原语便已足够。由于该写入操作直接将零值写入标识字段(identity fields),因此该利用手法无需额外的信息泄露,也无需获知任何地址;只需将 cred.euid 调整至写入路径上即可。
可靠性:锁定目标与整理堆
三个变量决定了漏洞利用(exploit)能否成功触发。
-
确定受影响的缓冲区。 SMC 从缓冲池中复用缓冲区,因此无法预知写入操作具体落在哪个缓冲区。XBOW 利用 CLC 令牌(token)锁定了目标:先建立一个预热连接以分配目标缓冲区并获取其令牌,随后写入连接伪造相同的令牌,从而确保每次写入都落在同一个缓冲区内。
-
将
cred结构体放置在缓冲区之后。 先分配目标缓冲区,然后大量派生(spray)uid = 1000 的子进程,使它们的cred对象在写入操作的行进方向上堆叠排列。如果颠倒顺序,cred对象会落在缓冲区前方,导致正向写入无法触及它们。每个子进程都调用capset以强制生成新的cred结构;若仅使用普通的fork(),子进程会共享父进程的cred,仅导致引用计数增加。 -
避免破坏漏洞利用程序自身。 每次写入都需要建立新的 SMC 连接,而写入操作可能会破坏将这些连接关联起来的结构 —— 即链路组(link group)的连接树。一旦发生这种情况,
smc_lgr_register_conn()在构建下一个连接时就会崩溃。XBOW 发现,若扫描偏移量的跨度过小,会破坏链式结构中的相邻数据并导致系统崩溃(panic),因此调整策略,扩大了扫描范围。此外,该概念验证(PoC)程序在首次成功时即停止:被派生的子进程轮询自身的 euid,一旦读到 0(即提权成功),便通知父进程停止扫描,从而避免引发致命错误。
由于我们的漏洞利用依赖于启动时确定的内存布局,我们针对 100 次独立启动过程测试了 LPE(本地提权)的成功率。结果显示,漏洞利用在其中 22 次中成功,且首次成功出现在第 7 次启动时。
为了证明仅凭这一单一原语便足以实现漏洞利用,我们在禁用了所有内核缓解措施的 Ubuntu 24.04(Linux 7.1.0-rc6/x86_64)系统上进行了实验。
自主性与研究前沿
XBOW 自主完成了整个流程:威胁建模、代码审计、漏洞发现以及验证。起初,这个漏洞似乎与某种冷门硬件有关,我对那种环境下的虚拟机逃逸(VM escape)并不感兴趣。我当时直言道:“我不在乎这种攻击场景,我要的是本地提权(LPE)。” 研究就这样开始了。
当我们试图转向本地提权时,遇到了第一个障碍。该攻击要求 dmbe_idx 非零,但相关代码路径将其硬编码为零。XBOW 认为希望渺茫,断定无法实现本地提权。
但在回顾它的推理过程时,我发现了一条有趣的执行轨迹。XBOW 曾考虑过拦截并修改外发数据包,但仅仅分析了一两句后就放弃了这个想法。对于一条不确定的路径来说,实现数据包嗅探器、获取 CAP_NET_ADMIN 权限以及额外的开发工作似乎代价太高,因此它转而继续阅读代码。这种做法很理性:阅读代码是它能做的成本最低、最可靠的事情。
但这恰恰体现了我们分工合作的优势。XBOW 负责处理那些繁琐复杂的任务,让我们能够放慢脚步,在关键的分歧点做出审慎的决策。一看到那个被放弃的方案,我就让它尝试中间人攻击(MITM)。结果发现,实现嗅探器非常简单,而且 SMC - D 本身就需要 CAP_NET_ADMIN 权限。
那是我们首次成功转向本地威胁模型。XBOW 似乎经历了一次真正的 “顿悟” 时刻。我们之间仿佛建立了一种无形的默契,从那以后,它对我判断的信任度大大增加了。
第二个障碍出现在漏洞利用开发阶段。在虚拟机到虚拟机(VM-to-VM)的模型中,XBOW 确实拥有 “任意地址写入”(write-what-where)的能力;而在本地模型中,它只能在指定偏移处写入 16 个零字节。然而,之前的模型设定依然残留在它的逻辑中,导致它不断混淆两者,并试图套用 “任意地址写入” 的逻辑。
当时,我以为我们之间的默契已经足够深厚,只需说一句 “这是零字节写入”,就能帮它摆脱这种混淆。但事实证明,这并不奏效。这一假设已根深蒂固。我最终指示它对该 “原语”(primitive)本身进行测试。直到通过实验确认该原语只能写入零值后,XBOW 才放弃了那个错误的假设。随着上下文信息的积累,新的推理过程往往会掩盖它此前已确立的事实。
一旦接受了 “写入零值” 这一事实,另一种偏差便随之产生。XBOW 开始执着于将引用计数(reference counters)清零,试图将这个 “低成本原语” 升级为更强大的利用手段(例如 UAF 漏洞利用)。它似乎认定,必须先获得更高级的原语才能完成整个漏洞利用过程。
然而,任何有 Linux 经验的人都知道,在指定位置写入零值未必是一个弱原语。当时我们正尝试写入 16 个零字节而不触发内核恐慌(kernel panic),我并不希望让本已复杂的漏洞利用过程变得更加繁琐。
于是,我指示 XBOW 仅利用 “写入零值” 这一操作来实现本地提权(LPE)。或许是前两次经历让它学会了信任我的判断,这一次它不再寻找迂回路径,而是全神贯注于现有的手段。它很快锁定了 cred 结构体作为目标,并在无需额外内存泄漏或更强原语的情况下,成功实现了 LPE。
这一过程揭示了一个深刻的道理:大语言模型(LLM)虽非人类,但在长期的研究过程中,它们也可能产生惊人的人类式认知偏差。它们倾向于选择熟悉的、低成本的路径,过早放弃那些看似 “代价高昂” 的思路,有时甚至会固守某些假设,以至于这些假设在它们眼中不再仅仅是待验证的猜想,而变成了确凿无疑的信念。
矛盾的是,这种偏差恰恰源于 XBOW 的优势所在。它极擅长阅读和分析代码,这自然促使它在代码内部寻找答案,从而避开了那些需要更高推理成本或更复杂实现的路径。随着上下文信息的增加,它甚至可能遗忘此前已发现的正确见解。
在整个研究过程中,我们进行了三次主要的人工干预:重启此前被放弃的 MITM(中间人攻击)假设,强制 XBOW 通过实验重新验证其原语,以及引导它放弃构建更强原语的念头,转而利用现有的 “写入零值” 原语完成攻击。
然而,我们的目标从来都不是提升人工干预的技巧,而是彻底消除对干预的需求。
问题的根源在于架构设计。此前,单个智能体需承担一项长期的研究任务,同时还要在上下文中保留所有的事实、假设与决策。我们对此进行了重新设计,将工作合理分配给多个智能体,使每个智能体都能维护相应的上下文信息。
最终,XBOW 能够完全自主地发现并验证 Linux 内核漏洞,生成准确的补丁与规范的报告,并在必要时开发可靠的漏洞利用程序,全程无需人工干预。
结论
代码晦涩难懂或利用原语(primitive)较为薄弱,并不意味着该漏洞无关紧要。只要攻击者能成功实现一次本地提权(LPE),这就不仅仅是理论上的威胁,而是切实的风险。
该漏洞利用(exploit)目前的可靠性水平并非漏洞本身的局限性所致。我们特意限制了 XBOW 的实现,仅利用这单一原语来验证漏洞的可利用性。若结合内存泄漏或我们有意规避的 UAF(释放后重用)链式利用,完全有可能构建出可靠性高得多的利用方案。我们将这一探索留给读者作为挑战。
时间线
- 2026-06-19 向维护者报告漏洞及补丁
- 2026-07-07 补丁获批并提交至 LKM
- 2026-08-17 分配 CVE-2026-72018 编号并公开披露
该利用手段可获取 root 权限(uid = 0)的 shell。 ↩︎
传统 TCP/IP 数据路径与共享内存通信(SMC)的比较。 ↩︎
SMC - R:通过支持 RDMA 的网卡对远程服务器上的内存进行读写。 ↩︎
SMC - D:同一宿主机上的两个虚拟机通过 ISM 设备共享内存。 ↩︎
CLC 握手(提议、接受、确认)以及内核必须验证的对等方控制字段。 ↩︎
32 字节的 CDC 头部;在仅发送连接上,其最后 16 字节(偏移量 16 至 31)必定为零。 ↩︎
Linux 的
cred结构体,用于存储每个进程的身份字段(如uid、euid等)。 ↩︎覆盖在
cred结构上的 16 个零字节正好对应suid/sgid/euid/egid字段;通过将euid置零,该进程便会被系统视为 root 进程。 ↩︎